AA-AgentPerf-Local: бенчмарк автономных агентов на ноутбуках и рабочих станциях
Тестирование автономных кодинг- и аналитических агентов на потребительском «железе»: Apple Silicon, RTX и Ryzen AI.
Анонсируем AA-AgentPerf-Local, наш инструмент тестирования логических выводов с открытым исходным кодом для локальных моделей ИИ. Проверьте, насколько быстро агентный ИИ может работать на вашем ноутбуке или рабочей станции, и просмотрите наш список обслуживающих конфигураций, чтобы спланировать следующую настройку агента.
Ключевые моменты
➤ Мы предлагаем открытый исходный код AA-AgentPerf-Local, который воспроизводит реальные траектории движения агентов на оборудовании ноутбука и рабочей станции для проверки производительности логических выводов.
➤ Мы публикуем предварительные результаты для NVIDIA DGX Spark, NVIDIA GeForce RTX 5090, AMD Ryzen AI Halo и MacBook Pro M5 Pro.
AA-AgentPerf-Local воспроизводит реальные сеансы агента. Наша рабочая нагрузка по умолчанию — 8 записанных агентских задач, охватывающих 168 оборотов модели. Каждый запрос содержит полный диалог, как это сделал бы настоящий агент, поэтому контекст увеличивается до ~ 56 тыс. токенов. Каждый ход генерирует ровно записанное количество жетонов, поэтому все системы выполняют одинаковую работу. Выполнение инструмента по умолчанию пропускается, чтобы изолировать скорость вывода, но при тестировании собственной системы вы также можете воспроизвести реальные записанные задержки инструмента или запустить вызовы инструмента в реальном времени на своем процессоре.
При запуске мы концентрируемся на производительности, которую может достичь один агент, если он сможет использовать всю систему; мы планируем со временем расширить этот охват, чтобы охватить мультиагентные системы и сценарии, в которых агент должен работать наряду с другими обычными процессами.
Первоначальный набор оборудования, представленный на нашей официальной странице: NVIDIA DGX Spark (128 ГБ), AMD Ryzen AI Halo (128 ГБ), MacBook Pro M5 Pro (64 ГБ) и NVIDIA GeForce RTX 5090 (32 ГБ). Они были выбраны с учетом различных платформ (CUDA, ROCm, Vulkan, Metal), объема памяти и пропускной способности. Мы будем расширять предлагаемое оборудование, включив в него ноутбуки x86 (и другие), графические карты, ориентированные на искусственный интеллект, такие как RTX PRO 6000 Blackwell, и многое другое, чтобы предоставить потребителям всестороннее представление о производительности различных типов оборудования.
На запуске представлены следующие модели: Qwen3.5-9B, Qwen3.8-27B, Qwen3.6-35B-A3B и Ling 3.0 Flash (активная 124B/5B). Эти первоначальные модели охватывают ряд требований к памяти и архитектур с высокой плотностью/MoE, и каждая из них тестируется на 4-битном квантовании, чтобы отразить реалистичные условия обслуживания. Основной набор моделей, которые мы представляем, со временем будет меняться по мере выпуска новых моделей с открытыми весами. Помимо представленных моделей, AA-AgentPerf-Local может оценивать производительность любого OpenAI-совместимого сервера вывода, который запускает пользователь, а это означает, что любую модель и конфигурацию можно протестировать локально.
Первоначальные результаты
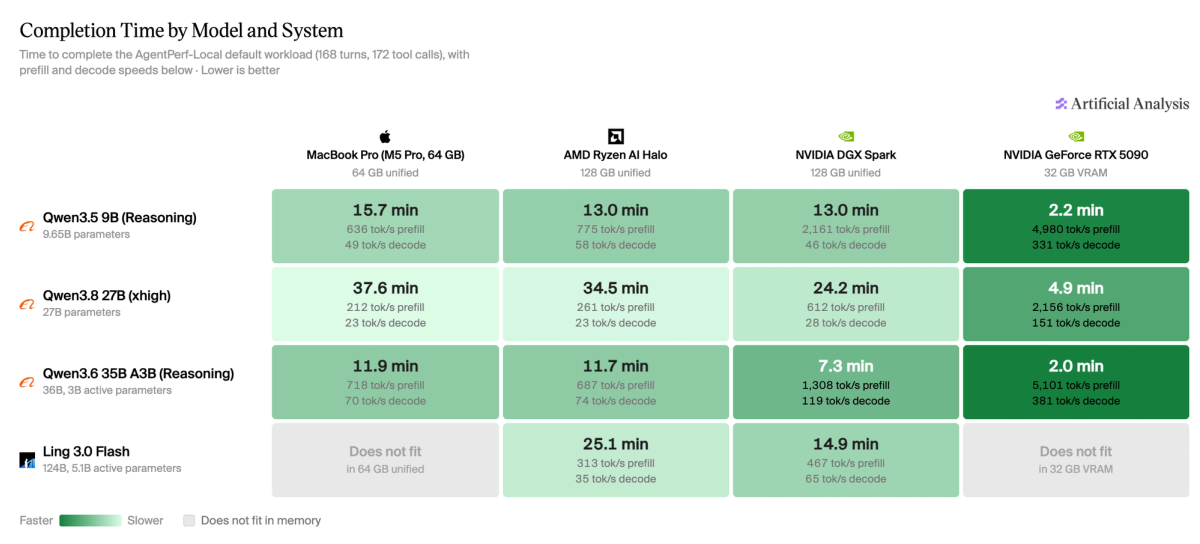
➤ Время завершения наиболее точно соответствует количеству активных параметров каждой модели: Qwen3.6-35B-A3B (3B активен) была самой быстрой моделью в каждой системе, например В 2,5-3,3 раза быстрее плотного Qwen3.8-27B. Однако активные параметры — это еще не все: Ling 3.0 Flash (всего 124 байт, 5 байт активных) по-прежнему отстает от Qwen3.5-9B (почти вдвое больше количества активных параметров) на всем оборудовании, которое может его поддерживать.
➤ GeForce RTX 5090 оказалась самой быстрой системой среди всех моделей, вмещающих 32 ГБ, при этом время выполнения было в 3,5 раза быстрее, чем у других систем. На однопользовательское декодирование сильно влияет пропускная способность памяти: у GeForce RTX 5090 она составляет 1792 ГБ/с против 256–307 ГБ/с для систем с унифицированной памятью.
➤ DGX Spark и Ryzen AI Halo в целом являются схожими системами, с одинаковым объемом унифицированной памяти, сопоставимой пропускной способностью памяти и одинаковой стартовой розничной ценой в 4000 долларов США. На нашей траектории по умолчанию DGX Spark был в 1,4–1,7 раза быстрее на трех из четырех моделей, а Ryzen AI Halo сравнял его с Qwen3.5–9B. Разрыв намного больше, чем разница в пропускной способности в 7 % — у Spark более мощные вычисления низкой точности, чем у Ryzen AI Halo, что позволяет ему выполнять предварительное заполнение быстрее, а его более зрелое программное обеспечение CUDA, вероятно, играет роль в обеспечении лучшего MoE и производительности спекулятивного декодирования.
➤ MacBook Pro (M5 Pro, 64 ГБ, 20-ядерный графический процессор) — единственный протестированный на данный момент ноутбук, показавший конкурентоспособные результаты, отставая от Ryzen AI Halo на 2–9 % на Qwen3.6-35B-A3B и Qwen3.8-27B (хотя на Qwen3.5-9B он был на 21 % медленнее). Он имеет наибольшую пропускную способность памяти среди трех систем с унифицированной памятью (307 ГБ/с), а его текущая цена в 3700 долларов — самая низкая из протестированных на данный момент систем. Его результаты, вероятно, сдерживаются зрелостью программного обеспечения и вычислительными ресурсами, доступными для предварительного заполнения.
➤ Несмотря на то, что агентские траектории обслуживают 73–93% токенов подсказок из кэша KV, простое чтение новых входных данных каждого хода (во время предварительного заполнения) занимало значительную часть времени сквозного завершения, например 22-41% для Qwen3.8-27B. Это особенно повлияло на системы с низкими вычислительными FLOP/с относительно пропускной способности их памяти, такие как Ryzen AI Halo и, возможно, MacBook Pro (уровень FLOP/s MacBook не опубликован).
➤ Спекулятивное декодирование было реализовано во всех наиболее успешных конфигурациях, например. повышение скорости декодирования Qwen3.8-27B примерно на 30–120 % выше предела ограничения полосы пропускания.
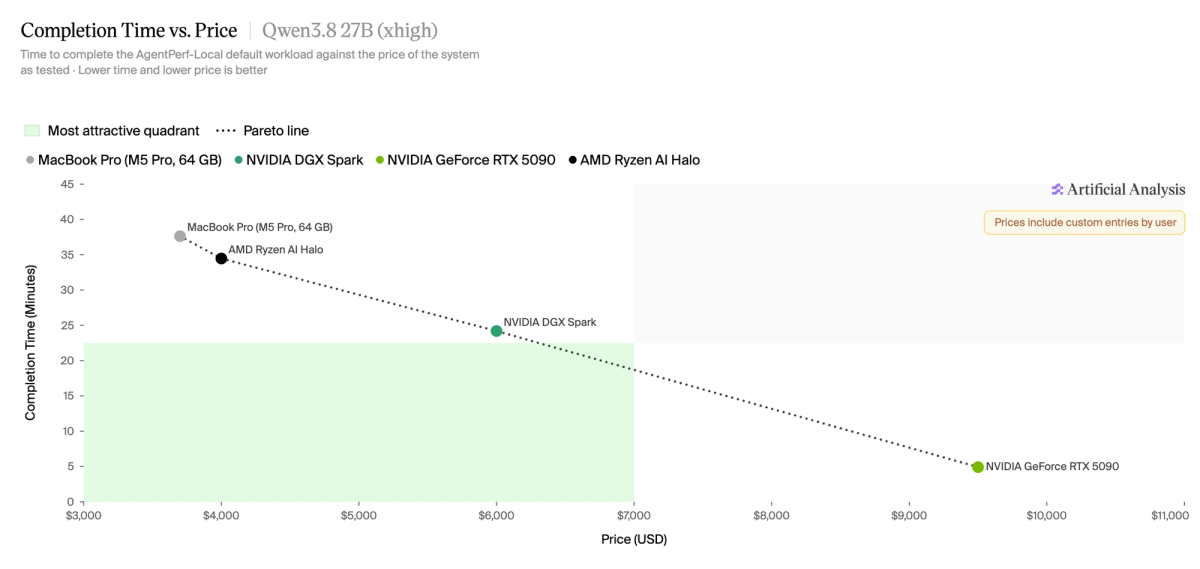
Цены на большинство аппаратных средств значительно завышены по сравнению с рекомендуемой розничной ценой на их запуск. По текущим рыночным ценам каждый из четырех первоначальных типов оборудования увеличивается в цене по мере уменьшения времени комплексного завершения, при этом MacBook Pro (M5 Pro, 64 ГБ) является самым дешевым на данный момент, а система GeForce RTX 5090 — безусловно, самой дорогой. По умолчанию на нашей странице указана рекомендуемая розничная цена, но разрешен ввод индивидуальной цены. Ниже мы показываем нашу лучшую оценку текущих рыночных цен.
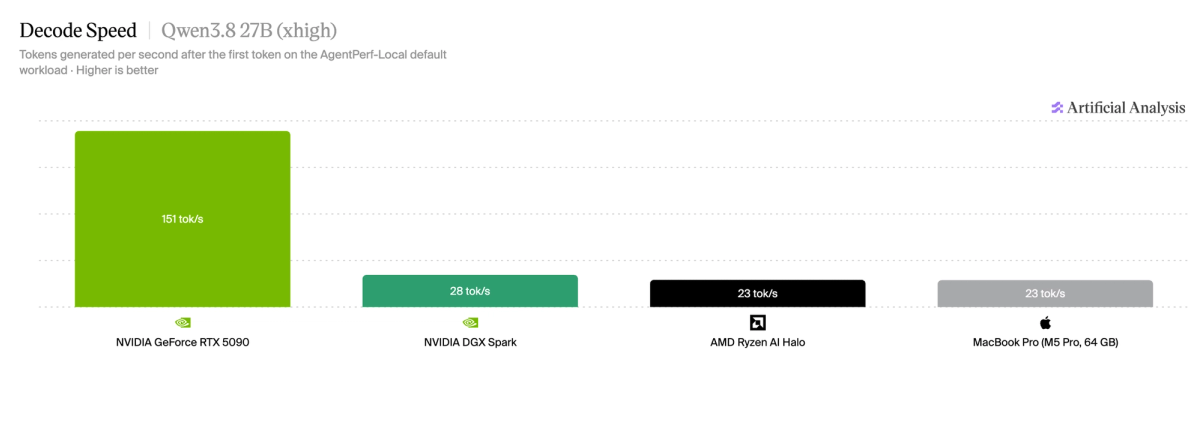
Скорость декодирования для Qwen3.8-27B была в целом одинаковой на трех устройствах с унифицированной памятью, которые имеют одинаковую пропускную способность памяти — 256–307 ГБ/с. GeForce RTX 5090 показала скорость декодирования в 5 раз выше, чем эта, в основном благодаря более быстрой памяти в 5 раз и пропускной способности 1792 ГБ/с.
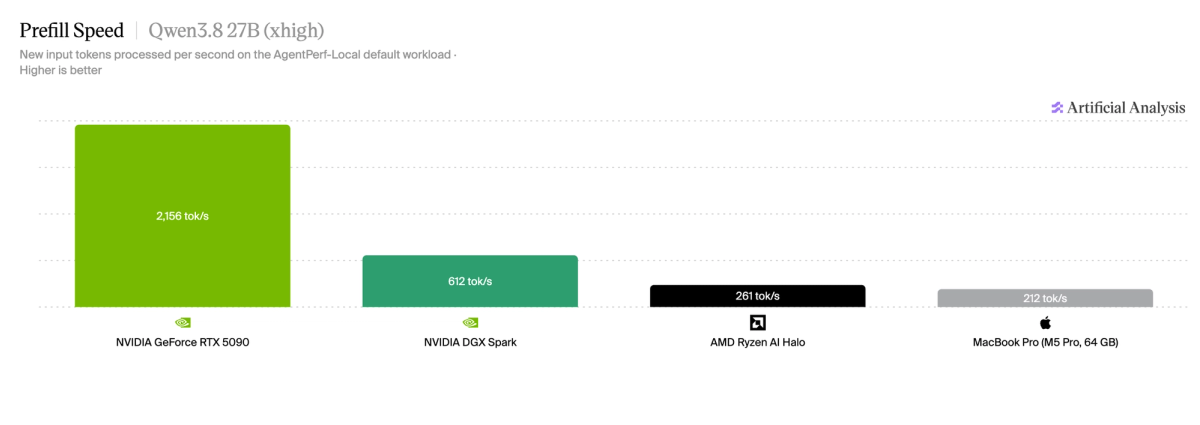
Скорость предварительного заполнения для Qwen3.8-27B следовала той же схеме при декодировании, но непропорционально высокое соотношение вычислений и пропускной способности DGX Spark проявилось в более высоких скоростях контекстного чтения. Это важно для наших агентных траекторий, поскольку даже при том, что большая часть каждого приглашения обслуживается из кеша (~93% в llama.cpp), каждый сеанс по-прежнему имеет ~196 тыс. новых входных токенов против ~31 тыс. выходных токенов. Когда инструмент возвращает большой файл, агент может сделать паузу до 24 секунд на Halo и 39 секунд на MacBook перед ответом по сравнению с примерно 2 секундами на GeForce RTX 5090.
AA-AgentPerf-Local и страница «Ноутбуки и рабочие станции» будут часто обновляться по мере появления соответствующего нового оборудования и программного обеспечения. Мы планируем реализовать ряд дополнительных функций, которые помогут пользователям оптимально использовать локальный ИИ
➤ Более широкий ассортимент популярного оборудования и моделей
➤ Более полный репозиторий конфигураций для локального развертывания ИИ.
➤ Дополнительные пользовательские платформы вывода, такие как Inco Splash, которая в настоящее время тестируется.
➤ Многоагентные сценарии
Посмотреть первоначальные результаты можно здесь: а каждую конфигурацию обслуживания — здесь