Статьи и независимые бенчмарки нейросетей
Свежие релизы моделей, аппаратные тесты GPU, глубокие замеры рассуждений и понятные руководства без заумного жаргона.

Reflection выпустила Beam: первый релиз новой открытой модели
Первая модель компании Reflection набрала 30 баллов в Индексе интеллекта Artificial Analysis, заняв 2-е место среди открытых моделей США.
Читать подробнее →Как выбрать нейросеть под задачу: пять шагов без жаргона
Простая инструкция: от описания задачи до проверки двух-трёх моделей на своих примерах. Без формул и терминов.
Читать подробнее →
Первые результаты AA-AgentPerf для суперкомпьютера NVIDIA Vera Rubin NVL72
NVIDIA Vera Rubin NVL72 обеспечивает до ~5.7x суммарной пропускной способности на мегаватт по сравнению с GB300 NVL72 в тестах AA-AgentPerf.
Читать подробнее →
Первые тесты AA-AgentPerf-Local на ноутбуке с NVIDIA RTX Spark N1X
Ноутбук с NVIDIA RTX Spark N1X завершил локальную нагрузку на Qwen3.8 27B за 18.7 минут при рекордной энергоэффективности.
Читать подробнее →
NVIDIA выпустила Nemotron 3.5 Super VL и Nemotron 3.5 Bolt 74B A9B
Nemotron 3.5 Super VL стала ведущей открытой моделью США с 26 баллами в Индексе интеллекта Artificial Analysis.
Читать подробнее →Что такое токены и почему русский текст обходится дороже
Объясняем, за что на самом деле платят, когда пользуются нейросетью по API, и как прикинуть объём без подсчёта токенов.
Читать подробнее →
Эра воплощённого ИИ: анонс бенчмарка AA-Robotics v0.1
Запуск превью AA-Robotics v0.1: измерение производительности фронтирных языковых моделей в управлении роботами и манипуляциях.
Читать подробнее →Сколько стоит нейросеть для бизнеса: разбираем на примерах
Чат поддержки, описания товаров, проверка договоров: от чего зависит счёт и почему разница между моделями бывает стократной.
Читать подробнее →
Индекс принятия решений Artificial Analysis Decision Index v1.0
Новый бенчмарк для моделей принятия решений (decision models), способных выдавать структурированные оценки вероятностей и рисков.
Читать подробнее →Кэш: как платить за повторяющийся текст в разы меньше
Если в каждом запросе повторяются одни и те же инструкции или база знаний, большую часть входа можно оплачивать со скидкой.
Читать подробнее →
Анонс AA-3D: бенчмарк для ИИ-моделей создания интерактивного 3D
Новый тест способности нейросетей генерировать интерактивные 3D-сцены и миры со слепой экспертной оценкой.
Читать подробнее →
FrontierCode на Artificial Analysis: способен ли ИИ писать код для продакшна?
Тестирование Cognition FrontierCode 1.1: проверяем, пишут ли модели код такого качества, который принимают мейнтейнеры реальных open-source репозиториев.
Читать подробнее →
Muse Wonder и Muse Wonder Full: мощный скачок интеллекта у новых моделей Meta
Meta представила Muse Wonder и Wonder Full, показав заметный прогресс по сравнению с линейкой Llama и набрав 42 и 48 баллов в Индексе интеллекта.
Читать подробнее →Открытые модели или API: что выгоднее
Когда имеет смысл запускать модель на своём сервере, а когда проще и дешевле платить за запросы.
Читать подробнее →Как читать рейтинги нейросетей и не обмануться
Что на самом деле показывают тесты и индексы, почему разница в пару баллов ничего не значит и на что смотреть кроме места в рейтинге.
Читать подробнее →Думающие модели: когда стоит платить за размышления
Модели с режимом рассуждений точнее на сложных задачах, но медленнее и дороже. Разбираем, где это оправдано.
Читать подробнее →
Harvey LAB-AA v1.1: проверка галлюцинаций в юридических задачах агентов
Обновление юридического бенчмарка Harvey LAB-AA: добавлен строгий аудит фактологических ошибок и метрика All-Pass Rate.
Читать подробнее →
Модели с доверенным доступом в Индексе кибербезопасности Artificial Analysis
Модель GPT-6 Sol (Daybreak Blue) возглавила Cyber Index: сравнительный анализ кибербезопасности и тестирования уязвимостей.
Читать подробнее →
Anthropic выпустила Claude Haiku 5.5: скачок скорости и интеллекта
Claude Haiku 5.5 набрала 43 балла в Индексе интеллекта (+26 пунктов за год), сохранив сверхбыстрый отклик и низкую цену.
Читать подробнее →
Mistral выпустила Mistral Large 4: сильнейший ИИ за пределами США и Китая
Французская Mistral AI представила Mistral Large 4, установив европейский рекорд в мировом Индексе интеллекта.
Читать подробнее →
Корейская Upstage выпустила Solar Mini 4: компактный рекордсмен скорости
Компактная архитектура Solar Mini 4 демонстрирует впечатляющие результаты рассуждений при минимальном потреблении памяти.
Читать подробнее →
Gemini 4 Argon: Google возвращается в топ-3 мировых лабораторий по интеллекту
Флагманская Gemini 4 Argon набрала рекордные баллы в рассуждениях, кодинге и мультимодальном анализе длинного контекста.
Читать подробнее →
AA-AgentPerf-Local: бенчмарк автономных агентов на ноутбуках и рабочих станциях
Тестирование автономных кодинг- и аналитических агентов на потребительском «железе»: Apple Silicon, RTX и Ryzen AI.
Читать подробнее →
GPT-6.1 Sol сменяет GPT-6 Sol всего за 7 дней с интеллектом уровня Astra
OpenAI молниеносно обновила линейку: GPT-6.1 Sol приближается по уровню интеллекта к Astra при значительно меньшей задержке.
Читать подробнее →
Анонс Альянса кибер-индекса Artificial Analysis Cyber Index Alliance
Объединение ведущих лабораторий безопасности для независимой оценки устойчивости ИИ-моделей к эксплойтам и атакам.
Читать подробнее →
Claude Sonnet 5.5 занял 2-е место в Индексе интеллекта Artificial Analysis
Sonnet 5.5 сочетает передовой кодинг и агентские рассуждения с высокой скоростью генерации токенов.
Читать подробнее →
GPT-6 Sol и Luna: новые рубежи ценовой эффективности от OpenAI
Линейки Sol и Luna кардинально снижают стоимость решения сложных задач на токен по сравнению с предыдущими поколениями.
Читать подробнее →
Claude Opus 5.5 возглавил мировой рейтинг в Индексе интеллекта
Абсолютный лидер мирового тестирования: максимальные показатели в сложных рассуждениях, математике и архитектуре ПО.
Читать подробнее →
Бенчмарки и детальный анализ Grok 4.7 от xAI
Замеры скорости генерации, пропускной способности и качества ответов Grok 4.7 в независимых тестах.
Читать подробнее →
Ant Group представила финансовую специализированную модель Ling-3.0-flash-Fin
Специализированная языковая модель для банковского сектора, аудита финотчётности и инвестиционного анализа.
Читать подробнее →
Анонс обновлённых индексов возможностей Artificial Analysis v1.1
Новая методология классификации возможностей: разделение на кодинг, математику, агентскую логику и скорость.
Читать подробнее →
Бенчмарки флагманской GPT-6 Astra: замеры ума, задержки и цены
Подробный разбор производительности топовой модели OpenAI: тесты глубокого рассуждения и работы с длинным контекстом.
Читать подробнее →
Анонс Индекса интеллекта Artificial Analysis v4.3: новые стандарты оценки
Версия v4.3 включает усложнённые агентские задачи, проверку галлюцинаций и тесты на многошаговое планирование.
Читать подробнее →
OpenBMB выпустила компактную MiniCPM5-2B с выдающимся качеством
Модель весом всего 2 миллиарда параметров превосходит многие системы 7B-13B на стандартных академических тестах.
Читать подробнее →
Анонс Индекса интеллекта Artificial Analysis v4.2
Обновление весов бенчмарков с акцентом на проверку реального кодинга и работу с внешними инструментами.
Читать подробнее →
Muse Spark 1.3: Meta выходит на передовой рубеж ИИ-интеллекта
Новый релиз Muse Spark 1.3 сокращает отрыв от закрытых проприетарных лидеров индустрии.
Читать подробнее →
Google представила Gemini 3.8 Flash — четвёртую Flash-модель за 4 месяца
Невероятный темп релизов Google: Gemini 3.8 Flash сочетает субсекундный TTFT с интеллектом уровня прошлогодних Pro-моделей.
Читать подробнее →
Claude Fable 5.1 возглавил Индекс интеллекта Artificial Analysis
Обновление Fable 5.1 укрепило лидерство Anthropic в комплексных многошаговых задачах и анализе данных.
Читать подробнее →
Agnes AI выпустила бета-версию Agnes 2.5 Pro
Независимые замеры производительности перспективной мультимодальной модели от Agnes AI.
Читать подробнее →
ИИ карманного масштаба: замеры компактных моделей на смартфонах
Тестирование Llama, Gemma и MiniCPM на флагманских мобильных чипсетах: токены в секунду, нагрев и автономность.
Читать подробнее →
Анонс Speech Agent Arena: битва голосовых ИИ-агентов в реальном диалоге
Арена голосовых агентов: слепое сравнение задержки ответа, естественности интонаций и устойчивости к перебиваниям.
Читать подробнее →
Индекс поисковых агентов Artificial Analysis: сравнение качества веб-поиска
Один и тот же агент с разными поисковыми API: замеры актуальности, глубины поиска и фильтрации спама.
Читать подробнее →
Анонс Optima: конструктор кастомных бенчмарков под задачи бизнеса
Инструмент создания персонализированных тестов: загружайте свои документы и измеряйте точность моделей именно на ваших данных.
Читать подробнее →
Gemini 3.7 Flash: оптимальное соотношение интеллекта и времени выполнения задач
Google установила новый оптимум Парето: высокая точность при минимальном времени ожидания ответа агента.
Читать подробнее →
Upstage Solar Pro 4: результаты бенчмарков и подробный анализ
Флагман от южнокорейской команды Upstage: замеры скорости инференса, работы с контекстом и логических рассуждений.
Читать подробнее →
Grok 4.6 возвращает xAI в число лидеров по интеллекту и стоимости
Детальный анализ Grok 4.6: агрессивная ценовая политика и высокая производительность в технических задачах.
Читать подробнее →
NVIDIA запустила Nemotron 3.5 Lightning для высокоскоростного инференса
Специальная оптимизация для генерации с минимальной задержкой первого токена и высокой плотностью обслуживания.
Читать подробнее →
Анонс AA-AnalystAgent: бенчмарк для количественного анализа таблиц и документов
Проверка способности ИИ-агентов работать с комплексными финансовыми моделями Excel и сложными корпоративными отчётами.
Читать подробнее →
Muse Glimmer: результаты тестов и сравнительный анализ
Легковесная архитектура от Meta: тесты скорости и точности в сценариях встроенных ассистентов.
Читать подробнее →
Запуск версии v4.1.1 Индекса интеллекта Artificial Analysis
Уточнённая калибровка весов бенчмарков рассуждений и устранение артефактов в тестах кодинга.
Читать подробнее →
Muse Spark 1.2: бенчмарки и сравнительный анализ
Промежуточное обновление Muse Spark: прогресс в тестах MMLU-Pro и HumanEval.
Читать подробнее →
Индекс точности провайдеров API: одна модель — разное качество ответа
Сравнение хостинг-провайдеров: как квантование и системные промпты у разных вендоров меняют итоговый результат одной и той же модели.
Читать подробнее →
DeepSeek V4 Flash (ревизия 0731): 50 баллов интеллекта (+10 пунктов к прошлой версии)
Обновление контрольной точки DeepSeek V4 Flash принесло резкий скачок точности без изменения стоимости инференса.
Читать подробнее →
Inkling Small почти догнал базовую модель Inkling при весе втрое меньше
Прорыв в дистилляции: модель с менее чем 1/3 параметров уступает полноразмерной версии всего один балл в общем индексе.
Читать подробнее →
Agnes AI выпустила альфа-версию Agnes 2.5 Pro
Первые замеры ранней сборки Agnes 2.5 Pro на бенчмарках рассуждений и языковой компетенции.
Читать подробнее →
Claude Opus 5: новый эталон в интеллектуальной работе ИИ-агентов
Флагман Anthropic пятого поколения устанавливает новые рекорды в агентских рабочих процессах и автономном исследовании.
Читать подробнее →
Opus 5: интеллект уровня Fable 5 при существенно меньшей стоимости за задачу
Сравнительный анализ затрат: почему Opus 5 становится более экономичным выбором для глубоких корпоративных задач.
Читать подробнее →
Как Inkling от Thinking Machines справляется со сложной агентской работой
Глубокий стресс-тест открытой модели Inkling на многочасовых исследовательских и аналитических задачах.
Читать подробнее →
Kimi K3 заняла 2-е место в бенчмарке AA-Briefcase, уступив только Fable 5
Высокая надёжность аргументации и фактчекинга позволила Kimi K3 обойти большинство американских закрытых конкурентов.
Читать подробнее →
Gemini 3.6 Flash и 3.5 Flash-Lite: двукратное сокращение времени на задачу
Google оптимизировала внутреннюю задержку инференса: агенты выполняют цепочки вызовов инструментов в два раза быстрее.
Читать подробнее →
Kimi K3 вошла в топ-3 мирового рейтинга наравне с Opus 4.8 и GPT-5.5
Китайская модель Kimi K3 достигла 3-й строчки мирового рейтинга с выдающимися показателями логического вывода.
Читать подробнее →
4 флагманских релиза за 8 дней: уже 6 лабораторий преодолели отметку 50 баллов
Небывалая плотность релизов в индустрии ИИ: конкуренция обостряется, а цены на интеллект продолжают падать.
Читать подробнее →Thinking Machines выпустила Inkling: новый лидер среди открытых моделей США
Открытые веса американской лаборатории Thinking Machines обошли предыдущие аналоги в тестах кодинга и математики.
Читать подробнее →
Сравнение линеек GPT-5.6 Sol, Terra и Luna: интеллект против стоимости
Какая версия GPT-5.6 выгоднее для вашего сценария: детальное сопоставление тарифов API и качества ответов.
Читать подробнее →
Muse Spark 1.1: Meta набрала 8 баллов интеллекта за три месяца
Динамика развития открытых моделей Meta: ключевые улучшения архитектуры и результаты независимых замеров.
Читать подробнее →
Бенчмарки GPT-5.6: замеры интеллекта, скорости и затрат
Независимые результаты тестирования флагмана OpenAI: сравнение с семейством Claude и Gemini на актуальных задачах.
Читать подробнее →
Grok 4.5 выводит xAI на передний край мирового уровня интеллекта
Мощный кластер Colossus приносит плоды: Grok 4.5 входит в группу лидеров по качеству генерации программного кода.
Читать подробнее →
Анонс EnterpriseOps-Gym-AA: бенчмарк DevOps и enterprise-автоматизации
Тестирование моделей в реальных песочницах: настройка Kubernetes, дебаг CI/CD пайплайнов и устранение инцидентов.
Читать подробнее →
Анонс Harvey LAB-AA: оценка работы ИИ-агентов на реальных юридических кейсах
Специализированный бенчмарк анализа договоров, поиска прецедентов и юридического комплаенса.
Читать подробнее →
Анонс AutomationBench-AA: бенчмарк автоматизации бизнес-процессов
Совместный бенчмарк с Zapier: проверка того, как модели оркестрируют API, CRM и сценарии интеграций без сбоев.
Читать подробнее →
Claude Sonnet 5: сильная агентская логика при возросшей стоимости за задачу
Экономический анализ: окупается ли повышенная цена Sonnet 5 за счёт сокращения числа повторных попыток агента.
Читать подробнее →
Замеры времени выполнения задач в бенчмарке AA-Briefcase
Сколько минут требуется разным моделям для подготовки подробного инвестиционного меморандума.
Читать подробнее →
Анонс Индекса сквозных голосовых моделей Speech-to-Speech
Оценка моделей, работающих напрямую со звуком без промежуточного перевода в текст: задержка, акценты и эмоции.
Читать подробнее →
Анонс AA-Briefcase: комплексный бенчмарк сложной аналитической работы
Новый стресс-тест для моделей: анализ многостраничных финансовых отчётов, бизнес-планов и стратегических документов.
Читать подробнее →
GLM-5.2 стала новой ведущей открытой моделью в Индексе интеллекта
Флагман Zhipu AI с открытыми весами возглавил категорию open weights, продемонстрировав зрелые рассуждения.
Читать подробнее →
Индекс интеллекта Artificial Analysis v4.1: акцент на агентские нагрузки
Эволюция методологии: почему простые тесты с выбором ответа уходят в прошлое и как оценивать автономных агентов.
Читать подробнее →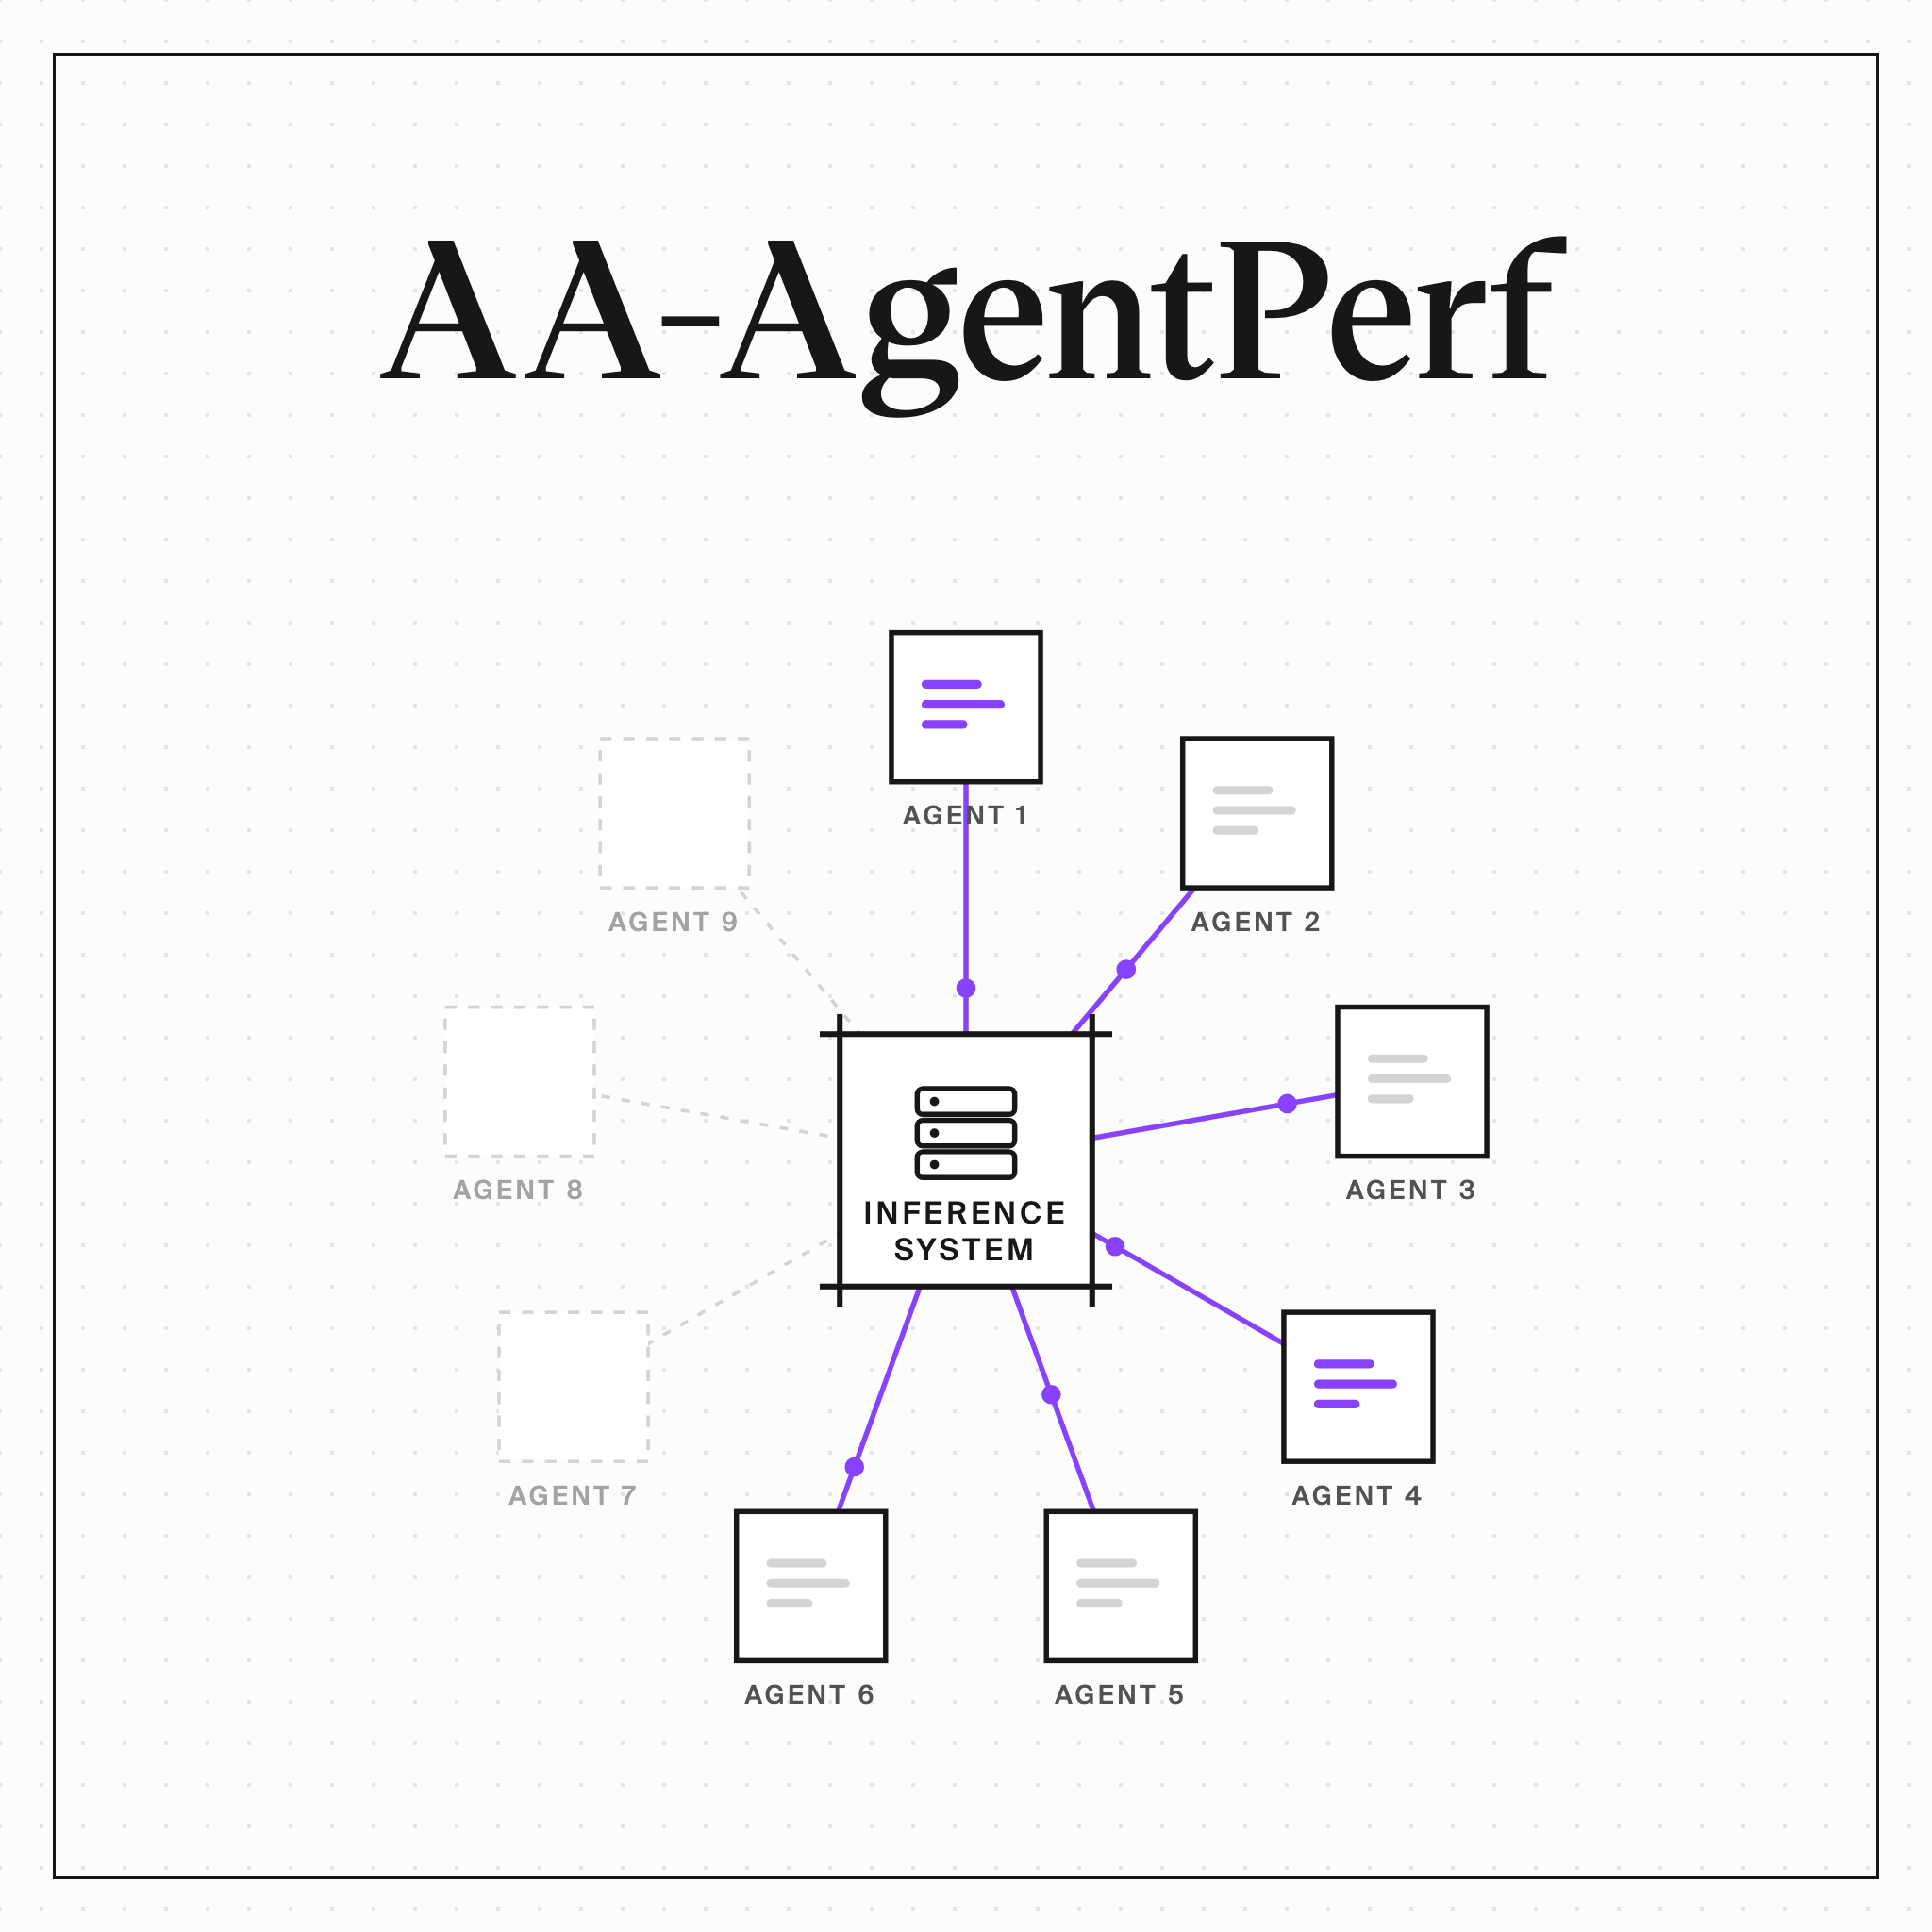
Первые результаты AA-AgentPerf: аппаратный бенчмарк для агентских вычислений
Как серверное оборудование справляется с тысячами параллельных вызовов агентов: пропускная способность и задержки.
Читать подробнее →
Бенчмарки защитных моделей: безопасность, процент отказов и задержка
Сравнение Llama Guard, NeMo Guardrails и закрытых фильтров: баланс между безопасностью и ложными срабатываниями.
Читать подробнее →
Claude Fable 5 дебютировал на 1-м месте в Индексе интеллекта
Новая архитектура Anthropic обеспечивает непревзойдённую точность логических выводов и кода.
Читать подробнее →
Claude Fable 5: первая публичная модель класса Mythos от Anthropic
Архитектурные инновации, расширенные контекстные окна и новые горизонты автономности.
Читать подробнее →
North Mini Code: компактная кодинг-модель MoE от Cohere
Cohere представила MoE-модель для разработчиков: высокая скорость автодополнения кода при минимальных требованиях к памяти.
Читать подробнее →
MiniMax-M3: лидер среди открытых моделей будущего релиза
Предварительные результаты тестов ожидаемого китайского флагмана MiniMax-M3 на длинных контекстах.
Читать подробнее →
Релиз NVIDIA Nemotron 3 Ultra: быстрый, умный и открытый ИИ
NVIDIA выпустила Nemotron 3 Ultra с передовой плотностью параметров и оптимизациями под TensorRT-LLM.
Читать подробнее →
Fun-Realtime-TTS: новая TTS-модель, возглавившая лидерборд озвучки текста
Сверхнизкая задержка первого аудиопакета и естественное звучание человеческой речи в режиме реального времени.
Читать подробнее →
MAI-Transcribe-1.5: новый рекорд Парето по точности и скорости распознавания речи
Модель транскрибации речи нового поколения превосходит Whisper Large v3 по скорости и доле ошибок в сложных аудиозаписях.
Читать подробнее →
AA-WER Streaming: новый бенчмарк потокового распознавания речи
Тестирование речевых API на шумных звонках, перебиваниях и потоковом аудио с замером задержки каждого слова.
Читать подробнее →
Анонс Nemotron 3 Ultra: высокоскоростной американский открытый интеллект
NVIDIA раскрыла характеристики Nemotron 3 Ultra, разработанной для масштабных облачных развёртываний.
Читать подробнее →
Claude Opus 4.8: детальный анализ новой модели #1 в мире
Замеры производительности флагмана Claude Opus 4.8: рекордные баллы в кодинге, математике и научном анализе.
Читать подробнее →
ITBench-AA: бенчмарк для проверки ИИ-агентов на реальных SRE-инцидентах
Как нейросети справляются с авариями в проде: расследование логов, поиск первопричины и применение фиксов.
Читать подробнее →
MiniCPM5-1B: сильнейшая открытая модель в ультралегком весе 1B
Полноценный ассистент с приличным русским языком и базовой логикой, работающий локально прямо в браузере или на телефоне.
Читать подробнее →
Cursor Composer 2.5: топ-3 в рейтинге кодинг-агентов при цене в 10-60 раз ниже конкурентов
Как команде Cursor удалось оптимизировать вызовы моделей и снизить себестоимость сложных правок кода в десятки раз.
Читать подробнее →
Cohere выпустила открытую модель Command A+ спустя год после релиза первой версии
Открытые веса от Cohere с акцентом на RAG, многоязычность и точное следование корпоративным инструкциям.
Читать подробнее →
Gemini 3.5 Flash: рекордсмен по соотношению интеллекта и скорости
Всё о модели Google, изменившей представление о возможностях компактных и дешёвых нейросетей.
Читать подробнее →
OpenBMB представила мультимодальную модель MiniCPM-V 4.6 1.3B Instruct
Распознавание изображений и видео на устройстве с весом всего 1.3 миллиарда параметров.
Читать подробнее →
Обзор свежих релизов моделей с открытыми весами: сравнение характеристик
Большой сравнительный дайджест: Llama, Qwen, DeepSeek, Mistral и компактные модели для локального запуска.
Читать подробнее →
xAI запустила Grok 4.3: улучшенная агентская работа и сниженные цены
Снижение тарифов на токены и прогресс в кодинге: замеры производительности Grok 4.3 на актуальных бенчмарках.
Читать подробнее →
DeepSeek возвращается в лидеры открытых моделей с релизами V4 Pro и V4 Flash
Китайская лаборатория DeepSeek обновила свои ключевые модели, продемонстрировав выдающееся соотношение цены и качества.
Читать подробнее →
OpenAI GPT-5.5 стала новым мировым лидером среди ИИ-моделей
GPT-5.5 возглавила глобальный Индекс интеллекта, продемонстрировав беспрецедентную глубину рассуждений.
Читать подробнее →
Kimi K2.6: новый лидер среди открытых нейросетей
Как Kimi удалось потеснить признанных лидеров в бенчмарках математических и инженерных рассуждений.
Читать подробнее →
Claude Opus 4.7: характеристики, бенчмарки и всё, что нужно знать
Полный обзор возможностей предыдущего флагмана Anthropic: тесты скорости, цены и качества рассуждений.
Читать подробнее →
Сравнение открытых моделей до 32B параметров: баланс веса и ума
Какие модели помещаются на одну видеокарту RTX 4090 или Mac Studio и при этом справляются со сложными задачами.
Читать подробнее →
Новый облик платформы Artificial Analysis: редизайн и новые разделы
Обзор обновлений независимой платформы тестирования: новые графики Парето, замеры задержки и калькуляторы.
Читать подробнее →
Muse Spark: Meta возвращается в мировую гонку передовых нейросетей
Архитектурные особенности семейства Muse и результаты первых независимых замеров производительности.
Читать подробнее →
Gemma 4: Google на передовом рубеже открытых моделей
Все технические подробности линейки Gemma 4: веса, лицензии, производительность в токенах/сек и тесты ума.
Читать подробнее →
MAI-Transcribe-1: всё о новой модели транскрибации речи
Сравнение с отраслевыми стандартами: распознавание многоязычной речи, расстановка пунктуации и таймкодов.
Читать подробнее →
Sarvam 105B и 30B: Индия вступает в глобальную гонку открытых моделей
Национальные языковые модели Индии с поддержкой десятков региональных языков и диалектов.
Читать подробнее →
MiniMax M2.7: всё о новой мощной китайской модели
Сверхдлинное контекстное окно и качественная обработка многостраничных документов: тесты MiniMax M2.7.
Читать подробнее →
MiMo-V2-Pro: архитектура, бенчмарки и практическое применение
Детальный разбор многопрофильной модели MiMo-V2-Pro: от логики до обработки табличных данных.
Читать подробнее →
NVIDIA Nemotron 3 VoiceChat: передовой рубеж диалогового голосового взаимодействия
Синхронизация генерации текста и аудио для реалистичных голосовых помощников с низкой задержкой.
Читать подробнее →
NVIDIA Nemotron 3 Super: лидер в сфере открытого и энергоэффективного интеллекта
Архитектурные оптимизации инференса позволяют модели выдавать рекордное число токенов на ватт энергии.
Читать подробнее →
Линейка компактных моделей Qwen 3.5: тесты и эффективность
Тестирование моделей Qwen 3.5 малого размера: скорость работы на локальном оборудовании и бенчмарки.
Читать подробнее →
Gemini 3.1 Pro Preview: новый технологический лидер в индустрии ИИ
Google представила превью Gemini 3.1 Pro, установив рекорд в тестах аналитического понимания видео и кода.
Читать подробнее →
Claude Sonnet 4.6: характеристики, скорость и тесты
Разбор одной из самых популярных «рабочих лошадок» индустрии: идеальный баланс ума и скорости генерации.
Читать подробнее →
Qwen3.5-397B-A17B: архитектура MoE и результаты испытаний
Флагманская модель Mixture-of-Experts от Alibaba Cloud: только 17B активных параметров при общей ёмкости 397B.
Читать подробнее →
Claude Sonnet 4.6: новый лидер в экономическом бенчмарке GDPval-AA
Оценка экономической целесообразности применения модели в типовых задачах офисных специалистов.
Читать подробнее →
AA-WER v2.0: бенчмарк точности распознавания речи для реальных условий
Вторая версия бенчмарка транскрибации: замеры устойчивости моделей к шуму, реверберации и сленгу.
Читать подробнее →
MiniMax-M2.5: всё о новой модели со сверхдлинным контекстом
Замеры скорости и качества извлечения информации из сотен страниц технической документации.
Читать подробнее →
GLM-5: всё о флагмане от команды Zhipu AI
Результаты испытаний флагмана Zhipu AI в задачах программирования, математики и синтеза длинных текстов.
Читать подробнее →
Claude Opus 4.6: всё, что нужно знать о флагмане Anthropic
Подробный обзор возможностей модели: архитектурные нюансы, расценки API и результаты независимых бенчмарков.
Читать подробнее →
Opus 4.6 захватывает лидерство в решении реальных аналитических задач
Замеры качества работы с комплексными многостраничными корпоративными кейсами и документами.
Читать подробнее →
Qwen3 Max Thinking: бенчмарки и анализ рассуждающей модели
Тестирование думающей модели от Alibaba Cloud: длина цепочки размышлений и точность олимпиадных задач.
Читать подробнее →
Kimi K2.5: возможности, контекст и результаты тестов
Замеры качества работы модели Kimi K2.5 с длинными документами и кодом.
Читать подробнее →
Gemini 3 Flash: рекордное быстродействие и интеллект от Google
Модель, доказавшая, что сверхбыстрый инференс и низкая стоимость не означают компромиссов в качестве.
Читать подробнее →
Stirrup: открытый фреймворк для создания автономных ИИ-агентов
Архитектура лёгкого агентского фреймворка: параллельное исполнение инструментов и управление состоянием.
Читать подробнее →
Анонс Индекса открытости моделей Artificial Analysis Openness Index
Методология оценки открытости: доступность весов, датасетов обучения, архитектурных описаний и лицензий.
Читать подробнее →
Claude Opus 4.5: замеры производительности и подробный анализ
Исторический срез развития семейства Claude: как менялась планка интеллекта за последние поколения.
Читать подробнее →
Gemini 3 Pro: всё, что нужно знать о флагмане Google
Детальный обзор мультимодального гиганта Google с миллионным контекстным окном.
Читать подробнее →
AA-Omniscience: всесторонний бенчмарк знаний и фактчекинга галлюцинаций
Тест на эрудицию и честность: как часто модели выдумывают факты при вопросах повышенной сложности.
Читать подробнее →
Kimi K2-Thinking: тесты глубокого логического рассуждения
Первые эксперименты Moonshot AI с режимом рассуждений: анализ скрытых токенов и точности ответов.
Читать подробнее →
MiniMax M2: результаты тестов и сравнительный анализ
Ранняя версия архитектуры MiniMax: баланс скорости генерации и точности анализа текста.
Читать подробнее →
GPT-5: бенчмарки интеллекта, задержки и ценовой анализ
Подробный аудит флагмана пятого поколения: сравнение стоимости токенов и качества на широком спектре задач.
Читать подробнее →
Анализ открытых моделей OpenAI: тесты и перспективы
Независимое тестирование моделей OpenAI с открытыми весами: сравнение с альтернативами на HuggingFace.
Читать подробнее →
Анонс AA-LCR: бенчмарк логики на сверхдлинных контекстах (Long Context Reasoning)
Тест, отличающий простое «нахождение иголки в стоге сена» от глубокого сопоставления фактов на 500k+ токенов.
Читать подробнее →
Независимый анализ ведущих GPU для ИИ: NVIDIA против AMD
Сравнение H100, H200, B200 и AMD MI300X/MI325X: реальная стоимость инференса, пропускная способность и задержка.
Читать подробнее →
Обновление DeepSeek R1: рассуждения, производительность и тесты
Революционная рассуждающая модель DeepSeek R1: как открытая модель сравнялась с закрытыми гигантами за малую долю цены.
Читать подробнее →
Итоги Google I/O: замеры и бенчмарки новых моделей Gemini
Сводный отчёт по результатам тестирования обновлённых линеек Flash и Pro, показанных на конференции Google.
Читать подробнее →