NVIDIA запустила Nemotron 3.5 Lightning для высокоскоростного инференса
Специальная оптимизация для генерации с минимальной задержкой первого токена и высокой плотностью обслуживания.
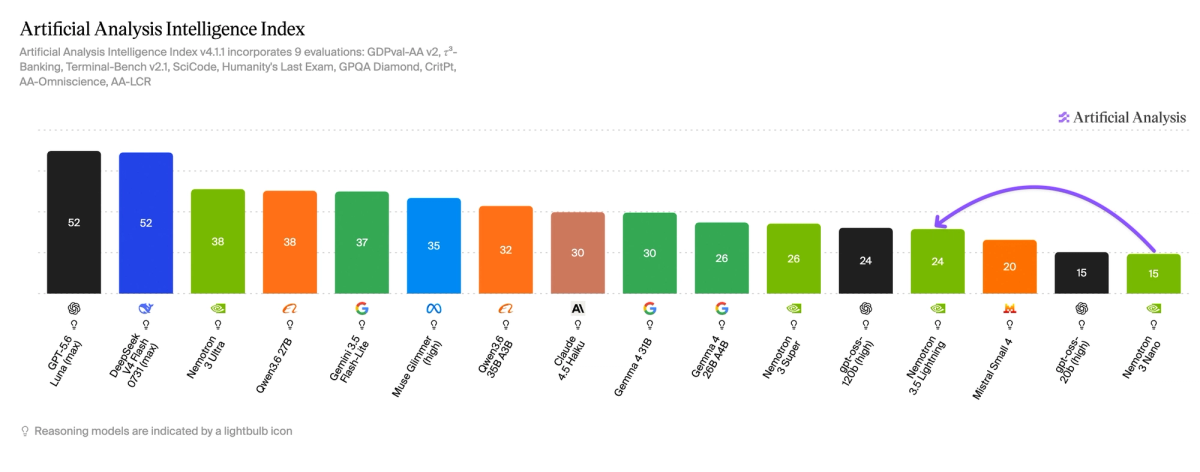
NVIDIA только что выпустила первую модель Nemotron 3.5: Nemotron 3.5 Lightning, высокоэффективную модель небольшого открытого веса с производительностью, аналогичной gpt-oss-120b, примерно на четверть от общих параметров.
Nemotron 3.5 Lightning является преемником NVIDIA Nemotron 3 Nano 30B A3B с 31,6B общих и 3,6B активных параметров. Он сохраняет ту же гибридную архитектуру Mamba-Transformer и небольшой размер, что и Nemotron 3 Nano, но существенно улучшает интеллект и производительность агентов.
Ключевые выводы
➤ Значительный скачок в интеллекте: Nemotron 3.5 Lightning набрал 24 балла по индексу интеллекта искусственного анализа, что на +9 баллов лучше, чем у Nemotron 3 Nano (15). Это ставит его в один ряд с gpt-oss-120b от OpenAI (24) и лишь немного уступает Nemotron 3 Super (26), модели примерно в 4 раза больше его размера.
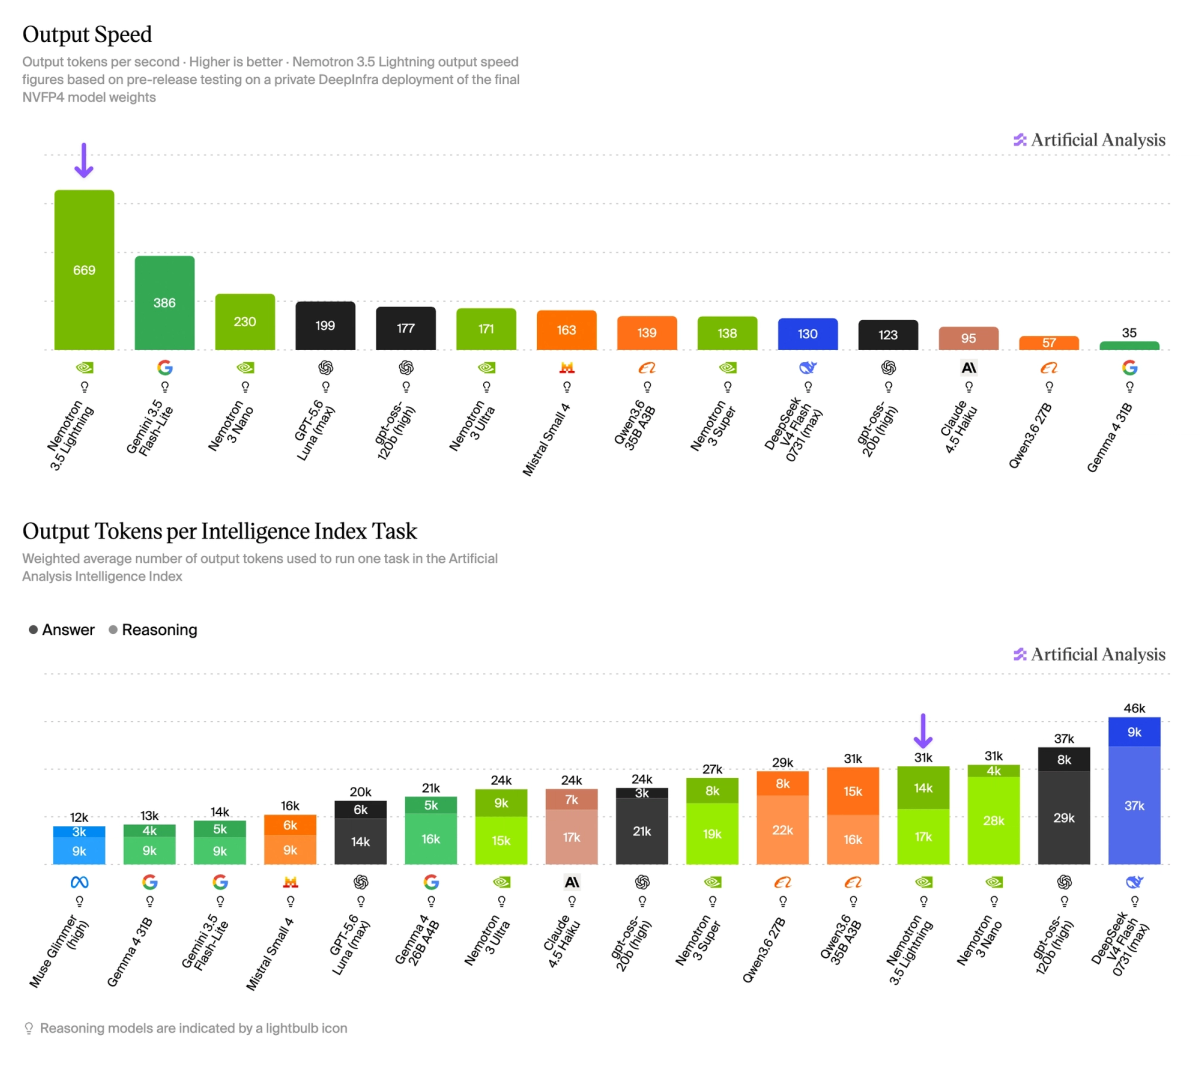
➤ Оптимизирован для повышения эффективности: Nemotron 3.5 Lightning находится позади самых интеллектуальных небольших моделей в своем размерном классе, таких как Qwen3.6 35B A3B (32) и Muse Glimmer (высокий, 35), но он создан для другой точки на переднем крае. В ходе предварительного тестирования конечной точки DeepInfra, обслуживающей окончательные веса NVFP4, мы измерили среднюю скорость вывода почти 670 токенов в секунду, что намного быстрее, чем те модели, которые обслуживаются сегодня на рынке.
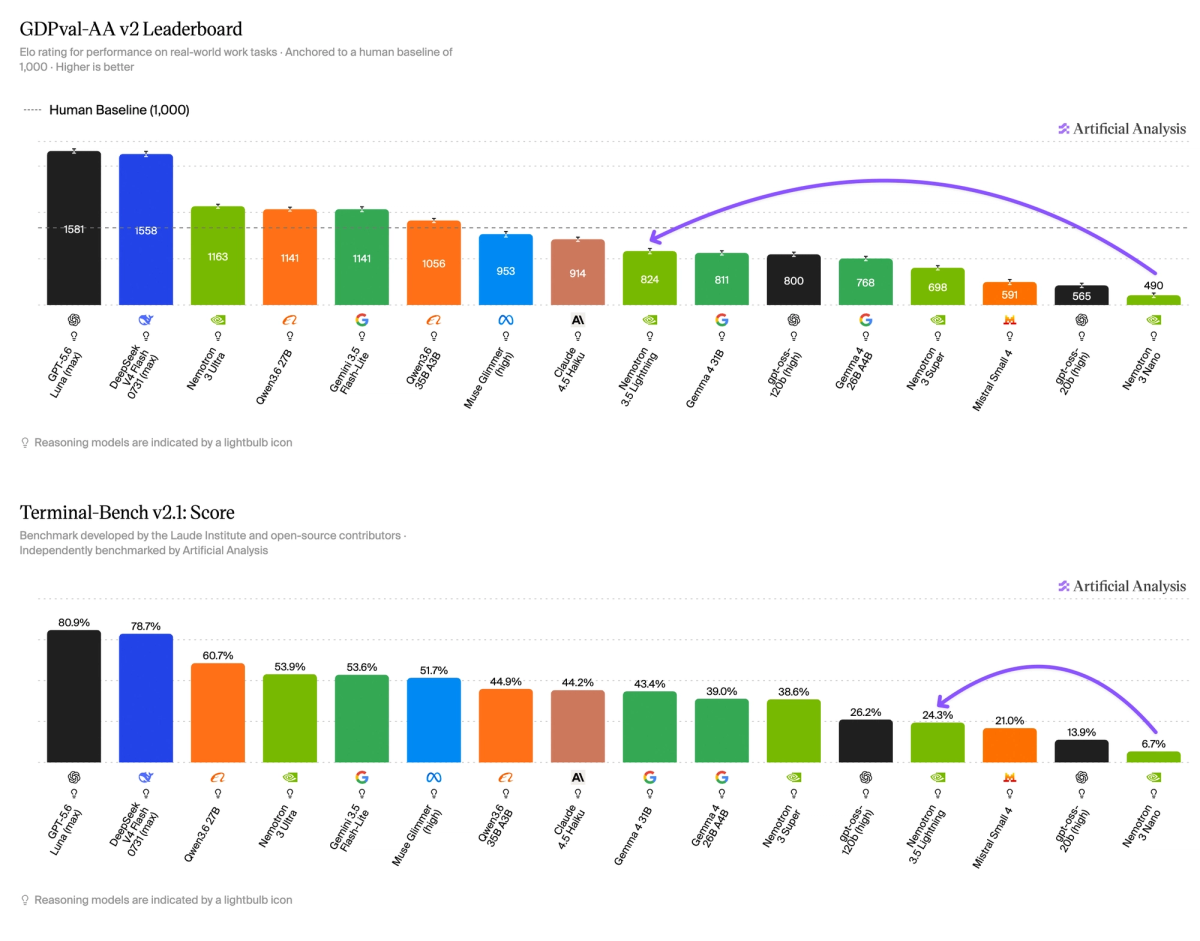
➤ Значительный агентный прирост: наибольшие улучшения по сравнению с Nemotron 3 Nano наблюдаются в агентных оценках GDPval-AA v2 (+334 ELO, выше gpt-oss-120b и Nemotron 3 Super) и Terminal-Bench v2.1 (24% против 7%). В сочетании со скоростью и разрешающей лицензией OpenMDW-1.1 это позиционирует Lightning как эффективную рабочую модель для крупномасштабных агентных развертываний.
➤ Квантование NVFP4 практически без потерь: как и в предыдущих выпусках Nemotron, модель поставляется в NVFP4 вместе с весами BF16. Мы измерили вариант NVFP4 на уровне 24 по индексу интеллекта и увидели минимальное ухудшение по сравнению с весами более высокой точности.
Ключевые детали модели
➤ Контекстное окно на 1 миллион токенов, текстовая модель рассуждения
➤ Всего 31,6 млрд и 3,6 млрд активных параметров
➤ Выпущено под лицензией OpenMDW-1.1, открыто для коммерческого использования без существенных ограничений.
➤ Веса моделей теперь доступны вместе с бессерверным выводом от таких поставщиков, как DeepInfra, Fireworks, FriendliAI, CoreWeave, GMI Cloud, Nebius и Crusoe.
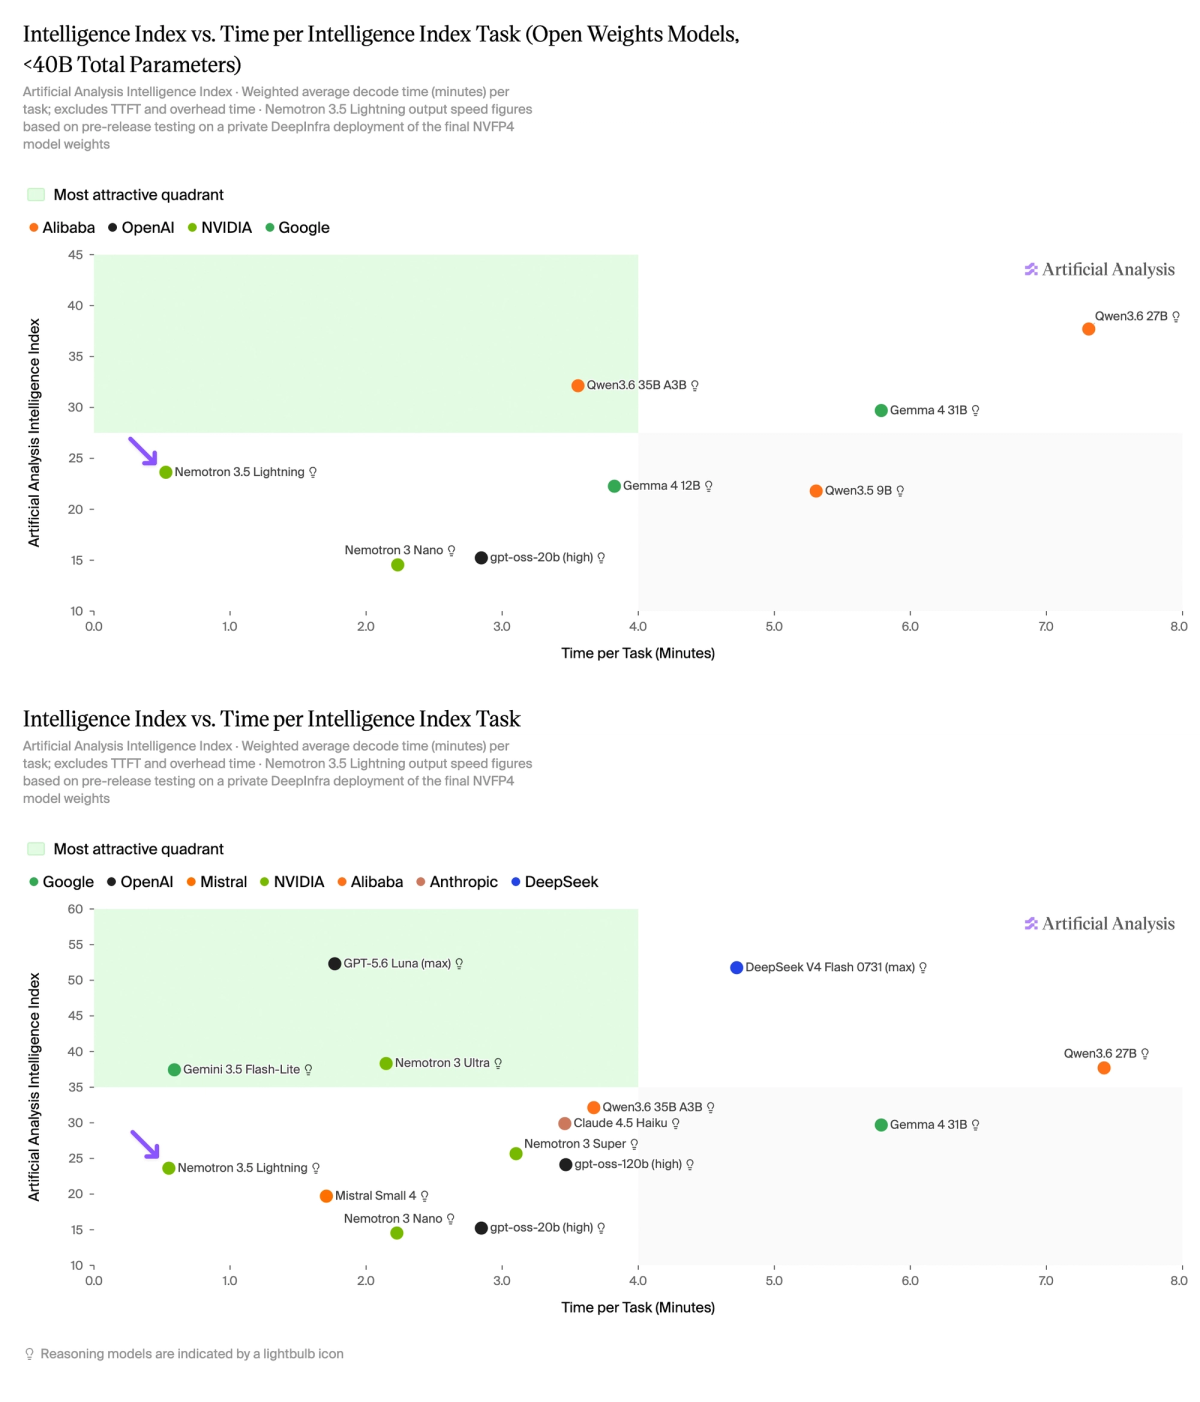
Nemotron 3.5 Lightning отличается высокой производительностью: по индексу искусственного анализа интеллекта время выполнения задачи индекса интеллекта составляет ~0,5 минуты, исходя из скоростей вывода, достигнутых с помощью предварительной версии конечной точки DeepInfra, и окончательных весов NVFP4.
Это существенно быстрее, чем у аналогов с открытыми весами, значительно опережая Qwen3.6 35B A3B (~3,5 мин), gpt-oss-120b (~3,4 мин), Gemma 4 31B (~5,8 мин) и Qwen3.6 27B (~7,3 мин). NVIDIA работала с партнерами, включая CodeRabbit и Harvey, над постобучением Nemotron 3.5 Lightning для повышения производительности в доменах, стремясь использовать простое обучение для достижения высокой эффективности и производительности для рабочих процессов конкретных пользователей.
Тем не менее, запатентованные модели по-прежнему демонстрируют высокие показатели общей эффективности использования времени: Gemini 3.5 Flash-Lite достигает индекса интеллекта 37 за одинаковое время на задачу, а GPT-5.6 Luna (макс.) набирает 52 балла при менее чем 2 минутах на задачу.
На этот раз время выполнения задачи обусловлено чрезвычайно высокой скоростью вывода и высокой эффективностью токенов. Nemotron 3.5 Lightning использовал такое же количество выходных токенов на задачу, что и Nemotron 3 Nano, обеспечивая при этом прирост индекса интеллекта +9, а на предварительной версии конечной точки DeepInfra мы измерили скорость вывода почти 670 токенов в секунду.
Агентские возможности Nemotron 3.5 Lightning — это шаг вперед для небольших моделей семейства Nemotron. Его показатель GDPval-AA v2 Elo, равный 824, превосходит как Nemotron 3 Super, так и gpt-oss-120b, а его показатель Terminal-Bench v2.1, равный 24%, в три раза превышает 7% Nemotron 3 Nano и почти соответствует gpt-oss-120b. Для модели такого размера и скорости это делает Lightning привлекательной моделью для агентных конвейеров.
Сравнение моделей искусственного анализа
Сравнение провайдеров
Технический блог NVIDIA