Claude Fable 5.1 возглавил Индекс интеллекта AI Стата
Обновление Fable 5.1 укрепило лидерство Anthropic в комплексных многошаговых задачах и анализе данных.
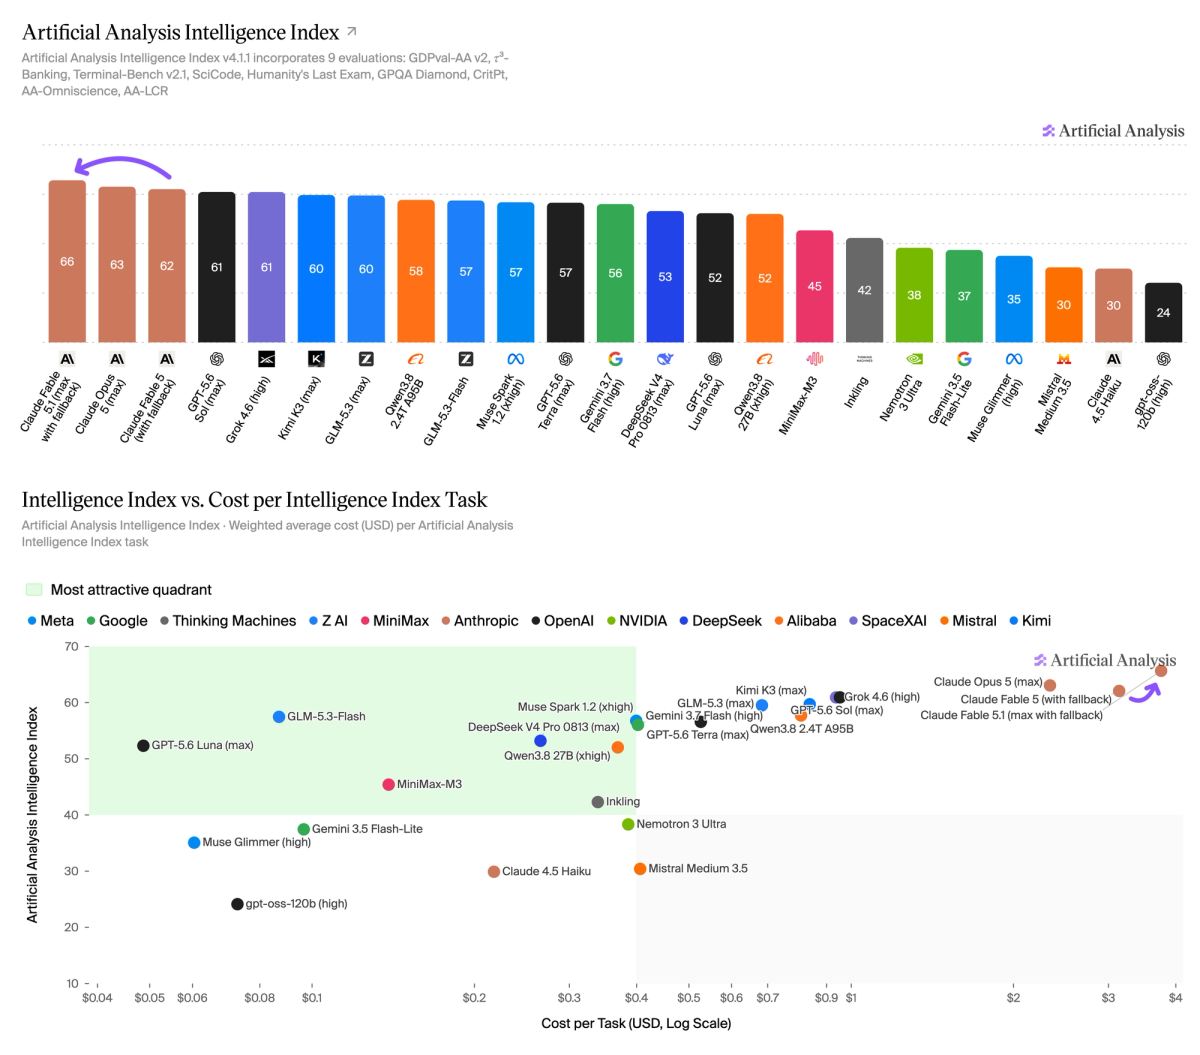
Мы поддержали Anthropic, предоставив предварительную оценку Claude Fable 5.1. При максимальном усилии он набирает 66 баллов по Индексу интеллекта искусственного анализа, самый высокий балл, который мы измеряли, опережая Claude Opus 5 (макс., 63), Claude Fable 5 (макс., 62), GPT-5.6 Sol (макс., 61) и Grok 4.6 (макс., 61). Мы оценивали модель с использованием резервного варианта Anthropic на стороне сервера «по умолчанию», который направляет запросы с флажком безопасности на Claude Opus 4.8 или Claude Opus 5; Резервный вариант обслуживал ~4% токенов вывода по индексу интеллекта.
Ключевые выводы
➤ Передовой интеллект с улучшениями по всем тестам: Fable 5.1 получает +4 балла по индексу интеллекта по сравнению с Fable 5. На HLE Fable 5.1 набирает 59,1%, что опережает предыдущий лучший результат в 55,5% у Claude Fable 5. Она показывает самые высокие оценки, которые мы когда-либо видели на Terminal-Bench v2.1 (91,4%) и SciCode (62,0%), а также на 𝜏³-Банковское дело получает 9 очков по сравнению с Fable 5.
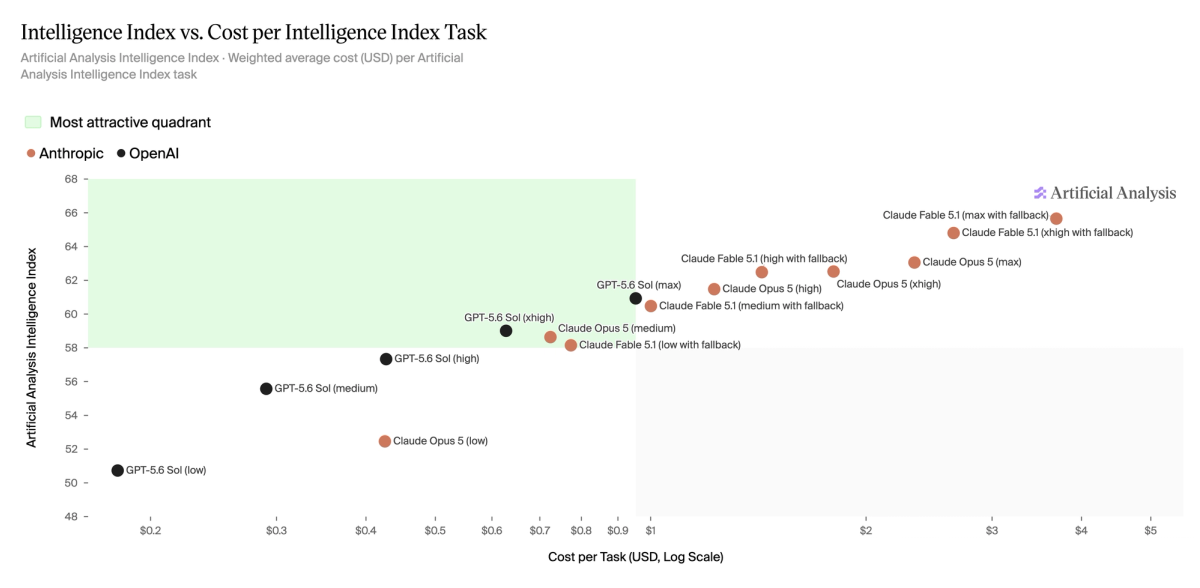
➤ Снижение цены на чтение кэша на 75%, но Fable 5.1 по-прежнему стоит дороже за задачу: Anthropic снизила цену чтения кэша с 1 доллара США до 0,25 доллара за 1 миллион кэшированных входных токенов, при этом стандартная цена не изменилась и составляет 10/50 долларов США за 1 миллион входных/выходных токенов. Fable 5.1 (максимум) стоит 3,76 доллара за задачу индекса интеллекта, что на 20 % больше, чем Fable 5 (максимум), поскольку в ней используется примерно в 1,7 раза больше выходных жетонов. Уменьшение кэша экономит около 1,40 доллара США на задачу, концентрируясь на агентных оценках, где большая часть входных токенов является чтением кэша. При выполнении xhigh усилий Fable 5.1 набирает 65 баллов по цене 2,72 доллара за задачу, что на 1,04 доллара меньше максимального значения, но все же выше Claude Opus 5 (максимум 63) при цене 2,34 доллара.
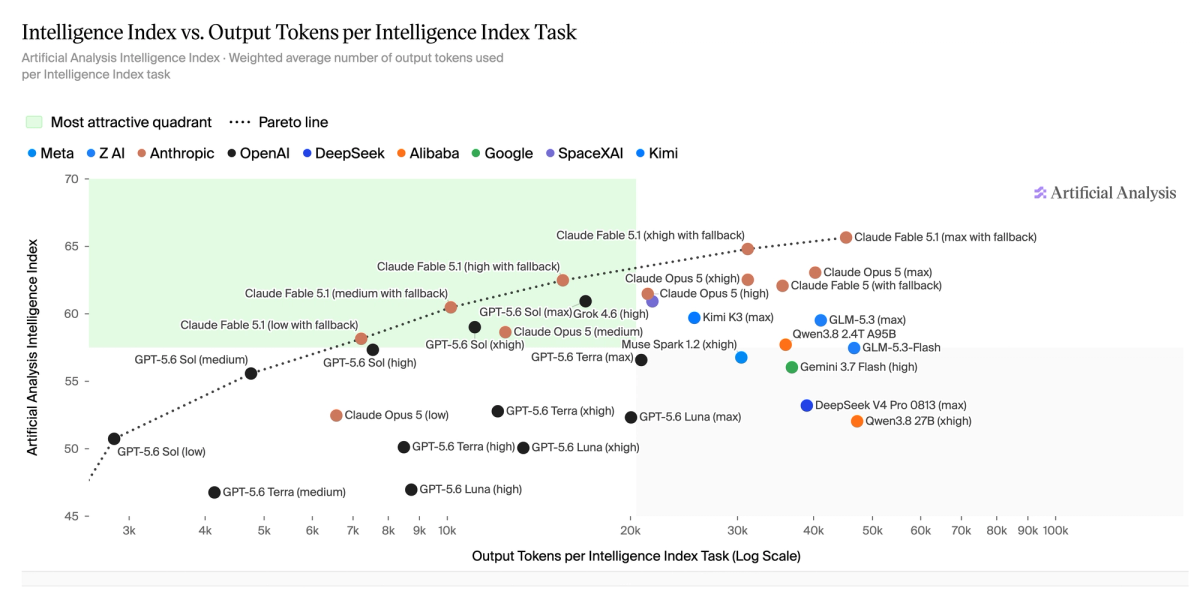
➤ Claude Fable 5.1 занимает верхнюю границу границы Парето по интеллекту и количеству выходных токенов на задачу: каждый вариант модели, получивший более высокий балл, чем GPT-5.6 Sol (средний) в индексе интеллекта, соответствует или превосходит уровень усилий Fable 5.1 как по интеллекту, так и по использованию токенов.
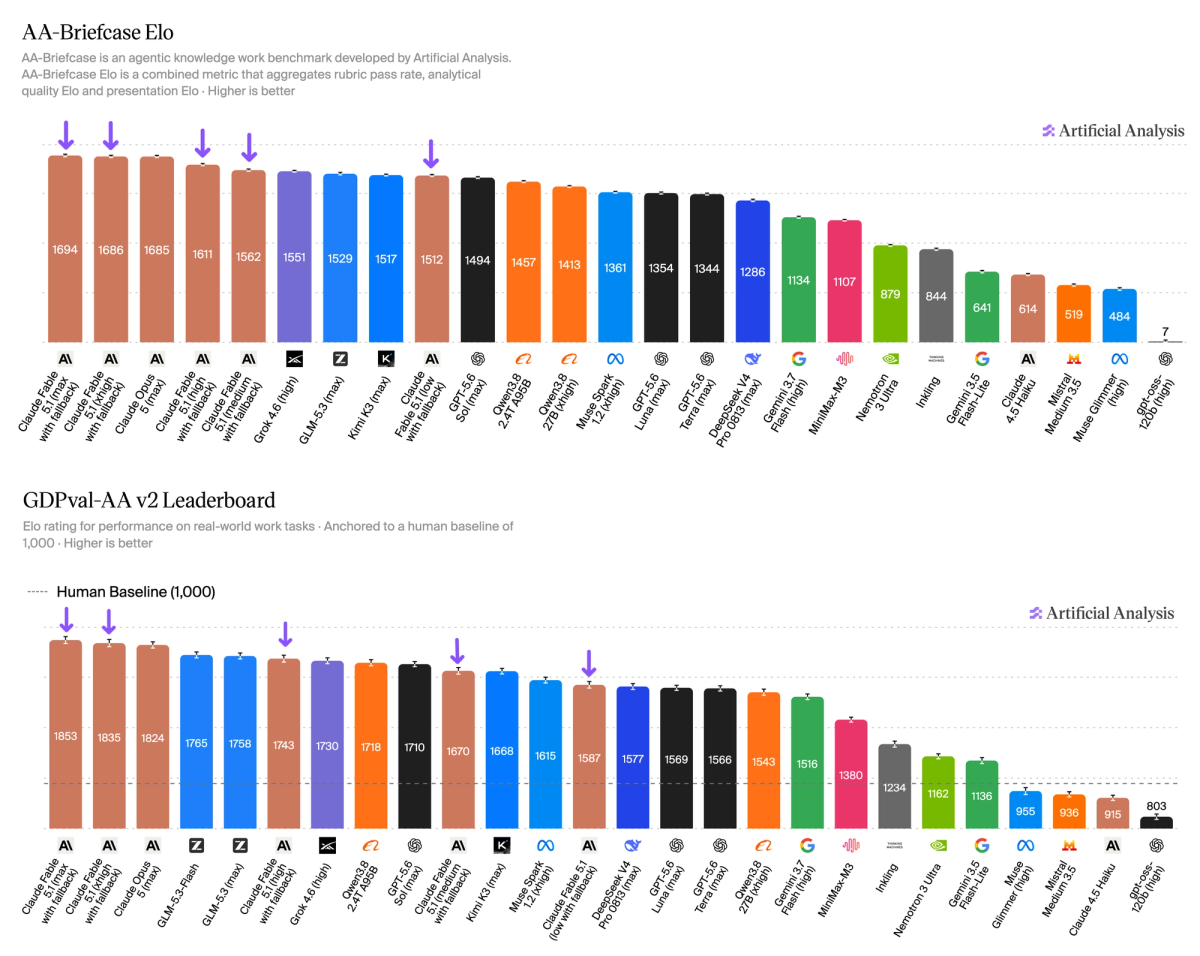
➤ Самые высокие баллы по задачам агентской работы, но фактически связаны с Opus 5: Fable 5.1 устанавливает самые высокие баллы, которые мы измеряли по GDPval-AA v2 (1853 Elo, +130 по сравнению с Fable 5) и AA-Briefcase (1694 Elo, +122 по сравнению с Fable 5), нашим оценкам работы агентских знаний. По сравнению с Claude Opus 5 преимущество GDPval-AA v2 находится в пределах доверительного интервала, а AA-Briefcase (1685) фактически равнозначен, при этом Fable 5.1 опережает по аналитическому качеству и правильности рубрик, но отстает по представлению.
Другие детали модели
➤ Контекстное окно: 1 миллион токенов, поддержка ввода изображений и текста, как и в других недавних запусках Anthropic.
➤ Цены: в Fable 5.1 сохранены цены ввода, вывода и записи в кэш в размере 10/50/12,5 долларов США за миллион токенов из Fable 5, но попадания в кэш были снижены до 0,25 долларов США за миллион токенов, относительное снижение на 75 %, что существенно снизит затраты на агентскую рабочую нагрузку.
Claude Fable 5.1 (максимум) стоит 3,76 доллара США за задачу Индекса интеллекта, что на 20 % больше, чем Claude Fable 5 (максимум) — 3,14 доллара США и в 1,6 раза больше Claude Opus 5 (максимум) — 2,34 доллара США, что примерно в 1,7 раза превышает количество выходных токенов Fable 5. Anthropic снизила цену чтения кэша с 1 до 0,25 доллара США за 1 млн сэкономленных токенов. ~$1,40 за задание; без него Fable 5.1 стоила бы ~5,16$. При высоком усилии Fable 5.1 набирает 65 баллов при цене 2,72 доллара за задачу, что на 1,04 доллара меньше максимального усилия.
Пять настроек усилий Claude Fable 5.1 охватывают 11-кратное увеличение использования выходных токенов: от 13,1 млн при низком уровне усилий до 143,7 млн при максимальном, а также оценку от 58 до 66 баллов по индексу искусственного анализа интеллекта. По уровням усилий Fable 5.1 находится на границе интеллекта и выходных токенов, но ее минимальный уровень выше, чем у семейства GPT-5.6: GPT-5.6 Sol (средний) использует немного меньше жетонов, чем Fable 5.1 (низкий), 12 миллионов против 13,1 миллиона.
Claude Fable 5.1 (max) опережает GDPval-AA v2 с 1853 Elo, опережая Claude Opus 5 (max) с 1824, хотя их доверительные интервалы перекрываются. В AA-Briefcase эти два показателя фактически равны 1694 против 1685, а промежуточные оценки расходятся: Fable 5.1 опережает по аналитическому качеству (2025 против 1980) и отстает по представлению (1495 против 1572). Оба теста проверяют, могут ли модели давать точные и хорошо представленные профессиональные результаты с использованием нашего эталонного агента с открытым исходным кодом Stirrup.
Claude Fable 5.1 (макс.) отвечает на 93,4% вопросов AA-Всеведение против 87,8% у Claude Opus 5 и демонстрирует самую высокую точность, которую мы измерили, - 67,2%, опережая Claude Fable 5 с 65,4%.
Из-за более высокого уровня попыток у него больше галлюцинаций: на вопросы, на которые он не ответил правильно, он пытался ответить в 72,6% против 63,6% в Claude Fable 5. Эти два эффекта компенсируются, и его показатель Индекса всеведения AA находится на уровне Claude Fable 5.
Полная разбивка отдельных оценок в Индексе интеллекта искусственного анализа для Claude Fable 5.1 по всем рассуждениям