Сравнение открытых моделей до 32B параметров: баланс веса и ума
Какие модели помещаются на одну видеокарту RTX 4090 или Mac Studio и при этом справляются со сложными задачами.

Модели с открытыми весами Sub-32B теперь предлагают уровень интеллекта GPT-5: Qwen3.5 27B (Рассуждение), соответствующий GPT-5 (средний) на уровне 42, и Gemma 4 31B (Рассуждение), соответствующий GPT-5 (низкий) на уровне 39 в Индексе интеллекта искусственного анализа.
Qwen3.5 от Alibaba и Gemma 4 от Google DeepMind — это два недавно выпущенных семейства открытых весов, которые продвигают вперед класс моделей с общими параметрами ниже 32B. Оба доступны в разных размерах с вариантами с рассуждениями и без рассуждений и предлагают встроенный мультимодальный ввод. Вместе они представляют собой современный уровень интеллекта в открытых весах при таком количестве параметров. Qwen3.5 27B достигает более высокого абсолютного интеллекта по индексу искусственного анализа интеллекта, а Gemma 4 31B более эффективен с точки зрения токенов.
Хотя эти модели Sub-32B теперь соответствуют уровню интеллекта GPT-5, состав этого интеллекта отличается. Обе модели открытых весов значительно отстают по фактическому знанию и избеганию галлюцинаций по сравнению с вариантами GPT-5: баллы AA-Всеведения составляют -42 (Qwen3.5 27B) и -45 (Gemma 4 31B) против -10 для GPT-5 (средний) и -10 для GPT-5 (низкий). В чем модели открытых весов добились прогресса, так это в основном в производительности агентов и критическом мышлении: Qwen3.5 27B существенно превосходит GPT-5 (средний) по агентному индексу искусственного анализа 55 против 46, а Gemma 4 31B опережает GPT-5 (низкий) на TerminalBench Hard (36% против 27%) и HLE (23% против 18%).
И Qwen3.5 27B, и Gemma 4 31B подходят для одного NVIDIA H100 (80 ГБ) с точностью BF16 и с квантованием могут работать локально на MacBook. Это практический порог, который делает эти модели доступными за пределами центра обработки данных. Это существенное отличие от предыдущего поколения: Gemma 3 была выпущена в марте 2025 года как модель без рассуждений и получила 10 баллов по индексу интеллекта. У Qwen3 было две итерации - исходное семейство Qwen3 и обновление 2507, причем флагманский Qwen3 235B A22B (Reasoning) набрал 20 баллов в оригинале и 30 баллов в варианте 2507.
Ключевые выводы
➤ Qwen3.5 27B (Рассуждение) получает 42 балла по Индексу интеллекта, используя 98 миллионов жетонов вывода, а Gemma 4 31B (Рассуждение) получает 39 баллов, используя 39 миллионов. Этот разрыв в эффективности токенов в 2,5 раза является ключевым компромиссом. Сила Qwen3.5 27B широка — GPQA (86%) и IFBench (76%), тогда как Gemma 4 31B лидирует по SciCode (+3,9 п.п.) и TerminalBench Hard (+3,8 п.п.).
➤ Оба семейства поставляют собственные мультимодальные данные в классе sub-32B. Qwen3.5 27B (Рассуждение) набирает 75% в MMMU-Pro, а Gemma 4 31B (Рассуждение) набирает 73%, что делает их двумя ведущими вариантами открытых весов по этому количеству параметров для приложений, требующих понимания зрения.
➤ Несмотря на совпадение уровней оценок GPT-5, обе модели с большим отрывом отстают по показателю AA-Всеведение - известная корреляция с меньшим размером модели: Qwen3.5 27B (Рассуждение) имеет оценку -42, а Gemma 4 31B (Рассуждение) - -45. Для сравнения, GPT-5 (средний) получает оценку -10, а родной брат Qwen3.5 397B A17B -30. Воспроизведение знаний выигрывает от большего количества параметров, и эти модели ниже 32B не могут устранить этот пробел только с помощью рассуждений.
➤ Граница открытых весов также значительно продвинулась за пределы размера параметра 32B. GLM-5.1 (Рассуждение) лидирует по индексу интеллекта с показателем 51, Kimi K2.5 (Рассуждение) с 47 и Qwen3.5 397B A17B (Рассуждение) с 45, хотя эти модели намного крупнее моделей ниже 32B. Разрыв между топовыми моделями с открытым весом и фирменным рубежом (Gemini 3.1 Pro Preview и GPT-5.4 (xhigh) с 57) сократился всего до 6 пунктов.
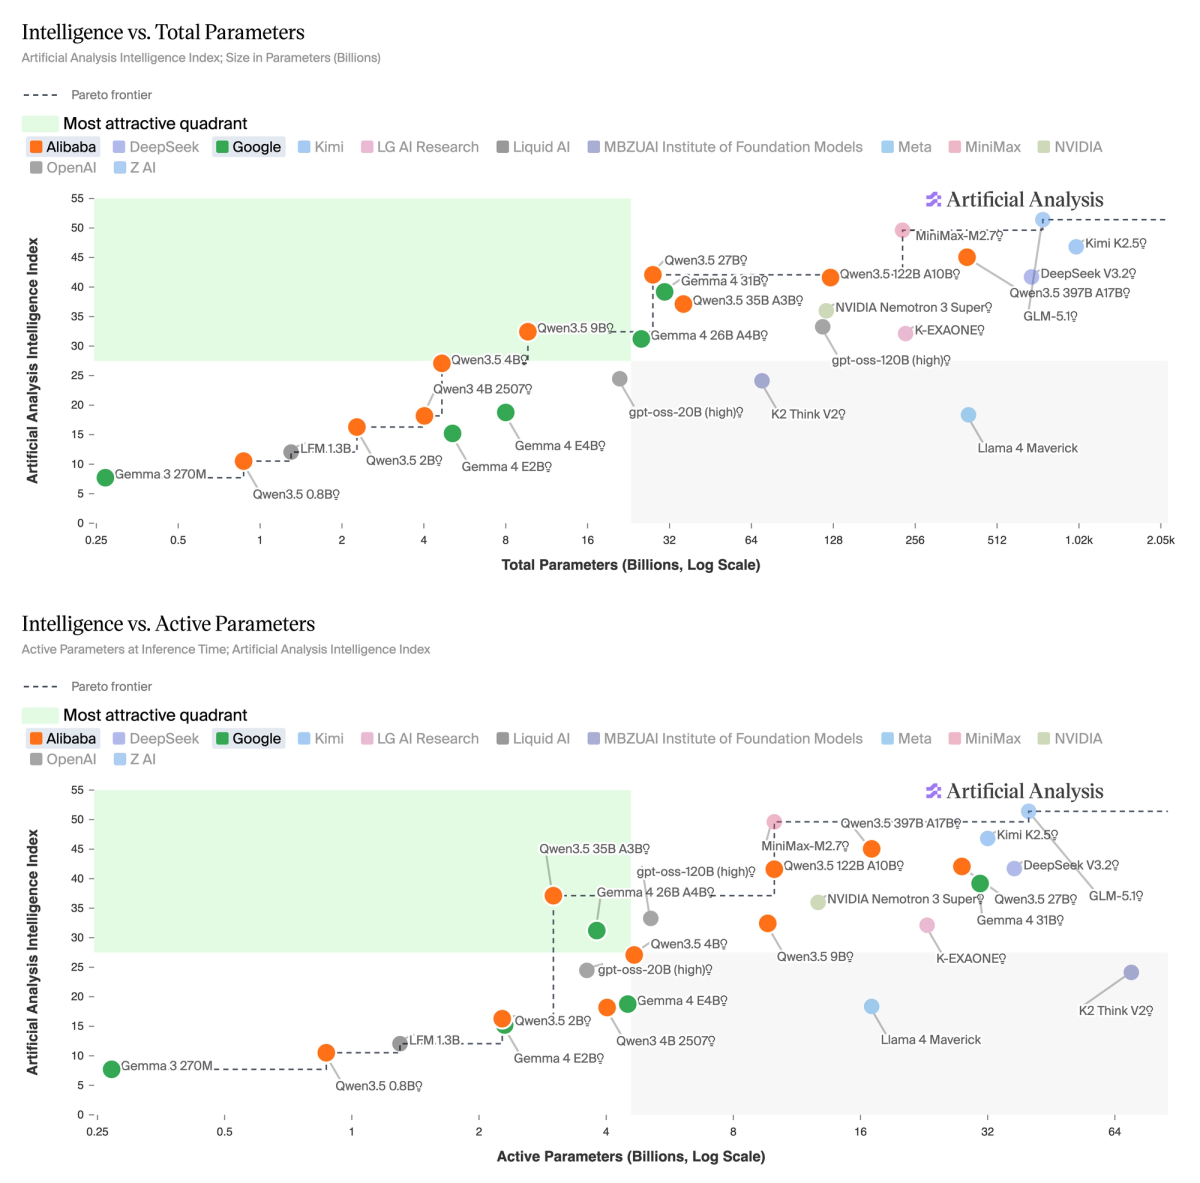
➤ Qwen3.5 занимает границу Парето для интеллекта по сравнению с общими параметрами и интеллекта по сравнению с активными параметрами среди моделей с открытыми весами ниже 32B. Плотный 27B (Рассуждение) с 42 баллами соответствует 122B A10B MoE с одной пятой общего веса, а 35B A3B (Рассуждение) набирает 37 баллов при активации только 3B параметров. Gemma 4 31B (Рассуждение) на уровне 39 является основным претендентом на общие параметры, а 26B A4B (Рассуждение) на уровне 31 соревнуется на активном уровне ~4B.
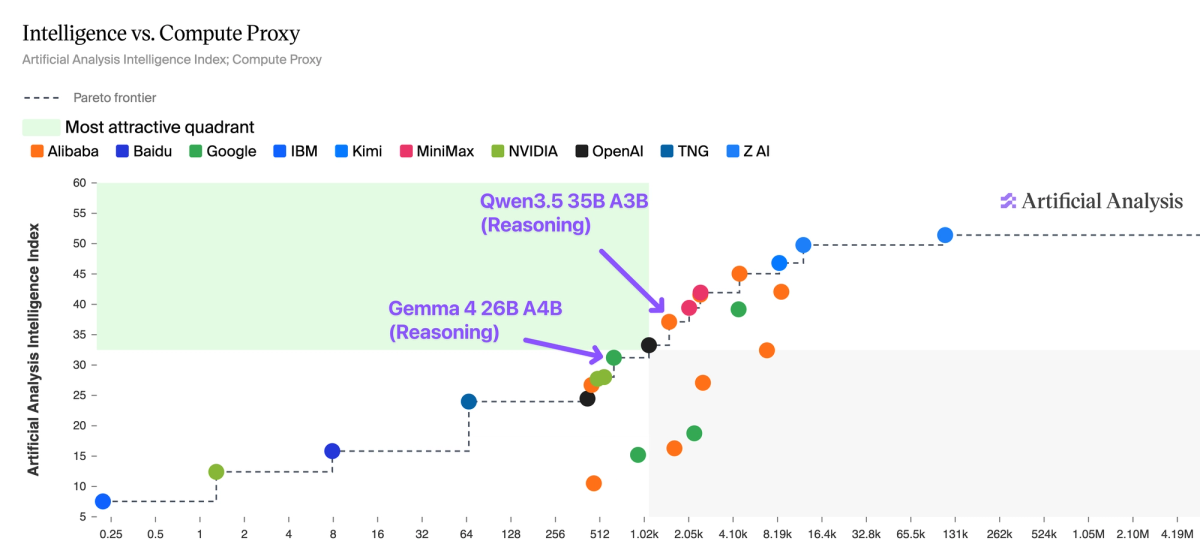
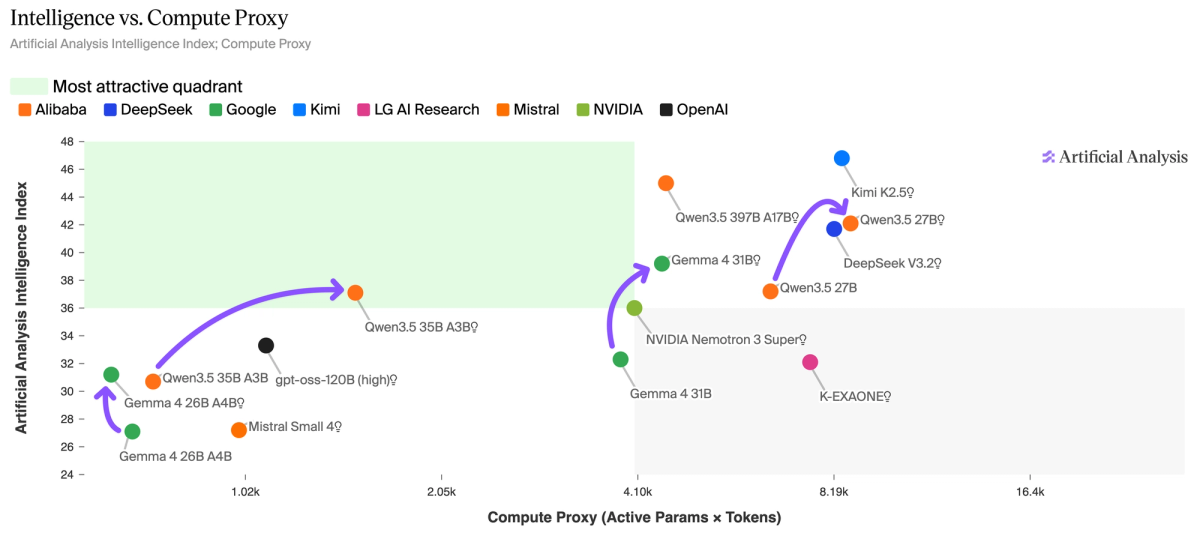
Gemma 4 находится на границе Парето между интеллектом и вычислительным прокси — метрикой, которую мы разработали для оценки общего объема вычислений, учитывающего как активные параметры, так и генерацию токенов. Qwen3.5 35B A3B (Рассуждение) набирает 37 баллов, но потребляет 100 миллионов токенов вывода, тогда как Gemma 4 26B A4B (Рассуждение) набирает 31 балл всего за 73 миллиона токенов.
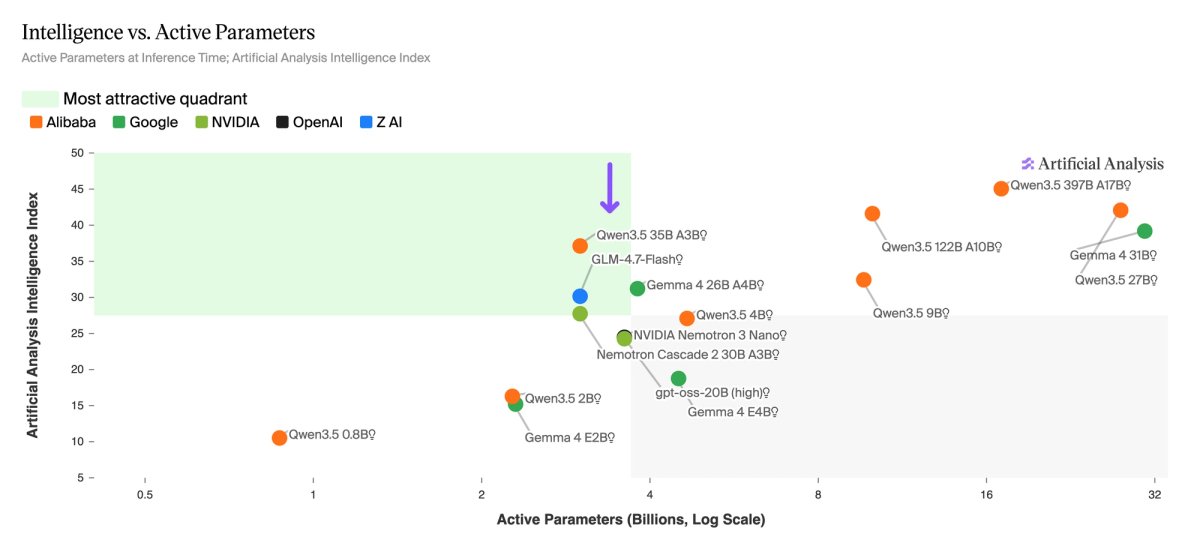
Уровень активных параметров ~3–4B становится все более конкурентоспособным: теперь в нем участвуют шесть моделей из пяти разных лабораторий. Год назад этого уровня не существовало. Qwen3.5 35B A3B (Рассуждение) лидирует по индексу интеллекта с 37, за ним следуют Gemma 4 26B A4B (Рассуждение) с 31, GLM-4.7-Flash (Рассуждение) с 30, Nemotron Cascade 2 30B A3B с 28 и gpt-oss-20B (высокая) и NVIDIA Nemotron 3 Nano 30B A3B (Рассуждение) оба по ~24. Быстрое сближение нескольких лабораторий в точке активных параметров ~3–4B отражает более широкий сдвиг в сторону архитектур MoE, оптимизированных для затрат на выводы на периферии, и меньших по размеру, более интеллектуальных и плотных моделей в целом.
Режимы без рассуждения конкурентоспособны в области открытых весов ниже 32B. Джемма 4 31B (Нерассуждение) получает 32 балла по Индексу интеллекта, используя всего 7,1 миллиона жетонов вывода — в 5,5 раз меньше, чем в режиме рассуждения, и снижение всего на 7 пунктов. Qwen3.5 27B (Нерассуждение) получает 37 баллов при использовании 25 миллионов жетонов — в 4 раза меньше, чем в режиме рассуждения, что означает снижение на 5 баллов. Для развертываний, чувствительных к задержке или с высокой пропускной способностью, эти режимы без рассуждений теперь соответствуют тем, которые передовые модели рассуждения получили меньше, чем год назад, при небольшом объеме вычислений.