AA-Omniscience: всесторонний бенчмарк знаний и фактчекинга галлюцинаций
Тест на эрудицию и честность: как часто модели выдумывают факты при вопросах повышенной сложности.

Анонсируем AA-Всезнание, наш новый эталон знаний и галлюцинаций по более чем 40 темам, где все модели, кроме трех, с большей вероятностью будут галлюцинировать, чем давать правильный ответ.
Встроенные знания в языковые модели важны для многих реальных случаев использования. Без знаний модели делают неправильные предположения и ограничены в своей способности работать в контексте реального мира. Такие инструменты, как веб-поиск, могут поддерживаться, но модели должны знать, что искать (например, модели не должны искать «многоклиентское постоянство» для запроса MCP, когда он явно относится к «протоколу контекста модели»).
Галлюцинация фактической информации является препятствием для возможности полагаться на модели и сохраняется во всех основных наборах оценочных данных. Оценка правильных ответов без каких-либо штрафов за неправильные ответы создает стимул для моделей (и лабораторий, обучающих их) пробовать каждый вопрос. Эта проблема наиболее очевидна, когда речь идет о знаниях: фактическую информацию никогда не следует выдумывать, тогда как в других контекстах полезны попытки, которые могут не сработать (например, кодирование новых функций).
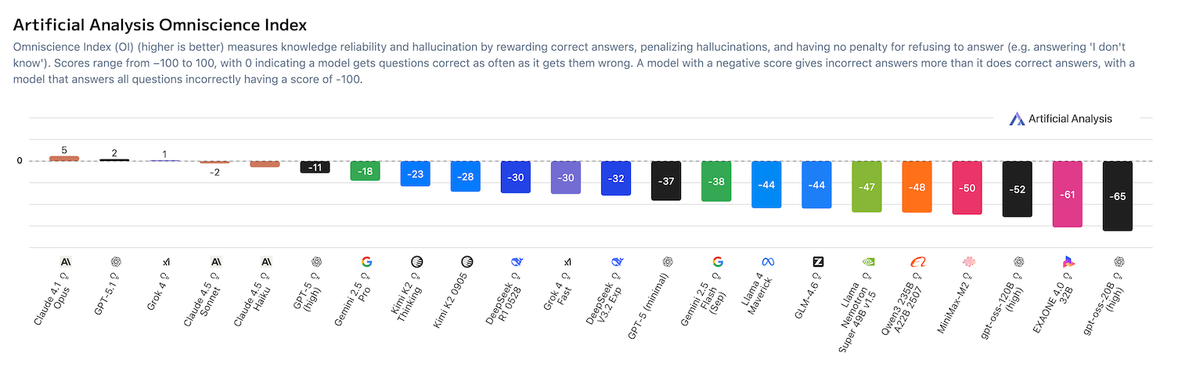
Индекс всеведения АА — это ключевой показатель, который мы сообщаем для всеведения АА. Он проверяет галлюцинации, наказывая модели за угадывание и признание того, что они не знают ответа. АА-Всезнание показывает, что все модели, кроме трех, с большей вероятностью будут галлюцинировать, чем давать правильный ответ на сложный вопрос. AA-Всезнание дополнит Индекс искусственного анализа интеллекта, включив в него измерение знаний и вероятности галлюцинаций.
Подробности АА-Всеведения
- 🔢 6000 вопросов по 42 темам в 6 областях («Бизнес», «Гуманитарные и социальные науки», «Здоровье», «Право», «Программная инженерия» и «Наука, инженерия и математика»)
- 🔍 89 подтем, включая библиотеки данных Python, государственную политику, налогообложение и многое другое, что дает более четкое представление о том, в чем модели превосходны, а где они терпят неудачу в различных областях.
- 🔄 Неправильные ответы наказываются в нашем показателе надежности знаний для наказания галлюцинаций.
- 📊 3 метрики: точность (% правильных ответов), уровень галлюцинаций (% неправильных ответов/воздержавшихся), индекс AA-всеведения (+1 за правильный ответ, -1 за неправильный ответ, 0 за воздержавшихся, когда модель не пыталась ответить)
- 🤗 Набор тестовых данных с открытым исходным кодом: мы открываем 600 вопросов (10%), чтобы помочь лабораториям разрабатывать фактические и надежные модели. Распределение тем и производительность модели соответствуют полному набору (см. репозиторий HuggingFace).
- 📃 Бумага: более подробную информацию см. в статье AA-Всеведение.
Основные выводы
- 🥇 Claude 4.1 Opus занимает первое место в Индексе Всеведения, за ним следуют GPT-5.1 и Grok 4, прошедшие на прошлой неделе: даже самые лучшие пограничные модели набирают лишь немного больше 0, то есть они дают правильные ответы на сложные вопросы, составляющие АА-Всеведение, лишь незначительно чаще, чем неправильные. Лидерство Anthropic обусловлено низким уровнем галлюцинаций, тогда как позиции OpenAI и xAI в первую очередь обусловлены более высокой точностью (правильный процент).
Индекс всеведения АА
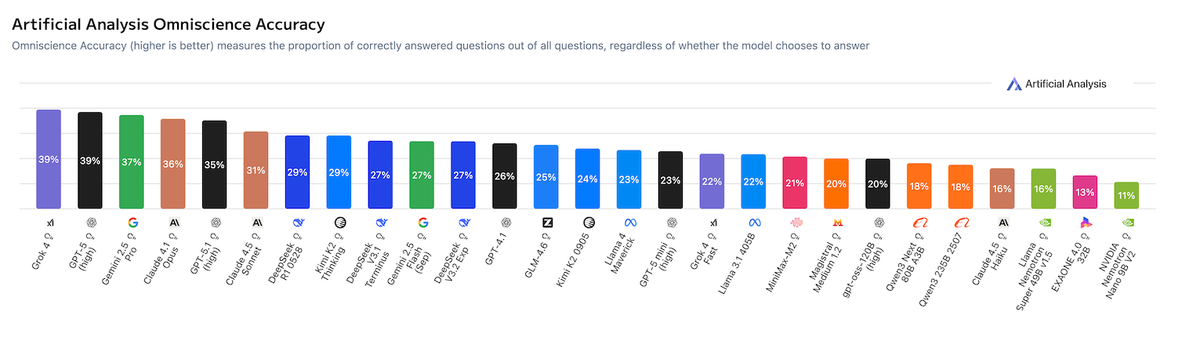
- 🥇 Grok 4 от xAI занимает первое место по точности AA-всеведения (наш простой показатель «процент правильности»), за ним следуют GPT-5 и Gemini 2.5 Pro: победа xAI может быть обеспечена за счет масштабирования общих параметров и вычислений перед тренировкой: Илон Маск сообщил на прошлой неделе, что Grok 4 имеет 3 триллиона общих параметров, что может быть больше, чем у GPT-5 и других запатентованных моделей.
AA-Всеведение Точность
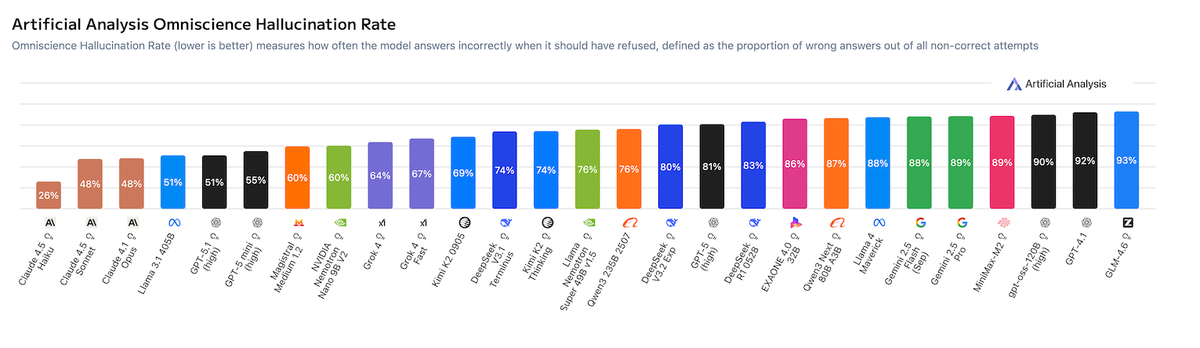
АА-Частота галлюцинаций всеведения
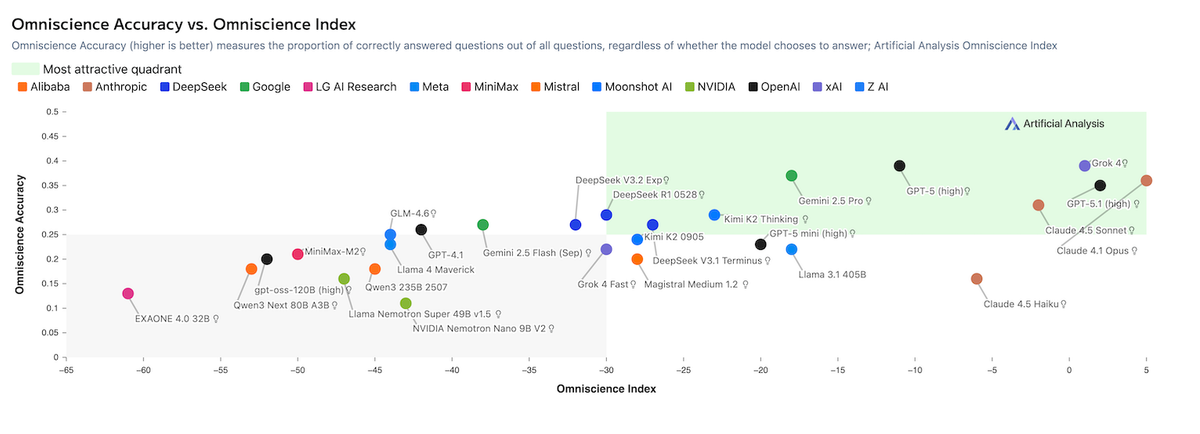
- 💭Высокие знания не гарантируют низкую галлюцинацию: уровень галлюцинаций измеряет, как часто модель догадывается, когда ей не хватает необходимых знаний. Модели с наивысшей точностью, в том числе модели GPT-5 и Gemini 2.5 Pro, не лидируют в Индексе всеведения АА из-за склонности к угадыванию при воздержании. Антропные модели, как правило, лучше справляются с неопределенностью: у Claude 4.5 Haiku самый низкий уровень галлюцинаций - 26%, что опережает 4.5 Sonnet и 4.1 Opus (48%).
Точность всеведения АА против индекса всеведения АА
- 📊 Модели различаются в зависимости от области: модели различаются по своей эффективности в шести областях всеведения АА — ни одна модель не доминирует во всех. В то время как Claude 4.1 Opus от Anthropic лидирует в области права, разработки программного обеспечения, гуманитарных и социальных наук, GPT-5.1 от Open AI обеспечивает высочайшую надежность в вопросах бизнеса, а Grok 4 от xAI показывает лучшие результаты в области здравоохранения, естественных наук, инженерии и математики. Выбор модели должен соответствовать варианту использования, а не выбору общего лидера.
Индекс всеведения АА по доменам (нормализованный)
- 📈 Более крупные модели имеют более высокие показатели точности, но не всегда надежности: более крупные модели, как правило, имеют более высокий уровень встроенных знаний, при этом Kimi K2 Thinking и DeepSeek R1 (0528) превосходят модели меньшего размера. Это преимущество не всегда сохраняется за Индексом всеведения АА. Например, Llama 3.1 405B от Meta превосходит более крупные варианты Kimi K2 благодаря одному из самых низких показателей галлюцинаций среди моделей (51%).
Индекс всеведения АА в сравнении с общими параметрами (выше); Точность AA-всеведения в сравнении с общими параметрами (ниже)
Подробнее об оценке и методологии читайте в нашей статье «АА-Всеведение».
Изучите примеры вопросов и оцените свою модель с помощью набора данных AA-Всезнание с помощью нашего набора данных HuggingFace.