Первые тесты AA-AgentPerf-Local на ноутбуке с NVIDIA RTX Spark N1X
Ноутбук с NVIDIA RTX Spark N1X завершил локальную нагрузку на Qwen3.8 27B за 18.7 минут при рекордной энергоэффективности.
NVIDIA RTX Spark N1X вмещает в ноутбук Windows до 128 ГБ унифицированной памяти и графический процессор Blackwell. Согласно нашим первым результатам AA-AgentPerf-Local, ноутбук RTX Spark выполняет рабочую нагрузку локального агента на Qwen3.8 27B за 18,7 минут.
AA-AgentPerf-Local воспроизводит записанные сеансы агента на локальном оборудовании.
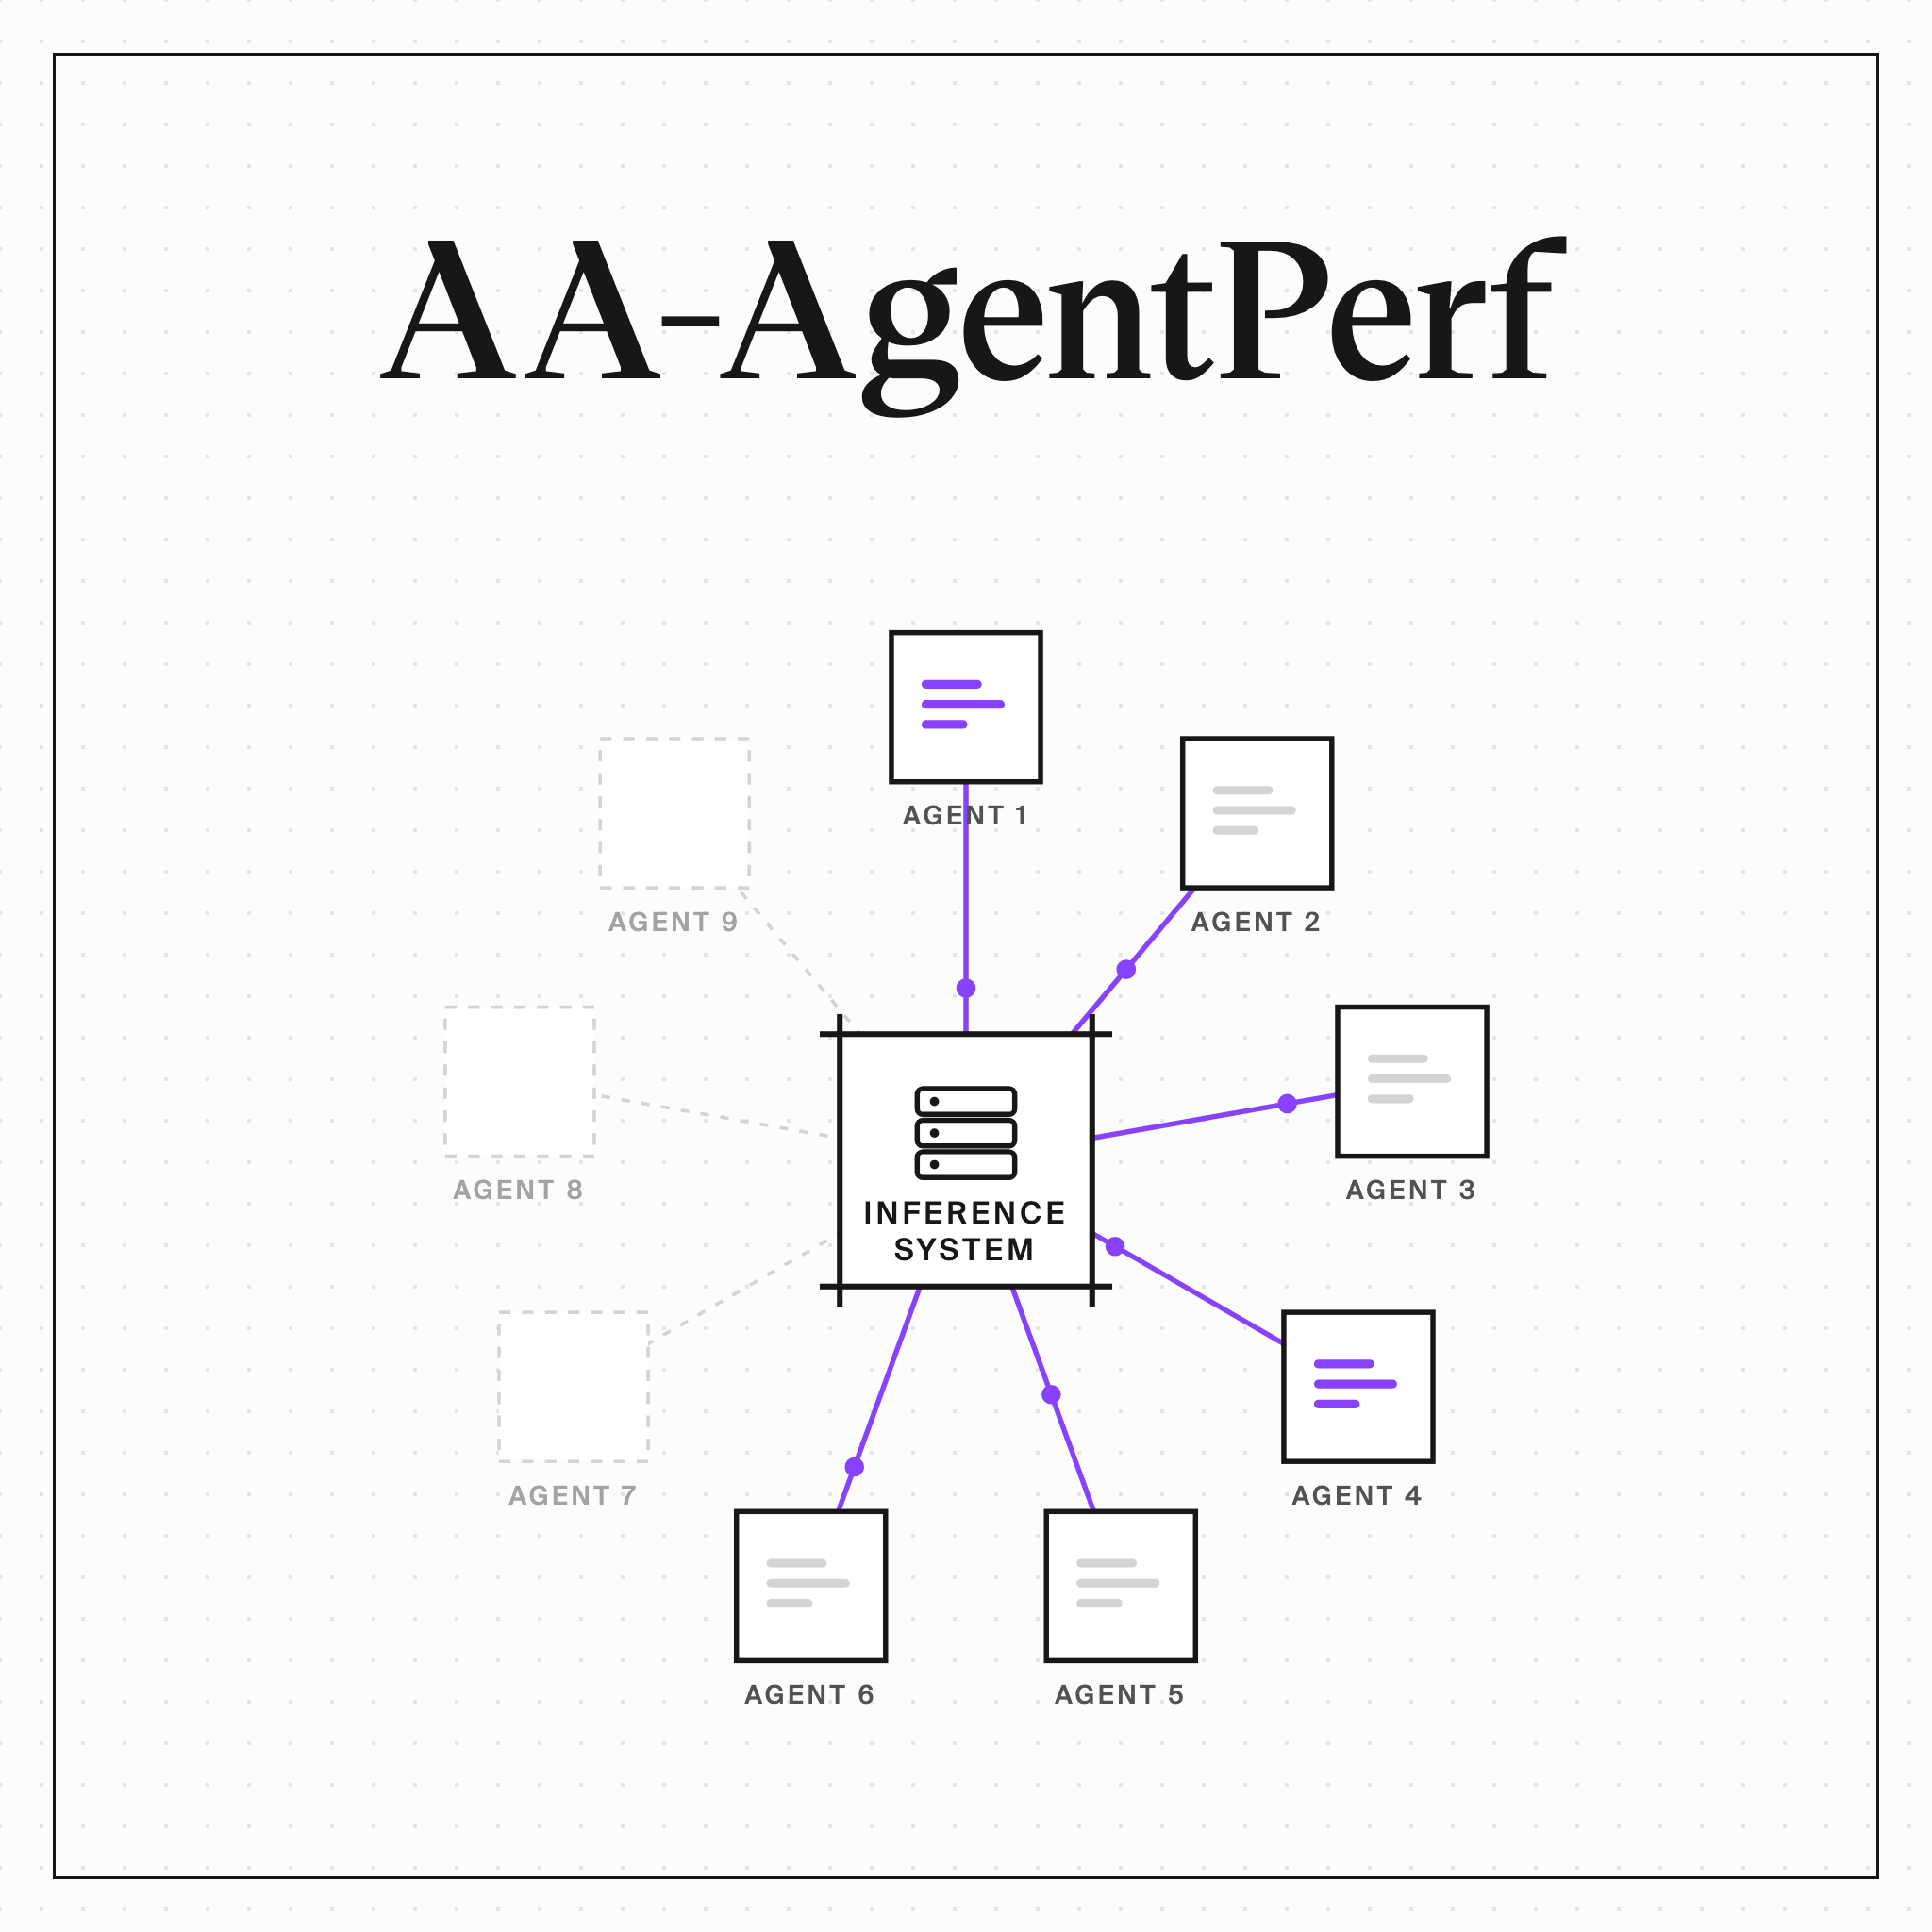
AA-AgentPerf-Local — это наш инструмент с открытым исходным кодом для измерения того, насколько быстро ноутбук или рабочая станция обслуживает ИИ-агента. Он воспроизводит записанные сеансы агента на модельном сервере, работающем на машине, причем каждый запрос переносит весь разговор, и измеряет, сколько времени требуется оборудованию для ответа на каждый ход.
Модель генерирует ровно то количество жетонов, которое записано для каждого хода, поэтому все системы выполняют одинаковую работу. Большая часть каждого приглашения представляет собой повторение содержимого предыдущего приглашения. Серверу, который хранит свой кеш, нужно только читать начальное приглашение каждой задачи и то, что добавляет каждый ход (в среднем около 450 токенов и до 6,4 КБ после большого вывода инструмента).
Записанные задачи агента: пять из PinchBench и три из SWE-bench.
Модель поворачивается, каждая из которых ведет полный разговор.
Токены контекста в самой длинной точке задачи
2,6 млн.
Токены подсказки, отправляемые в модель по всей рабочей нагрузке
196 тыс.
Новые токены подсказок (остальные повторяют предыдущую подсказку)
Выходные токены, одинаковое количество в каждой системе
AA-AgentPerf-Local рабочая нагрузка по умолчанию
Системы
M5 Pro · 64 ГБ · 20-ядерный графический процессор
20-ядерный процессор · 6144-ядерный графический процессор
Модели
RTX Spark устанавливает чип DGX Spark в ноутбук с Windows
RTX Spark — это платформа NVIDIA для ПК с ОС Windows на Arm, которую NVIDIA позиционирует как созданную для локального запуска агентов искусственного интеллекта. Его чип N1X, по сути, представляет собой GB10 от DGX Spark (в собственном каталоге рецептов NVIDIA RTX Spark указан как GB10) с 20-ядерным процессором Arm, 6144-ядерным графическим процессором Blackwell и до 128 ГБ общей памяти LPDDR5X. В ноутбуке память работает быстрее, обеспечивая на 10% большую пропускную способность, чем у DGX Spark (300 ГБ/с против 273 ГБ/с). Однако чип работает от 45 до 80 Вт (заявленный диапазон NVIDIA для ноутбуков N1X), тогда как GB10 рассчитан на 140 Вт.
Мы протестировали прототип 15-дюймового ноутбука Surface Laptop Ultra со 128 ГБ памяти по цене 5899,99 долларов США. Он работает под управлением Windows 11 на Arm и обслуживает каждую модель со встроенной сборкой Windows llama.cpp на графическом процессоре. Мы запускали его подключенным к сети с Windows, установленной в режим высокой производительности.
| RTX Искра N1X | GB10 (DGX Искра) | M5 Pro (MacBook Pro 14 дюймов) | |
|---|---|---|---|
| ЦП | 20 ядер (10 Cortex-X925, 10 Cortex-A725) | 20 ядер (10 Cortex-X925, 10 Cortex-A725) | 18 ядер |
| графический процессор | Блэквелл, 6144 ядра CUDA | Блэквелл, 6144 ядра CUDA | 20 ядер |
| Единая память | 128 ГБ LPDDR5X-9400 | 128 ГБ LPDDR5X-8533 | 64 ГБ LPDDR5X-9600 |
| Пропускная способность памяти | 300 ГБ/с | 273 ГБ/с | 307 ГБ/с |
| Мощность чипа | от 45 до 80 Вт | 140 Вт | Не опубликовано |
| Операционная система | Windows 11 на руке | ОС DGX (Ubuntu) | macOS |
Спецификации взяты со страницы NVIDIA RTX Spark и руководства по портированию, из документации NVIDIA DGX Spark и от Apple по состоянию на октябрь 2026 г., со скоростями памяти, указанными в протестированных нами системах.
Каждая система использует свой собственный рецепт
Мы запускаем каждую модель по рецепту, выбранному для каждой системы, используя опубликованный поставщиком рецепт, если он существует, поэтому время выполнения, спекулятивное декодирование и 4-битный весовой формат различаются в зависимости от системы. Ноутбук RTX Spark использует рецепты NVIDIA llama.cpp для RTX Spark, портированные в AA-AgentPerf-Local с настройками NVIDIA.
| Квен3.8 27Б | Время выполнения | Веса | Спекулятивное декодирование |
|---|---|---|---|
| Ноутбук RTX Spark | лама.cpp, Windows | УД-Q4_K_M | DFlash, 7 жетонов драфта |
| ДГХ Спарк | лама.cpp, Linux | УД-Q4_K_M | DFlash, 7 жетонов драфта |
| Макбук Про (М5 Про) | лама.cpp, macOS | Q4_K_M | MTP, 4 жетона драфта |
| AMD Ryzen AI Halo | лама.cpp, Linux | Q4_K_M | MTP, 2 жетона драфта |
| GeForce RTX 5090 для настольных компьютеров | лама.cpp, Linux | Q4_K_M | MTP, 2 жетона драфта |
Рецепт самого быстрого результата Qwen3.8 27B для каждой системы
Мы также тестируем больше весовых форматов и сред выполнения, включая меньшие 4-битные форматы, такие как IQ4_XS и Splash от Inco AI, движок Metal для Apple Silicon, который использует спекулятивное декодирование DFlash. Мы добавим их результаты, как только они пройдут нашу проверку точности, которую вскоре опубликуем. Ранние тесты показывают более быстрое время завершения в некоторых системах.
Ноутбук RTX Spark выполняет рабочую нагрузку за 8–19 минут, в зависимости от модели.
Время завершения по модели и системе
Общее время, необходимое системе для ответа на каждый этап записанных задач агента рабочей нагрузки. Ходы отправляются по одному, каждый с данным разговором, и модель генерирует то же количество токенов, что и в исходной записи, поэтому каждая система выполняет одинаковую работу. Время, потраченное на работу с инструментами, не учитывается.
Qwen3.6 35B A3B, активирующая 3B параметров на каждый токен, является самой быстрой моделью в каждой системе, а ноутбук RTX Spark завершает ее за 7,6 минут против 15,3 для Ling 3.0 Flash и 18,7 для плотного Qwen3.8 27B. Настольный ПК GeForce RTX 5090 — самая быстрая система среди всех моделей, умещающихся в 32 ГБ.
Время завершения | Qwen3.8 27B (Xhigh)
Время завершения и цена | Qwen3.8 27B (Xhigh)
Приблизительная текущая цена в долларах США по состоянию на октябрь 2026 года. По этой цене указаны системы, которые все еще продаются на момент запуска по рекомендованной розничной цене. Цена видеокарты равна стоимости самой карты плюс 2500 долларов США (произвольная оценка) за остальную часть системы. Введите свои собственные цены, чтобы отразить доступные для вас цены.
- Сравните каждую систему и модель на