Первые результаты AA-AgentPerf: аппаратный бенчмарк для агентских вычислений
Как серверное оборудование справляется с тысячами параллельных вызовов агентов: пропускная способность и задержки.
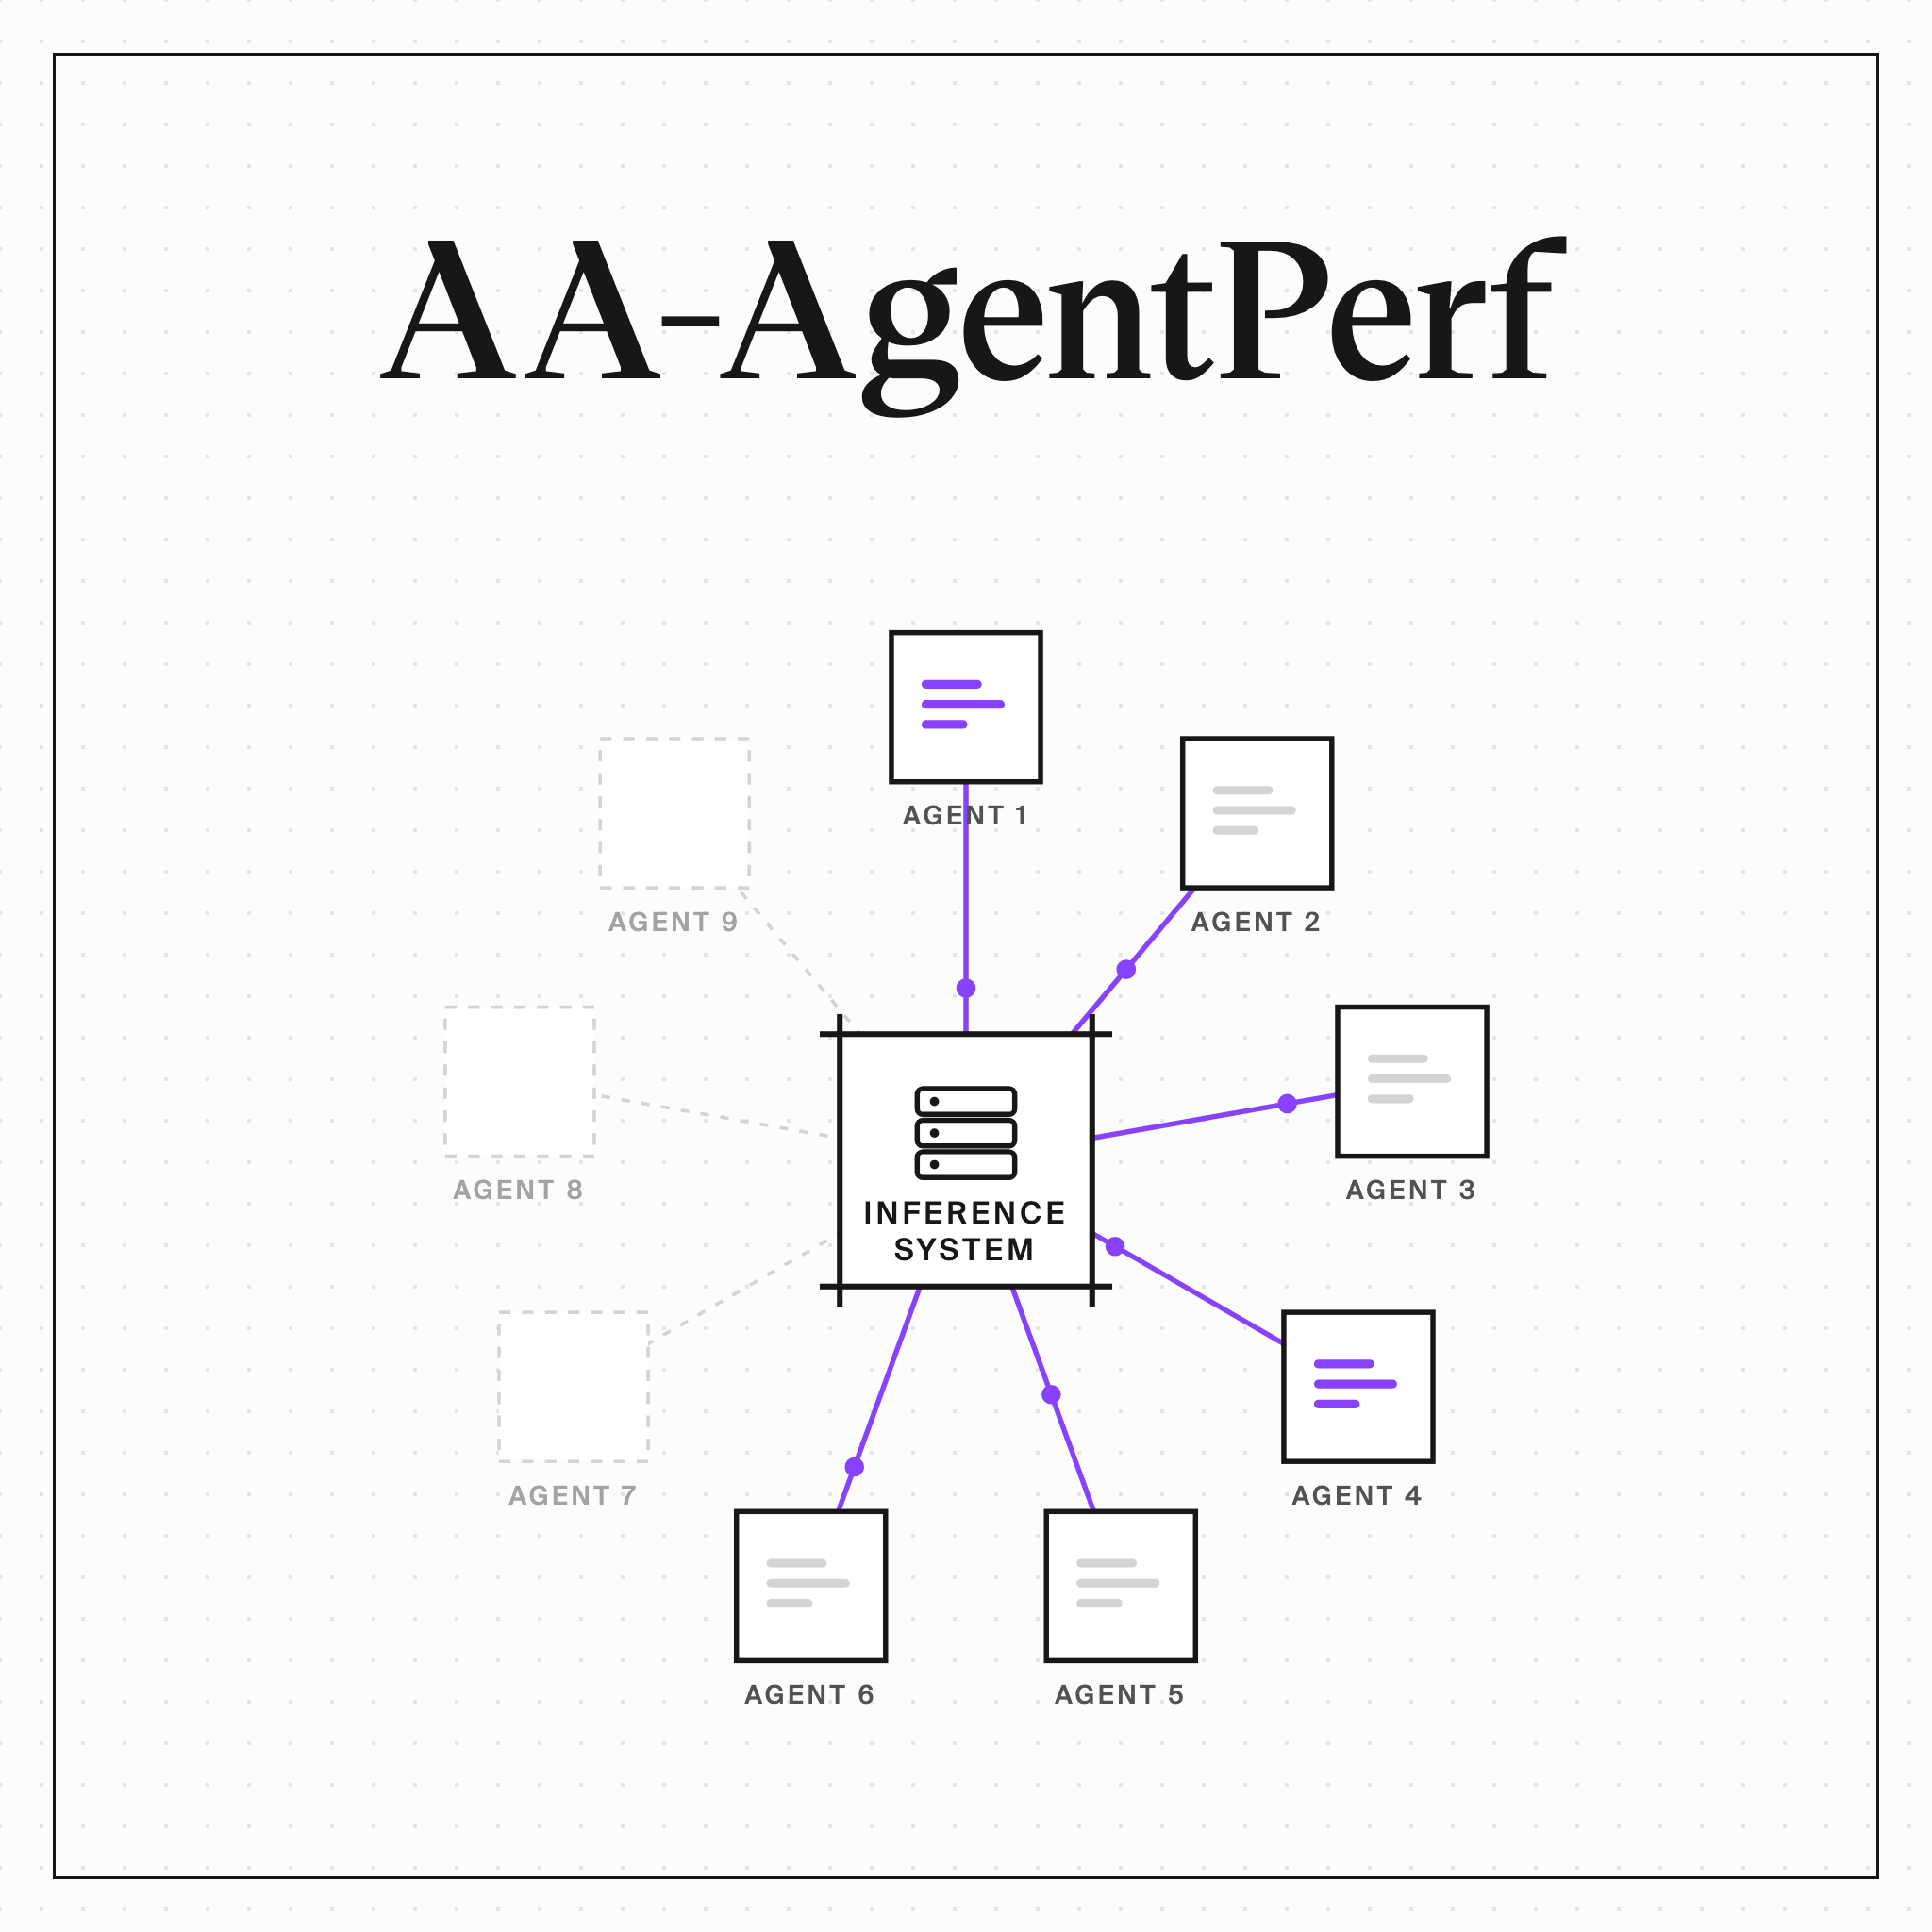
AA-AgentPerf — это первый тест агентного вывода: он воспроизводит реальные траектории кодирования агента и измеряет, сколько одновременно агентов может обслуживать система, одновременно достигая целевых показателей уровня обслуживания. Его опережающим показателем является количество агентов на мегаватт, максимальное количество агентов, обслуживаемых платформой ускорителя на каждый мегаватт мощности. Это самый важный показатель для развития ИИ в мире с ограниченной властью. По первым результатам лидируют системы NVIDIA Blackwell, демонстрируя значительный скачок поколений над Hopper. Преимущества масштабирования и дезагрегированного вывода развертываний в масштабе стойки также очевидны как с точки зрения вычислений, так и энергоэффективности.
Эталон эпохи агентов
Преобладающая рабочая нагрузка ИИ в 2026 году совсем не похожа на те тесты, для которых были созданы тесты вывода рабочих нагрузок. Агенты кодирования выполняют сотни ходов, чередуют рассуждения с вызовами инструментов и редактированием кода и регулярно переносят контексты за пределы 100 000 токенов. Их хорошее обслуживание — это другая инженерная задача, чем обслуживание чата: длинные общие префиксы вознаграждают за повторное использование кэша KV, всплески коротких выходных данных нагружают планировщики, а пользователи по-прежнему ожидают отзывчивой интерактивной скорости.
Большинство аппаратных тестов по-прежнему измеряют синтетические запросы при фиксированной длине входных и выходных данных, при этом в производственных развертываниях оптимизация отключена. То количество, которое на самом деле нужно покупателям — сколько агентов может обслуживать эта система, чтобы пользователи могли ее принять? — никогда не появляется. А в мире, где возможности ИИ все больше ограничиваются доступной мощностью и стоимостью энергии, этот вопрос имеет знаменатель. Ведущий показатель AA-AgentPerf, «Агентов на мегаватт», измеряет, сколько одновременно агентов может поддерживать система на мегаватт измеренной мощности, в пределах выходной скорости каждого агента и целевого времени до первого токена.
AA-AgentPerf — первый тест агентного вывода. Он воспроизводит реальные траектории кодирующего агента на тестируемой системе и находит максимальное количество одновременно работающих агентов, которое система может поддерживать при достижении рыночных целевых показателей производительности. Он был сформирован в результате года работы с поставщиками логических выводов, компаниями-ускорителями искусственного интеллекта, разработчиками и корпоративными покупателями. Он призван стать незаменимым ресурсом для всех, кто покупает или арендует оборудование искусственного интеллекта для агентных рабочих нагрузок.
Реальные траектории кодирующего агента
Каждый смоделированный агент в AA-AgentPerf работает по реальной траектории кодирования-агента, созданной агентами, решающими проблемы в общедоступных репозиториях кода с использованием моделей верхних открытых весов с включенным рассуждением. Сеансы длятся до 200 ходов и достигают длины последовательности, превышающей 100 000 токенов
- Длина входных данных варьируется от ~5 000 до 131 000 токенов на запрос, в среднем около 27 000, что определяется выходными данными инструмента и накопленной историей, а не самим приглашением.
- Длина выходных данных сильно различается в зависимости от хода: агенты в основном производят короткие вызовы инструментов и правки, перемежающиеся более длинными рассуждениями.
- Представлено более 12 языков программирования на основе основного языка исходного репозитория.
- Набор тестов остается конфиденциальным. Участники получают репрезентативный набор настроек для проверки конфигурации; полный набор данных сохраняется, чтобы предотвратить оптимизацию, ориентированную на контрольные показатели.
Предыдущие ходы обслуживались из кэша KV — предварительно заполняются только новые токены
Ход 0/16 · Контекст: 0 тыс. жетонов
Иллюстративный сеанс — структура хода и количество токенов, смоделированные на основе набора данных AA-AgentPerf (входные токены 1–131 тыс., в среднем ~ 27 тыс. · медианные выходные данные ~ 150 токенов, P95 ~ 2 тыс.)
Именно эта форма делает работу агента сложной и чего полностью не хватает синтетическим тестам одинаковой длины. Результаты инструмента раздувают контекст, выходные данные часто составляют всего несколько сотен токенов, и один и тот же префикс возвращается шаг за шагом. Поведение KV-кэша системы, планировщик и иерархия памяти определяют, будет ли она процветать или разрушаться в соответствии с этим шаблоном.
Измерение современного производственного комплекса
AA-AgentPerf — это первый эталонный тест вывода, который позволяет проводить оптимизации, которые лаборатории и поставщики логических выводов фактически используют в производстве: повторное использование кэша KV, спекулятивное декодирование и дезагрегированное предварительное заполнение/декодирование. Тесты, которые их отключают, измеряют стиль развертывания, который никто не поставляет. Разрешение им позволяет понять, как должно выглядеть реальное развертывание. Это также делает AA-AgentPerf инструментом для понимания влияния каждого нового усовершенствования программного и аппаратного обеспечения, а не только каждого нового чипа. Проверка точности контролирует потерю качества, поэтому оптимизация не может купить мощность за счет качества вывода.
Возможность оптимизации производства делает конфигурацию обслуживания первоклассной частью эталонного теста. Пространство решений для обслуживания модели в конкретной системе широко — структура вывода и версия, стратегия параллелизма, настройка спекулятивного декодирования, топология дезагрегации и десятки решений по настройке — и оно движется быстро: с момента выпуска DeepSeek V4 Pro мы наблюдаем улучшение конфигураций обслуживания для него почти ежедневно.
Цифры в этой первоначальной версии AA-AgentPerf следует рассматривать как снимок быстро меняющегося рубежа, как и другие результаты сравнительного тестирования производительности в реальном времени, представленные в журнале AI Стата. Это реальные результаты, которые отражают производительность, достижимую сегодня с раскрытыми конфигурациями, но мы предупреждаем, что потенциально доступен переменный объем запаса для повышения производительности в каждой системе, и мы ожидаем, что результаты будут расти по мере поступления дальнейших предложений от поставщиков. В частности, этот запас может быть больше для MI355X и H200, поскольку их конфигурации были представлены командой искусственного анализа, а не командой поставщика.
Емкость на реальных уровнях обслуживания
Пиковую пропускную способность легко увеличить: увеличивайте параллелизм до тех пор, пока каждый агент не будет сканировать данные. Вместо этого AA-AgentPerf фиксирует уровень обслуживания и спрашивает, насколько далеко система может масштабироваться, сохраняя ее. Целевые показатели производительности определяются на основе данных сравнительного анализа бессерверных API искусственного анализа — уровней обслуживания, которые фактически существуют сегодня на рынке. Скорость и задержка измеряются для каждого запроса: скорость вывода P25 и время получения первого токена P95, вычисляемые для всех запросов на этапе тестирования.
Уровни уровня обслуживания при запуске
DeepSeek V4 Pro (макс.)
Уровень 1
20 токенов/с
P95 ТТФТ ≤ 10 с
Уровень 2
60 токенов/с
P95 ТТФТ ≤ 5 с
Уровень 3
180 токенов/с
P95 ТТФТ ≤ 3 с
gpt-oss-120b (высокий) Скоро
100 токенов/с
250 токенов/с
500 токенов/с
P95 ТТФТ ≤ 2 с
Уровень 4
2000 токенов/с
P95 ТТФТ ≤ 1 с
8 агентов поддерживают скорость ≥ 300 токенов/с каждый
Для каждого уровня экспоненциальное линейное изменение, за которым следует двоичный поиск, определяет максимальный параллелизм, который поддерживает система без нарушения целевых показателей, при этом метрики вычисляются в устойчивых окнах, в которых все агенты были активны в течение как минимум 30 секунд.
| Фаза | Агенты | стр. 25 Скорость | Результат |
|---|
Что показывают первые результаты
Первая волна результатов охватывает системы NVIDIA и AMD под управлением DeepSeek V4 Pro, измеренные от одиночных ускорителей до полных стоек, за которыми последуют результаты gpt-oss-120b. Обращают на себя внимание три вывода
Стеллажные весы показывают свою эффективность
Присущие преимущества масштаба и способность агрессивно дезагрегировать логические выводы приводят к явному выигрышу в чистых вычислениях и количестве агентов на мегаватт по сравнению с одним узлом.
Скачок поколений
Переход от Hopper к Blackwell приводит к резкому изменению количества одновременных агентов, которые может поддерживать система, с точки зрения общей мощности и количества агентов на мегаватт.
Реальная оптимизация имеет решающее значение
Тестирование с использованием различных оптимизаций ядра и дизайнов обслуживающих конфигураций значительно улучшило результаты, что усилило необходимость оптимизации всего стека.
Каждый приведенный ниже результат нормирован для каждого ускорителя, системы и мегаватта, поэтому можно справедливо сравнивать системы самых разных размеров. Показатели на мегаватт рассчитаны на основе измеренной мощности ускорителя под нагрузкой, а не номинальной расчетной тепловой мощности (TDP).
Обратите внимание: учитывая, что оптимизация ядра и разработка конфигурации для DeepSeek V4 Pro в системах AMD находятся в зачаточном состоянии, мы ожидаем значительного улучшения производительности AMD в ближайшем будущем. Мы с нетерпением ждем возможности сотрудничать со всеми поставщиками для измерения их улучшения производительности с течением времени.
Изучите результаты DeepSeek V4 Pro
Данные для DeepSeek V4 Pro скоро будут обновлены до того же формата, что и для Kimi K3.
Максимальное количество одновременных агентов на МВт мощности ускорителя | DeepSeek V4 Pro 0424 (Макс.)
Значения нормализованы по потребляемой мощности графического процессора в мегаваттах на основе измеренной мощности только графического процессора (кристалл графического процессора плюс HBM, без учета затрат на процессоры, сеть и охлаждение).
Живой тест, открытый для подачи заявок
Что дальше
AA-AgentPerf будет постоянно обновляться. Планируемые расширения включают в себя
- Более длинные контексты — расширение траекторий до 1 миллиона токенов.
- Более широкий охват моделей — результаты gpt-oss-120b для всех представленных систем, а также дополнительные модели.
- Более широкий охват аппаратного обеспечения — результаты для большего количества систем NVIDIA и AMD, а также дополнительных архитектур ускорителей.
- Производительность выполнения инструментов — тестирование производительности ЦП при выполнении вызовов инструментов агента в рамках теста.
- Результаты с течением времени — отслеживание того, как улучшаются показатели каждой системы по мере развития конфигураций обслуживания и инфраструктур.
- Более глубокий анализ экономики и ценообразования токенов, включая пропускную способность агентов на доллар США/час стоимости аренды, стоимость задачи и общую стоимость владения.
Идите глубже
- Методология AA-AgentPerf подробно документирует набор данных, уровни обслуживания, выполнение тестов и метрики.
- Браузер конфигураций отображает полную конфигурацию обслуживания для каждого опубликованного результата.
- Материалы.