OpenBMB выпустила компактную MiniCPM5-2B с выдающимся качеством
Модель весом всего 2 миллиарда параметров превосходит многие системы 7B-13B на стандартных академических тестах.
OpenBMB — это группа искусственного интеллекта с открытым исходным кодом, стоящая за серией эффективных небольших моделей MiniCPM. MiniCPM5-2B — это модель рассуждений с плотностью 2,6 млрд параметров и текстовым вводом и выводом, выпущенная под Apache 2.0.
Набрав 15 баллов по индексу интеллекта, MiniCPM5-2B отстает на одно очко от Ling 3.0 Tiny (16), у которого общие параметры примерно в три раза выше. Среди моделей с открытыми грузами по общим параметрам 4Б следующий лучший результат - Гранит 4,2 3Б (11).
Ключевые результаты:
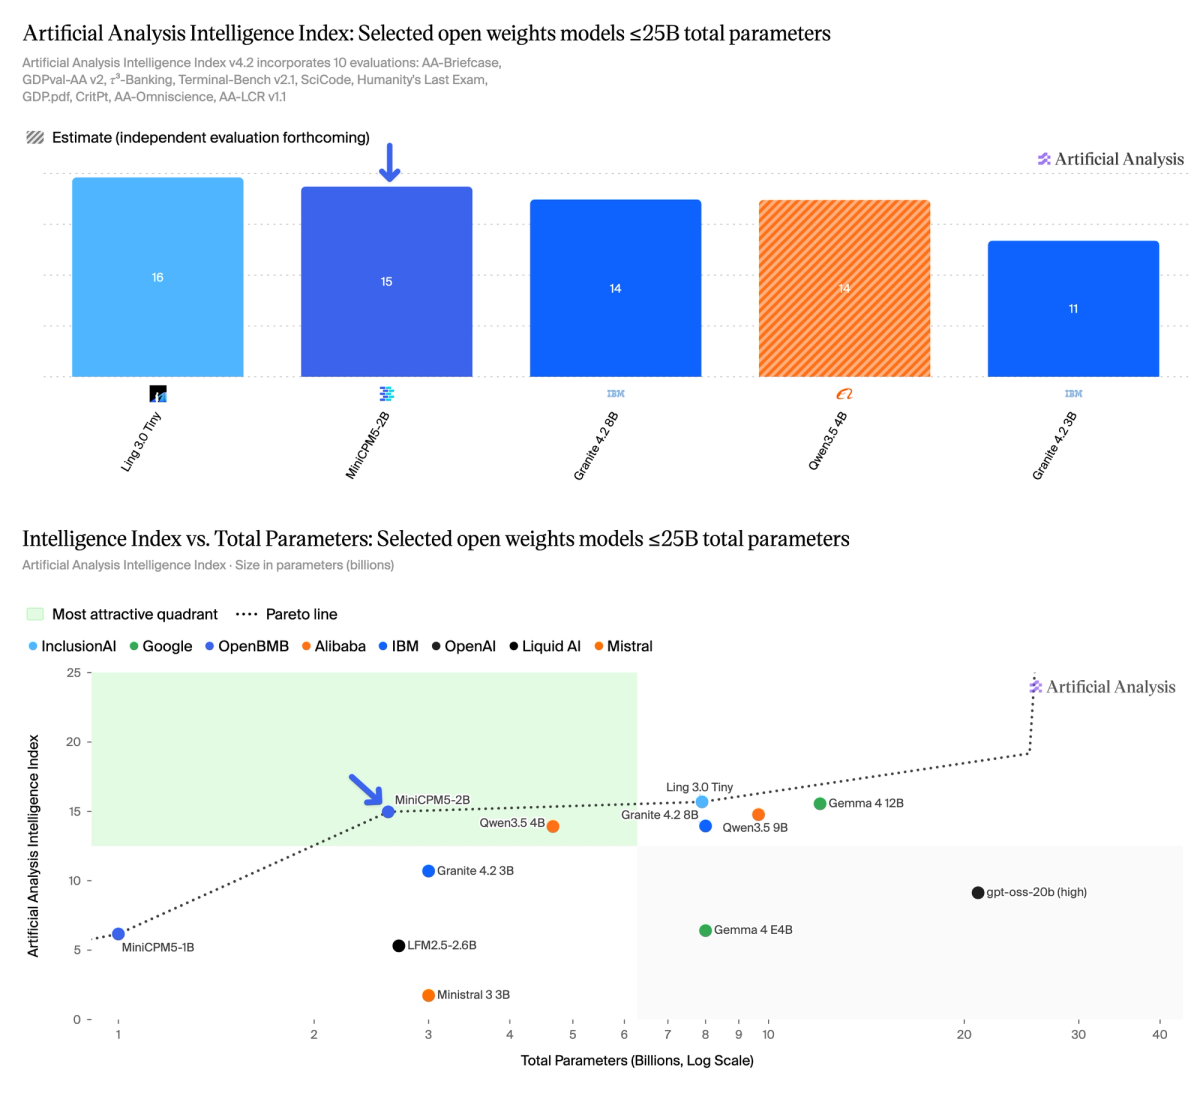
➤ Самый высокий индекс интеллекта среди всех моделей с открытыми весами при общих параметрах 4B, устанавливающий новую оптимальную по Парето точку для интеллекта по сравнению с общими параметрами: ее оценка 15 на 4 балла выше, чем у Granite 4.2 3B (11). При общем количестве параметров 2,6B он на 1 пункт опережает Qwen3.5 4B (Рассуждение, 14, оценка) с на 44% меньшим количеством параметров и находится на одном уровне с Qwen3.5 9B (Рассуждение, 15, оценка) примерно в 4 раза больше его размера. Поскольку модель является плотной, ее преимущество в размере заключается в объеме памяти, а не в вычислении активных параметров.
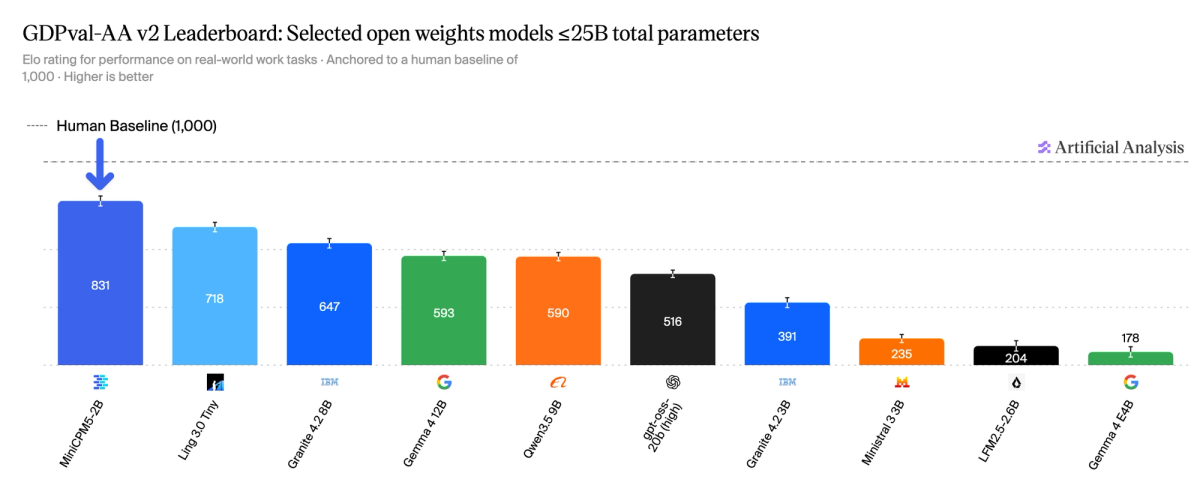
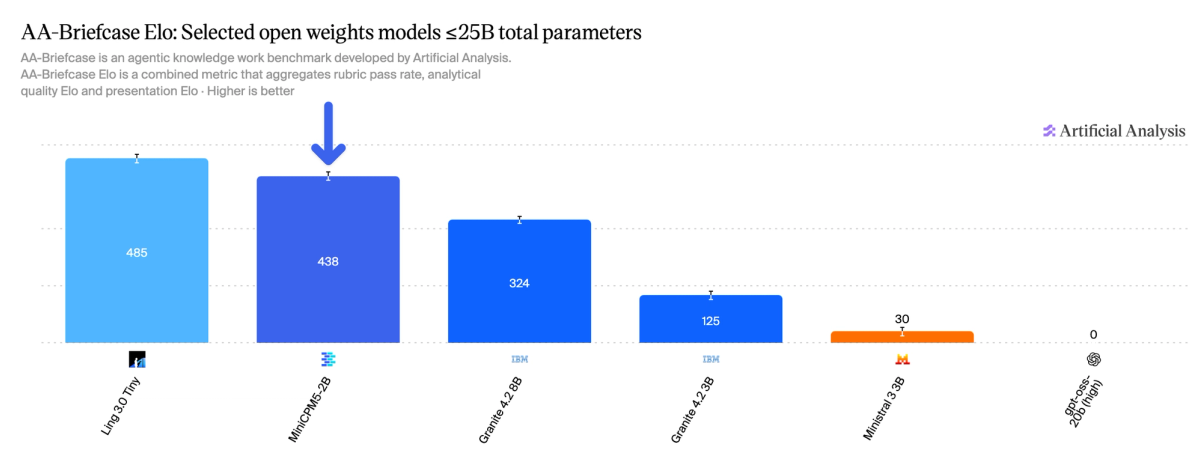
➤ Высокая агентская производительность при таком размере: ее GDPval-AA v2 Elo из 831 опережает модели <4B, а по τ³-Banking она занимает первое место с Ling 3.0 Tiny с показателем 21% по сравнению с 8% у следующей лучшей модели Granite 4.2 8B. В рейтинге AA-Briefcase он занял второе место среди измеренных моделей в наборе сравнения с Elo 438, выше Granite 4.2 8B (324) и чуть ниже Ling 3.0 Tiny (485).
➤ Знания, кодирование и длительный контекст — вот где это дает основание. MiniCPM5-2B занимает 7-е место в наборе на Humanity's Last Exam (9%, позади Gemma 4 12B (Рассуждение) с 16%), 8-е место на Terminal-Bench v2.1 (9%, позади Qwen3.5 9B (Рассуждение) с 29%) и набирает 0% на CritPt. На SciCode это вторая из пяти измеренных моделей с показателем 26%, уступая Granite 4.2 8B (31%). На AA-LCR v1.1 он набирает 59%, занимает 5-е место в наборе, отставая на одно очко от Ling 3.0 Tiny (60%). В GDP.pdf, нашей новой профессиональной оценке обоснования документов, он полностью проходит 1% задач, уступая gpt-oss-20b (высокий) на 2%.
➤ Оценка АА-Всеведения -12 достигается за воздержание от ответа, а не за точность. MiniCPM5-2B пытается ответить только на 29% вопросов АА-Всеведение, что дает ему показатель отсутствия галлюцинаций 78%. Его точность в 8% — это на один пункт ниже Ling 3.0 Tiny (9%) и вдвое меньше, чем у Qwen3.5 9B (Рассуждение, 16%). Сверстники, которые пытаются задать гораздо больше вопросов, подвергаются серьезным штрафам: Qwen3.5 9B (Рассуждение) - -53, а gpt-oss-20b (высокий) - -63.
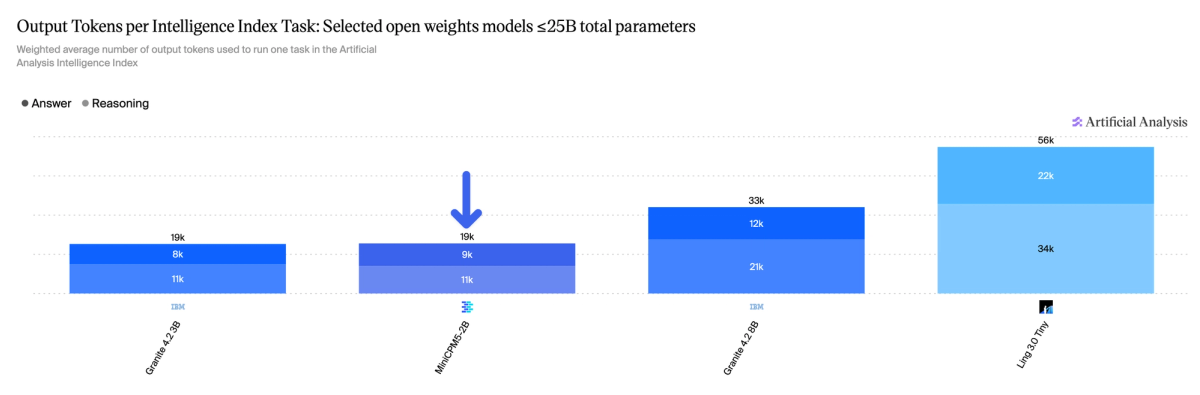
➤ Это эффективно для модели рассуждения. MiniCPM5-2B использовал 19 тысяч выходных токенов для каждой задачи индекса интеллекта, что является самым низким показателем в наборе моделей сравнения с Granite 4.2 3B (19 тысяч). Ling 3.0 Tiny тратит 56 тыс., примерно в 3 раза больше, на 1 дополнительный индексный пункт.
Дополнительные сведения о модели:
➤ Параметры: 2,6В (плотная)
➤ Контекстное окно: 131 тыс. токенов
➤ Способы ввода: только текст
➤ Лицензия: Apache 2.0.
Агентские возможности являются преимуществом MiniCPM5-2B при таком размере. В AA-Briefcase, нашей оценке агентской информационной работы, его Эло, равное 438, является вторым в наборе после Ling 3.0 Tiny (485) и опережает Granite 4.2 8B (324). Агентический индекс представляет собой средневзвешенное значение трех агентских оценок в Индексе интеллекта: AA-Портфель, GDPval-AA v2 и τ³-Banking.
На GDPval-AA v2, который тестирует модели на реальных рабочих задачах с базовым уровнем человека 1000, MiniCPM5-2B достигает Elo 831, что примерно на 110 пунктов опережает Ling 3.0 Tiny (718) и примерно на 180 пунктов опережает Granite 4.2 8B (647). Модели этого масштаба обычно располагаются намного ниже: LFM2,5-2,6B на уровне 204 и Gemma 4 E4B (Рассуждение) на уровне 178.
MiniCPM5-2B также эффективно использует токены для модели рассуждения. Он использует 19 тысяч выходных жетонов для каждой задачи индекса искусственного анализа интеллекта, из них 11 тысяч токенов рассуждения, против 56 тысяч для Ling 3.0 Tiny и 33 тысяч для Granite 4.2 8B. Использование выходных токенов имеет значение для развертываний на устройстве и на периферии, на которые нацелена модель 2.6B.
Полные результаты оценок индекса искусственного интеллекта. Стрелки сравнивают MiniCPM5-1B (Рассуждение) с MiniCPM5-2B, где оба имеют результаты; в противном случае они выделяют MiniCPM5-2B.
MiniCPM5-2B набрал 23 балла в недавно обновленном индексе искусственного анализа интеллекта v4.1.1. Новая оценка в 15 баллов для версии 4.2 отражает обновленный набор оценок и весов, а оценки в двух версиях напрямую не сопоставимы.