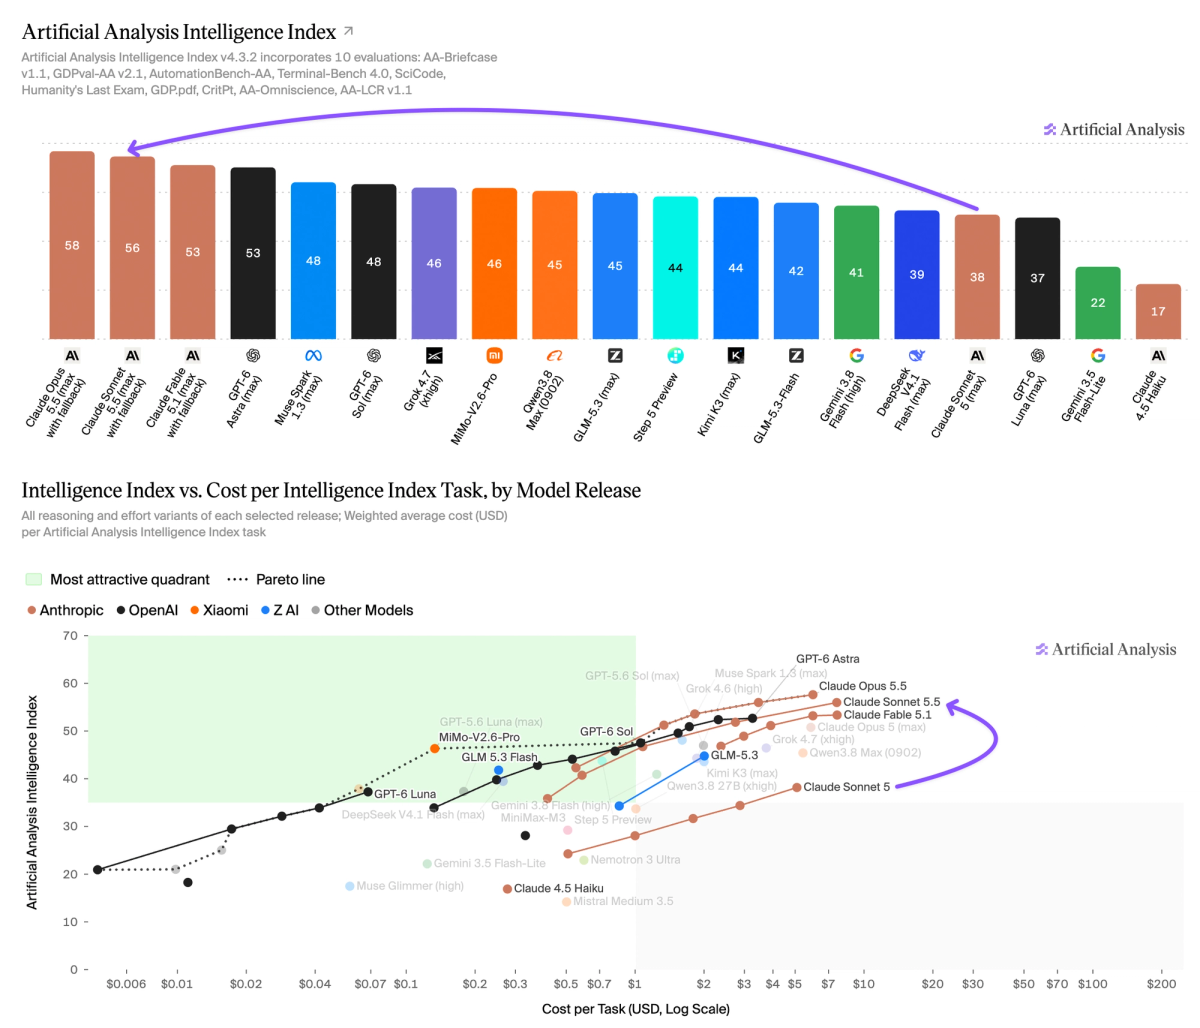
Claude Sonnet 5.5 занял 2-е место в Индексе интеллекта AI Стата
Sonnet 5.5 сочетает передовой кодинг и агентские рассуждения с высокой скоростью генерации токенов.
При максимальных усилиях Сонет 5.5 набирает 18 баллов по сравнению с Сонетом 5 и перемещается на 2-е место в Индексе интеллекта, уступая только Опусу 5.5 (макс.). Anthropic установила цену Sonnet 5.5 идентично Sonnet 5: 0,2/2/10 долларов США за 1 М токенов ввода/ввода/вывода кэша. Однако он выдает большее количество токенов вывода за задачу и стоит 7,60 долларов США за задачу (примерно на 50 % выше, чем стоимость задачи в Сонете 5).
Ключевые выводы
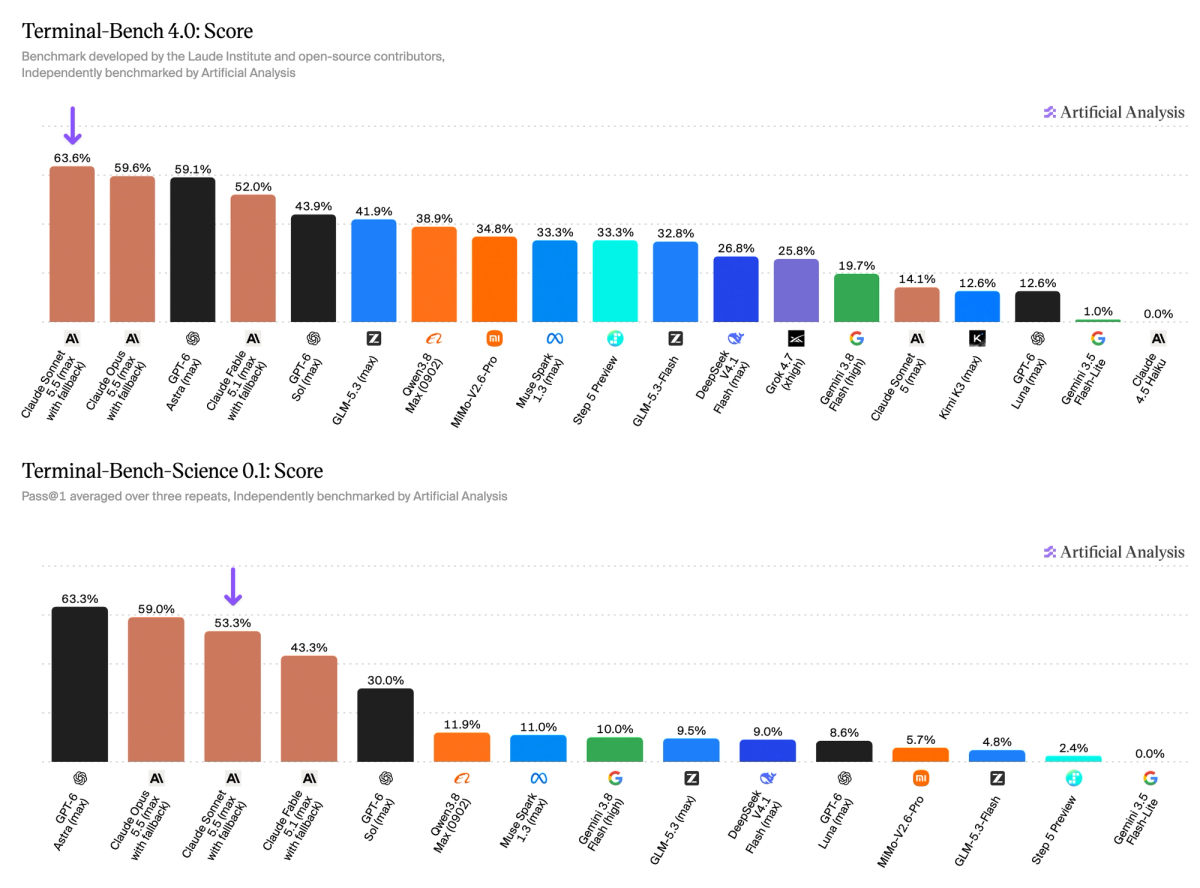
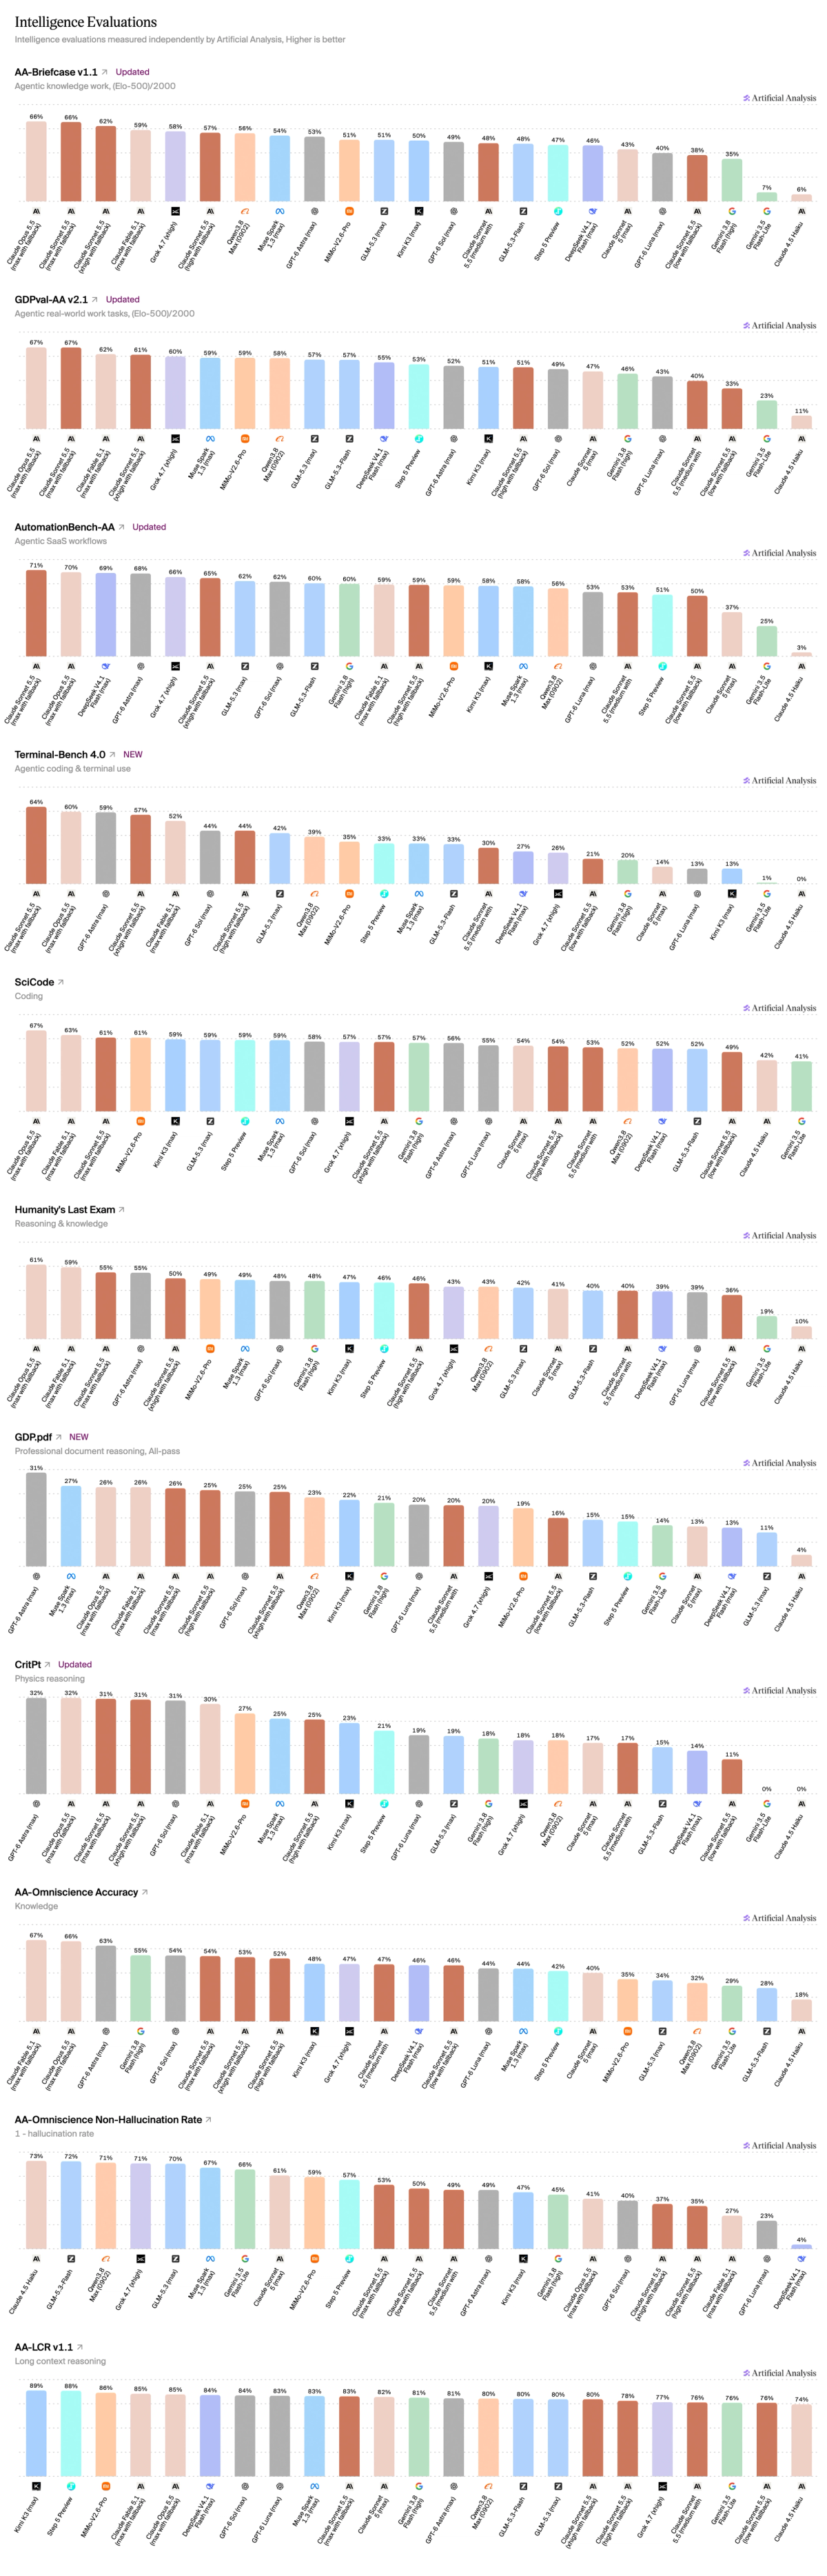
➤ Соответствует ведущим моделям использования агентских терминалов и информационной работы: в Terminal-Bench 4.0 Claude Sonnet 5.5 достигает 64% против 60% для Opus 5.5 и GPT-6 Astra. На AA-Briefcase (1811 против 1822 Elo), GDPval-AA (1844 против 1846 Elo) и AutomationBench-AA (71% против 70% баллов по заголовку) Sonnet 5.5 достигает паритета с Opus 5.5, хотя для этого используется значительно больше токенов.
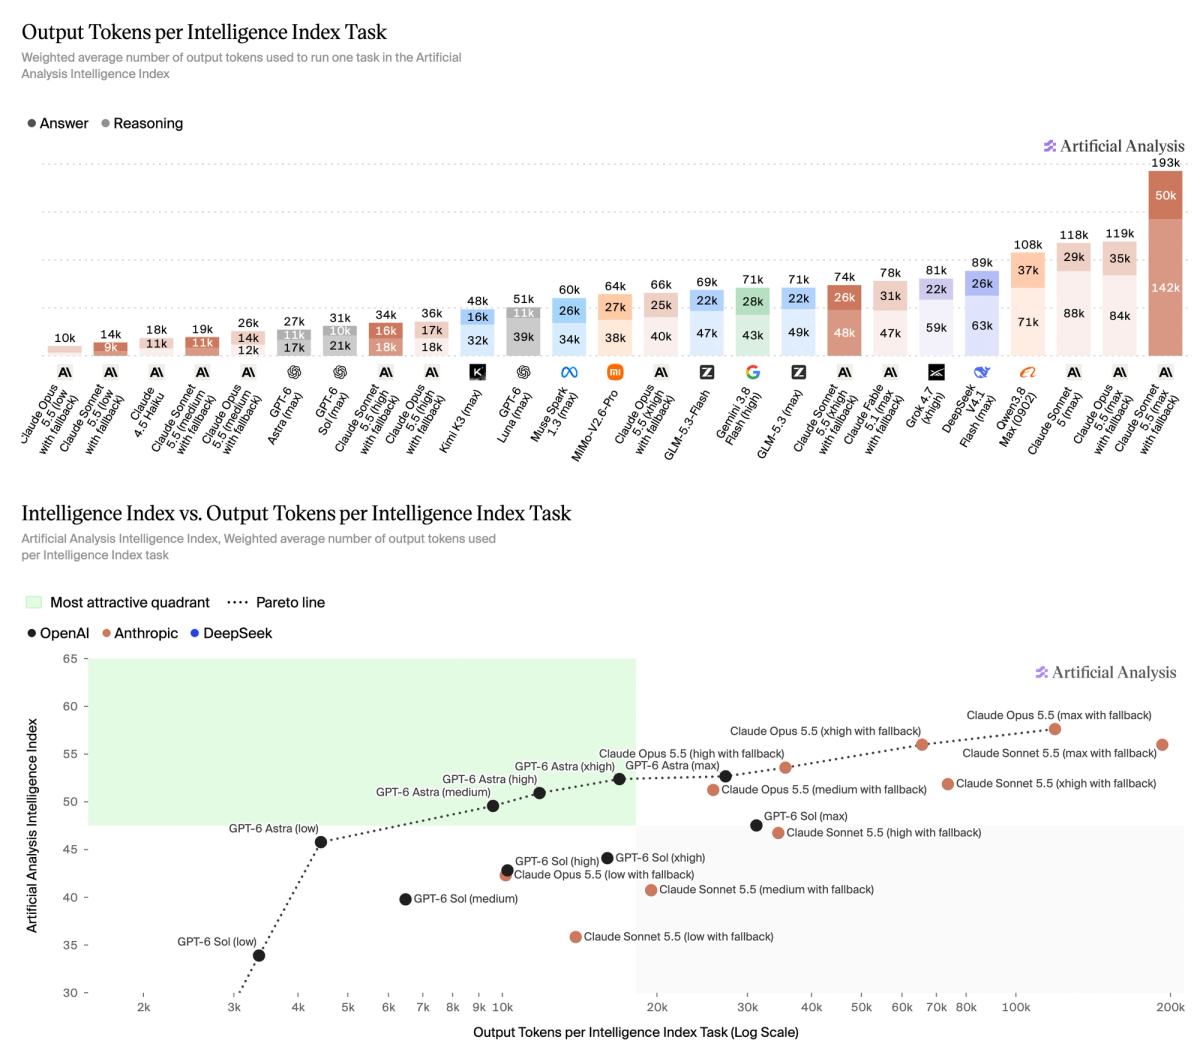
➤ Самое интенсивное использование токенов, которое мы измерили: при максимальных усилиях, когда производительность приближается к Opus 5.5, Claude Sonnet 5.5 использовал ~ 193 тыс. выходных токенов на задачу индекса интеллекта. Это самый высокий показатель использования токенов, который мы измерили, примерно на 60 % выше, чем у Opus 5.5 (максимум) или Sonnet 5 (максимум) и примерно в 7 раз GPT-6 Astra (максимум).
➤ Цены остаются на уровне 2/10 долларов США за миллион токенов ввода/вывода, что соответствует GPT-6 Sol: при этой цене Claude Sonnet 5.5 выходит за пределы границы Парето интеллекта и стоимости за задачу. При высоких уровнях нагрузки он отстает от Opus 5.5, тогда как при более низких нагрузках используются конфигурации GPT-6 Astra или Sol, обеспечивающие эквивалентную производительность за меньшую цену. Настройка «Высокие усилия» является наиболее конкурентоспособной по этому признаку, она очень уступает GPT-6 Sol по интеллекту при той же цене за задачу.
➤ По сравнению с Опусом 5.5 по фактическому знанию и научным рассуждениям: Будучи моделью меньшего класса, Сонет 5.5 все еще отстает по фактическому знанию в Всеведении АА по сравнению с Опусом 5.5. Он набирает 54% против 66% по фактической точности, хотя и с более низким уровнем галлюцинаций (47% против 59%). Он также на 6 баллов ниже по тестам Humanity's Last Exam и SciCode по сравнению с Opus.
Эти оценки проводились на предварительной версии Claude Sonnet 5.5, в которой Anthropic обнаружила ошибку, которая может ухудшить качество ответов на запросы, использующие структурированные выходные данные. В общедоступной версии это исправлено, и Anthropic ожидает минимальных изменений или слегка заниженной производительности, но вскоре мы проведем повторные оценки.
Другие детали модели
➤ Контекстное окно: 1 миллион токенов с вводом изображений и текста, без изменений по сравнению с Sonnet 5.
➤ Цена: не изменилась по сравнению с последней версией Sonnet 5: 2/10 долларов США за 1 миллион токенов ввода/вывода; кеш записывает по $2,5, кеш читает $0,2
➤ Настройки усилия: пять (низкое, среднее, высокое, высокое, максимальное). Оценки индекса интеллекта проводились на всех пяти с включенным резервным вариантом Anthropic по умолчанию. Мы видим, что Sonnet 5.5 откатывается примерно в 0,1% задач по индексу интеллекта, в основном в Terminal-Bench 4.0, во всех случаях откатываясь к Sonnet 5.
Claude Sonnet 5.5 (max) добился больших успехов в Terminal-Bench, входя в число лучших моделей как для Terminal-Bench 4.0, так и для Terminal-Bench-Science. В Terminal-Bench 4.0 он набирает 64%, что на 50 пунктов больше, чем у Claude Sonnet 5 (максимум), и чуть выше 60% для Opus 5.5 и GPT-6 Astra (xhigh).
Для достижения невероятной производительности Claude Sonnet 5.5 (макс.) использует ~193 тыс. выходных токенов для каждой задачи индекса интеллекта, что является максимальным показателем, который мы измерили, и примерно в 7 раз больше, чем у GPT-6 Astra (макс.).
Однако его настройки с меньшими усилиями охватывают более широкую область компромиссов между интеллектом и жетонами вывода на задачу, при этом настройки низкого, среднего и высокого усилия находятся за высокими, xвысокими и максимальными усилиями GPT-6 Sol. В этой области Sol обеспечивает более высокую производительность при меньшем количестве выходных токенов.
Полная разбивка отдельных оценок в Индексе интеллекта искусственного анализа для Claude Sonnet 5.5 по всем рассуждениям