Claude Opus 4.7: характеристики, бенчмарки и всё, что нужно знать
Полный обзор возможностей предыдущего флагмана Anthropic: тесты скорости, цены и качества рассуждений.

Claude Opus 4.7 занимает первое место в рейтинге искусственного анализа интеллекта с GPT-5.4 и Gemini 3.1 Pro и возглавляет GDPval-AA, наш основной эталон общих агентских возможностей.
Клод Опус 4.7 набрал 57 баллов по Индексу интеллекта искусственного анализа, что на 4 балла выше, чем у Опуса 4.6 (Адаптивное мышление, максимальное усилие, 53).
Это приводит к величайшей ничьей в истории искусственного анализа: теперь у нас есть три лучшие передовые лаборатории, которые занимают равные первые места.
Anthropic лидирует в сфере реальной агентской работы, опережая GDPval-AA, наш основной агентский эталон, измеряющий производительность в 44 профессиях и 9 основных отраслях. Google лидирует по знаниям и научным рассуждениям, опережая HLE, GPQA Diamond, SciCode, IFBench и AA-Omniscience. OpenAI лидирует в области долгосрочного кодирования и научных рассуждений, опережая TerminalBench Hard, CritPt и AA-LCR.
Мы калибруем наш индекс интеллекта с учетом 95% доверительного интервала +/- 1 балл и округляем значения до ближайшего целого числа. Точная оценка Claude Opus 4.7 (57,3) ставит его на первое место, но мы рекомендуем считать это равенством с Gemini 3.1 Pro (57,2) и GPT-5.4 (56,8).
Все результаты и выводы, приведенные ниже, отражают Опус 4.7, оцененный при максимальном усилии (Адаптивное мышление, Максимальное усилие), что соответствует тому, как мы сообщали об Опусе 4.6.
Ключевые выводы
➤ Opus 4.7 — новый лидер по GDPval-AA, нашему основному показателю общей эффективности агентов при выполнении задач работы с знаниями. Opus 4.7 набрал 1753 балла Эло, что примерно на 79 баллов Эло опережает следующие ближайшие модели, Claude Sonnet 4.6 (Адаптивное мышление, максимальное усилие, 1674) и GPT-5.4 (xhigh, 1674), и на 134 балла Эло опережает Opus 4.6 (Адаптивное мышление, максимальное усилие, 1619). GDPval-AA измеряет производительность при выполнении задач в 44 профессиях и 9 основных отраслях с помощью моделей, использующих доступ к оболочке и просмотр веб-страниц в агентном цикле через Stirrup, наш агентный справочный инструмент с открытым исходным кодом.
➤ Opus 4.7 занимает второе место в Индексе всеведения искусственного анализа (после Gemini 3.1 Pro), что обусловлено, главным образом, уменьшением галлюцинаций, а не более высокой точностью. Opus 4.7 набрал 26 баллов по шкале AA-Всеведение, что на 12 баллов больше, чем у Opus 4.6 (Адаптивное мышление, максимальное усилие, 14), уступая только Gemini 3.1 Pro (33). Частота галлюцинаций Опуса 4.7 упала на 25 п.п. до 36% (против 61% у Opus 4.6 Adaptive), при этом точность осталась неизменной. Опус 4.7 достигает этого за счет более частого воздержания, при этом частота попыток снижается до 70% (по сравнению с 82% для Опуса 4.6).
➤ Opus 4.7 использовал примерно на 35% меньше выходных токенов, чем Opus 4.6, для запуска индекса искусственного анализа интеллекта, несмотря на то, что он набрал на 4 балла больше. Opus 4.7 использовал 102 млн токенов вывода против 157 млн для Opus 4.6 (адаптивное мышление, максимальное усилие) и меньше, чем GPT-5.4 (xhigh, 121 млн), но больше, чем Gemini 3.1 Pro (57 млн).
➤ По сравнению с Opus 4.6 (Adaptive Reasoning, Max Effort) Opus 4.7 имеет прирост в IFBench (+5,5 п.п.), TerminalBench Hard (+5,3 п.п.), HLE (+2,9 п.п.), SciCode (+2,6 п.п.) и GPQA Diamond (+1,8 п.п.). Мы наблюдали небольшую регрессию в τ²-Bench (-3,5 п.п.) с эквивалентными показателями для LCR и Critpt.
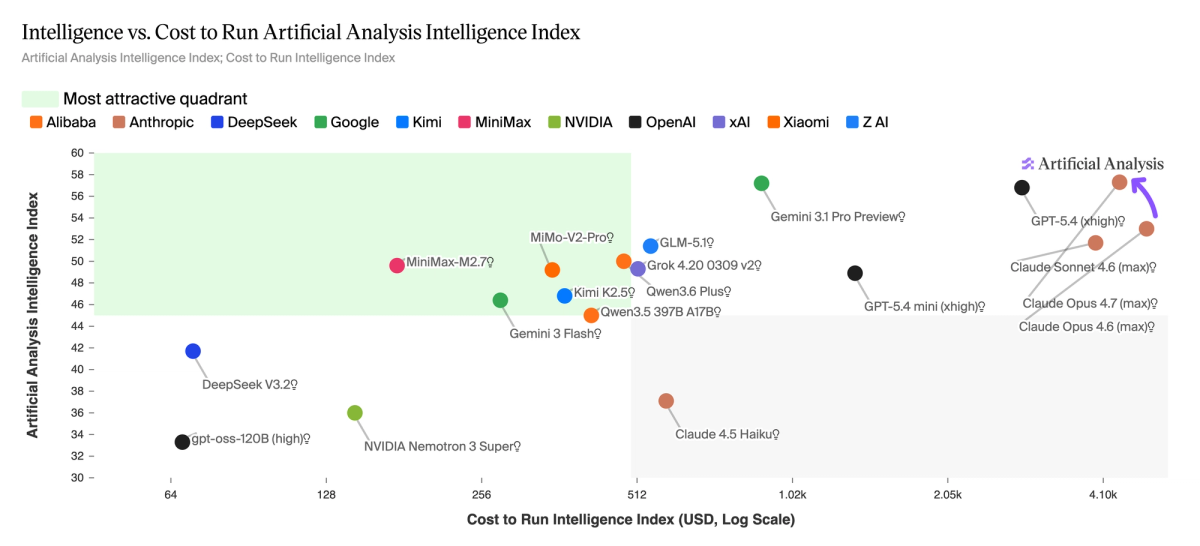
➤ Опус 4.7 (Адаптивное мышление, максимальное усилие) стоит ~4406 долларов США для запуска Индекса искусственного интеллекта, что на ~11 % меньше, чем Опус 4.6 (Адаптивное мышление, максимальное усилие, ~4970 долларов США), несмотря на то, что он набрал на 4 балла больше. Это обусловлено меньшим использованием выходных токенов, даже с учетом нового токенизатора Opus 4.7. Эта метрика не учитывает скидки на кэшированные входные токены, которые мы будем учитывать в наших расчетах затрат в ближайшем будущем.
➤ Стоимость Opus 4.7 идентична ценам Opus 4.6 и Opus 4.5: 5/25 долларов США за 1 миллион токенов ввода/вывода.
Вместе с выпуском Opus 4.7 компания Anthropic внесла несколько изменений в свой API
➤ Opus 4.7 представляет новую настройку усилия рассуждения «xhigh», которая находится между «высоким» и «максимальным». Полный диапазон Opus 4.7 теперь низкий, средний, высокий, xhigh и максимальный. Мы оценили Опус 4.7 при максимальном усилии, что соответствует нашей оценке Опуса 4.6 (Адаптивное мышление, Максимальное усилие).
➤ Opus 4.7 вводит бюджеты задач — бюджет консультативных токенов, охватывающий полный агентский цикл (мышление, вызовы инструментов, результаты инструментов и выходные данные). Модель видит текущий обратный отсчет и использует его для определения приоритетов работы и корректного завершения по мере расходования бюджета. Бюджеты задач находятся в публичной бета-версии Opus 4.7.
➤ Расширенное мышление полностью удалено в Opus 4.7. Адаптивное рассуждение теперь является единственным режимом рассуждения.
Ключевые детали модели
➤ Контекстное окно: токены 1M (без изменений по сравнению с Opus 4.6)
➤ Максимальное количество токенов вывода: 128 тыс. токенов (без изменений по сравнению с Opus 4.6)
➤ Цена: 5/25 долларов США за 1 миллион токенов ввода/вывода (без изменений по сравнению с Opus 4.5 и Opus 4.6).
➤ Доступность: Claude Opus 4.7 доступен через API Anthropic, Amazon Bedrock, Microsoft Azure и Google Vertex. Также доступно в приложениях Claude, Claude Code и Claude Cowork.
Opus 4.7 — новый лидер GDPval-AA, нашего основного эталона общей производительности агентов при выполнении реальных задач, связанных с интеллектуальными работами. Opus 4.7 набрал 1753 Эло, что на 79 Эло опережает следующие ближайшие модели, Sonnet 4.6 (Адаптивное мышление, Максимальное усилие) и GPT-5.4 (xhigh), с 1674 и 1673 Эло.
Опус 4.7 занимает второе место в Индексе всеведения искусственного анализа благодаря значительно меньшему количеству галлюцинаций. Опус 4.7 чаще воздерживается от вопросов, которых он не знает, снижая уровень галлюцинаций с 61% (Опус 4.6 Адаптивный) до 36%, при этом точность практически не меняется.
Opus 4.7 (Адаптивное мышление, максимальное усилие) стоит около 4406 долларов США для запуска Индекса интеллекта искусственного анализа, что на ~ 11% меньше, чем Opus 4.6 (Адаптивное мышление, максимальное усилие, ~ 4970 долларов США), несмотря на то, что он набрал на 4 балла выше. Это обусловлено меньшим использованием выходных токенов, даже с учетом нового токенизатора Opus 4.7.
Разбивка полных результатов по Опусу 4.7 вместе с Опусом 4.6 (Адаптивное мышление, максимальное усилие), Опусом 4.5 (Рассуждение) и ведущими передовыми аналогами