MiniMax M2.7: всё о новой мощной китайской модели
Сверхдлинное контекстное окно и качественная обработка многостраничных документов: тесты MiniMax M2.7.

MiniMax выпустила MiniMax-M2.7, обеспечивающую интеллект уровня GLM-5 менее чем за треть стоимости.
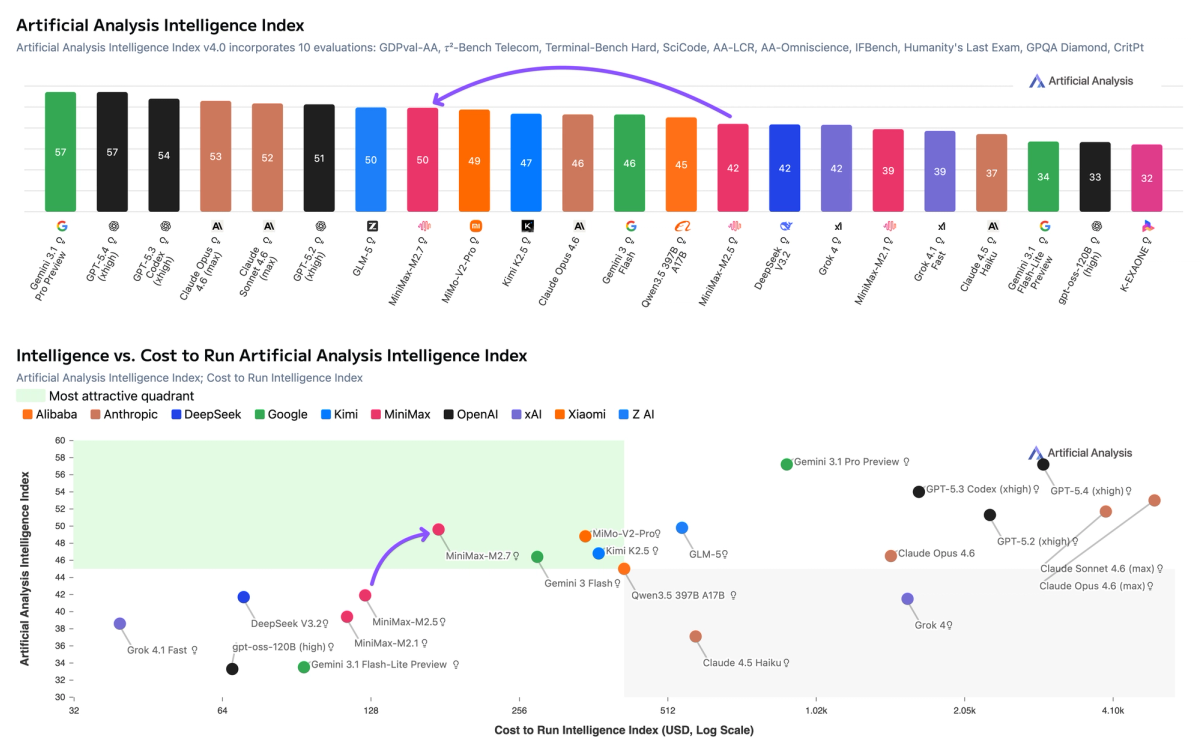
MiniMax-M2.7 от @MiniMax_AI набрал 50 баллов по индексу искусственного анализа интеллекта, что на 8 пунктов лучше, чем у MiniMax-M2.5, выпущенного месяц назад. Это обусловлено более высокой производительностью при выполнении реальных агентских задач и уменьшением количества галлюцинаций. MiniMax-M2.7 теперь опережает MiMo-V2-Pro (Рассуждение, 49) и Kimi K2.5 (Рассуждение, 47) и эквивалентен GLM-5 (Рассуждение, 50), используя при этом на 20% меньше выходных токенов и обходясь менее чем на треть дороже. MiniMax-M2.7 — это модель, основанная только на рассуждениях, и она поддерживает ту же цену за токен, что и MiniMax-M2.5.
Ключевые выводы
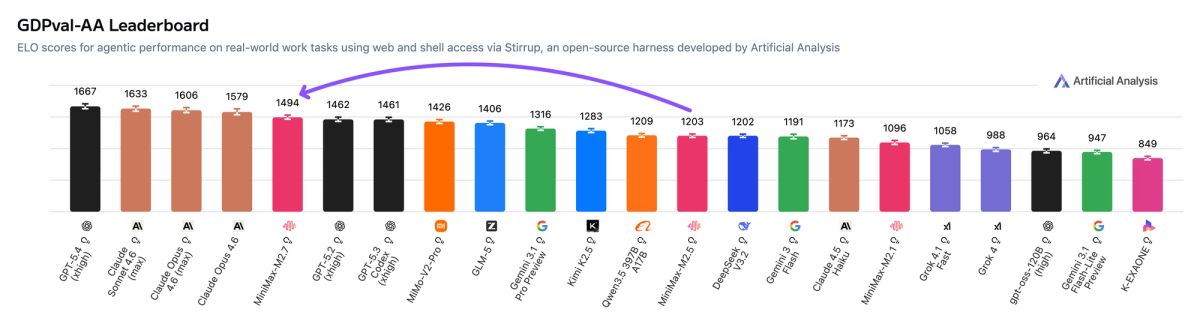
➤ Высокая производительность при выполнении реальных агентских задач: MiniMax-M2.7 достигает GDPval-AA Elo 1494, что является значительным улучшением по сравнению с MiniMax-M2.5 (1203) и опережает MiMo-V2-Pro (Рассуждение, 1426), GLM-5 (Рассуждение, 1406) и Kimi K2.5 (Рассуждение, 1283). Он остается позади передовых моделей, таких как GPT-5.4 (xhigh, 1667) и Claude Opus 4.6 (Адаптивное мышление, максимальное усилие, 1606).
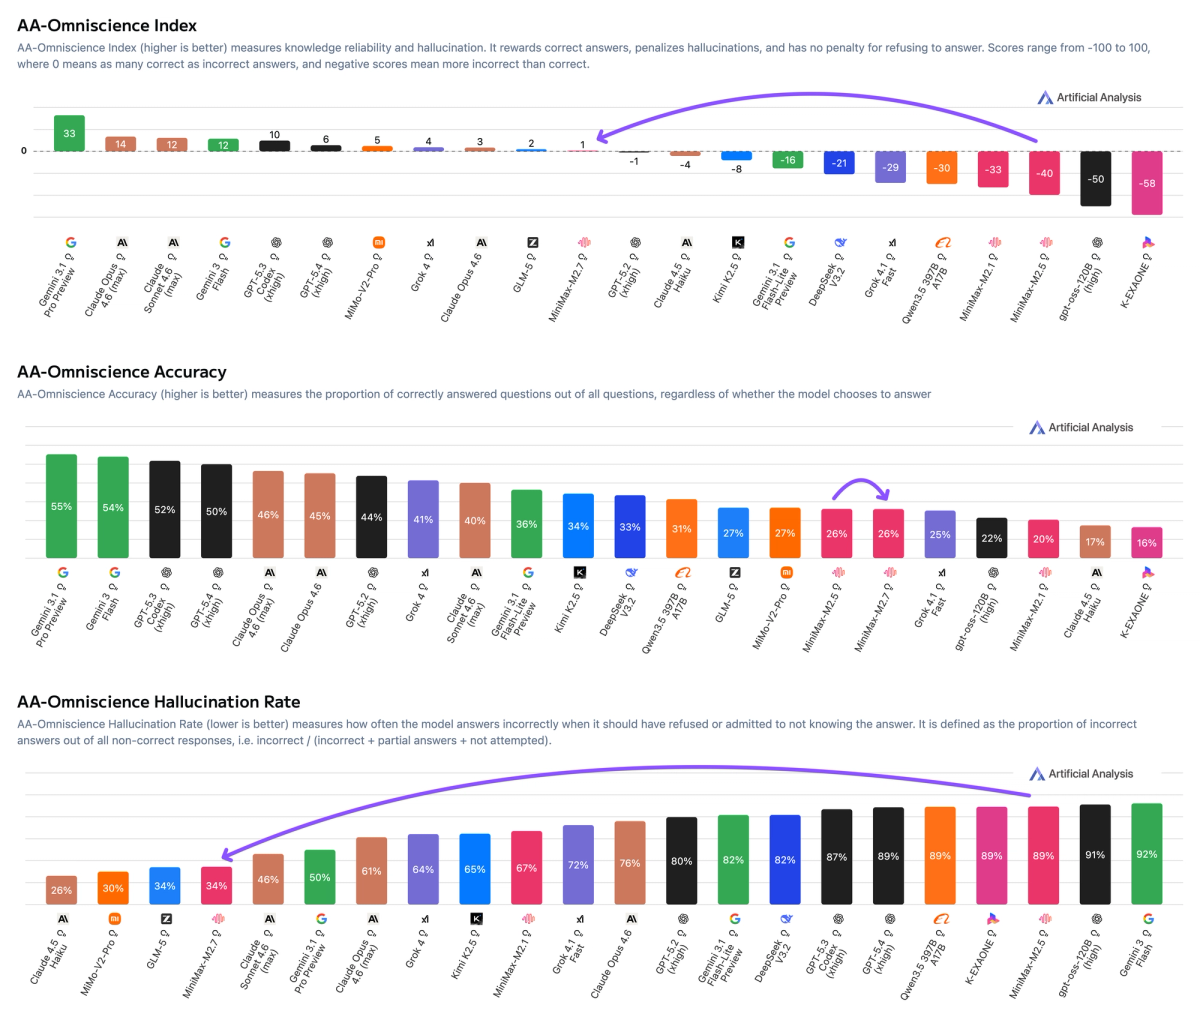
➤ Уменьшение галлюцинаций: MiniMax-M2.7 получает +1 по индексу всеведения AA по сравнению с MiniMax-M2.5 (-40). Это конкурирует с GPT-5.2 (xhigh, -1) и GLM-5 (Рассуждение, +2) и значительно опережает Кими K2.5 (Рассуждение, -8). Улучшение по сравнению с M2.5 обусловлено исключительно уменьшением галлюцинаций, а это означает, что модель с большей вероятностью воздержится от ответа, когда не знает ответа, а не будет гадать. M2.7 достигает уровня галлюцинаций 34%, что ниже, чем у Claude Sonnet 4.6 (адаптивное мышление, максимальное усилие, 46%) и Gemini 3.1 Pro Preview (50%).
➤ Прирост по большинству оценок по сравнению с MiniMax-M2.5: помимо отмеченных выше улучшений GDPval-AA и AA-Всезнание, MiniMax-M2.7 улучшается в HLE (+9 п.п.), TerminalBench Hard (+5 п.п.), SciCode (+4 п.п.), IFBench (+4 п.п.), GPQA (+3 п.п.) и LCR (+3). п.п.). Мы увидели заметный регресс в τ²-Bench (-11 п.п.).
➤ Увеличение использования токенов: MiniMax-M2.7 использовал ~ 87 миллионов выходных токенов для запуска индекса искусственного анализа интеллекта, что на 55% больше, чем у MiniMax-M2.5 (~ 56 миллионов). Он по-прежнему более эффективен, чем другие модели, такие как GLM-5 (Reasoning, 110M) и Kimi K2.5 (Reasoning, ~89M).
➤ Высокая экономическая эффективность: MiniMax-M2.7 стоит 176 долларов США для запуска индекса искусственного анализа интеллекта, сохраняя те же цены 0,30/1,20 доллара США за 1 миллион входных/выходных данных, что и M2.5. Это помещает его на границу Парето нашей диаграммы «Интеллект против затрат». Для контекста: GLM-5 (Рассуждение) стоит 547 долларов при эквивалентном интеллекте, Kimi K2.5 (Рассуждение) стоит 371 доллар, а Gemini 3 Flash Preview (Рассуждение) стоит 278 долларов.
Ключевые детали модели
➤ Контекстное окно: 200 тыс. токенов (эквивалент MiniMax-M2.5).
➤ Цена: 0,30 доллара США/1,20 доллара США за 1 миллион токенов ввода/вывода (без изменений по сравнению с MiniMax-M2.5).
➤ Доступность: только собственный API MiniMax.
➤ Модальность: только ввод и вывод текста (без мультимодальности).
➤ Лицензирование: MiniMax не объявила, будет ли MiniMax-M2.7 открытым весом. MiniMax-M2.5 доступен по лицензии MIT.
MiniMax-M2.7 достигает одного из самых высоких показателей в GDPval-AA (агентские реальные рабочие задачи) с Elo 1495. Это ставит его впереди Кодекса GPT-5.3 (xhigh, 1462) и рядом с GPT-5.2 (xhigh, 1462).
MiniMax-M2.7 получает +1 по индексу всеведения AA по сравнению с MiniMax-M2.5 (-40). Это улучшение обусловлено исключительно снижением частоты галлюцинаций до 34% (-55 п.п.), что является одним из самых низких зарегистрированных показателей галлюцинаций. Это означает, что модель с гораздо большей вероятностью воздержится от ответа, когда не знает ответа, а не будет гадать.
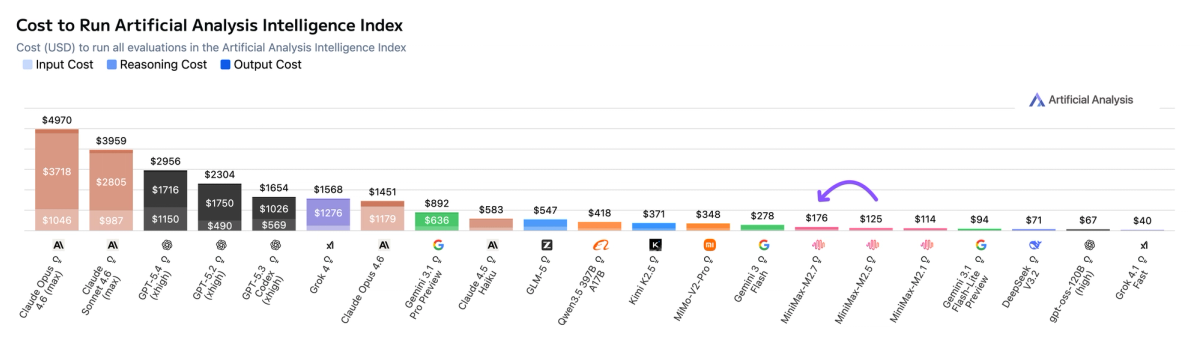
MiniMax-M2.7 стоит около 175 долларов США для запуска индекса искусственного анализа интеллекта по цене 0,30 доллара США/1,20 доллара США за 1 миллион токенов ввода-вывода (без изменений по сравнению с M2.5), что делает его менее дорогим, чем аналогичные модели с аналогичным интеллектом, такие как GLM-5 (Рассуждение, ~ 547 долларов США), MiMo-V2-Pro (Рассуждение, ~ 348 долларов США) и Kimi K2.5 (Рассуждение, 371 доллар США). Это увеличение по сравнению с M2,5 (125 долларов США), что обусловлено более высоким использованием выходных токенов.
MiniMax-M2.7 использовал ~ 87 миллионов выходных токенов для запуска индекса искусственного анализа интеллекта, что на 55% больше, чем у MiniMax-M2.5 (~ 56 миллионов). Несмотря на это, он остается более эффективным с точки зрения токенов, чем GLM-5 (Рассуждение, ~109M) и Kimi K2.5 (Рассуждение, ~89M) при эквивалентном или более низком интеллекте. MiMo-V2-Pro (Рассуждение, ~77 млн) использовал меньше токенов, но имел более низкий показатель индекса интеллекта.
Полная разбивка результатов