Индекс точности провайдеров API: одна модель — разное качество ответа
Сравнение хостинг-провайдеров: как квантование и системные промпты у разных вендоров меняют итоговый результат одной и той же модели.
Провайдеры жертвуют точностью ради оптимизации скорости и стоимости. Они квантуют веса, пишут собственные ядра и настраивают свои стеки вывода, а иногда просто отправляют ошибки. Мы привносим строгость нашего индекса искусственного анализа интеллекта в измерение конечных точек, чтобы разработчики могли выбирать поставщиков по точности, а не только по цене и скорости.
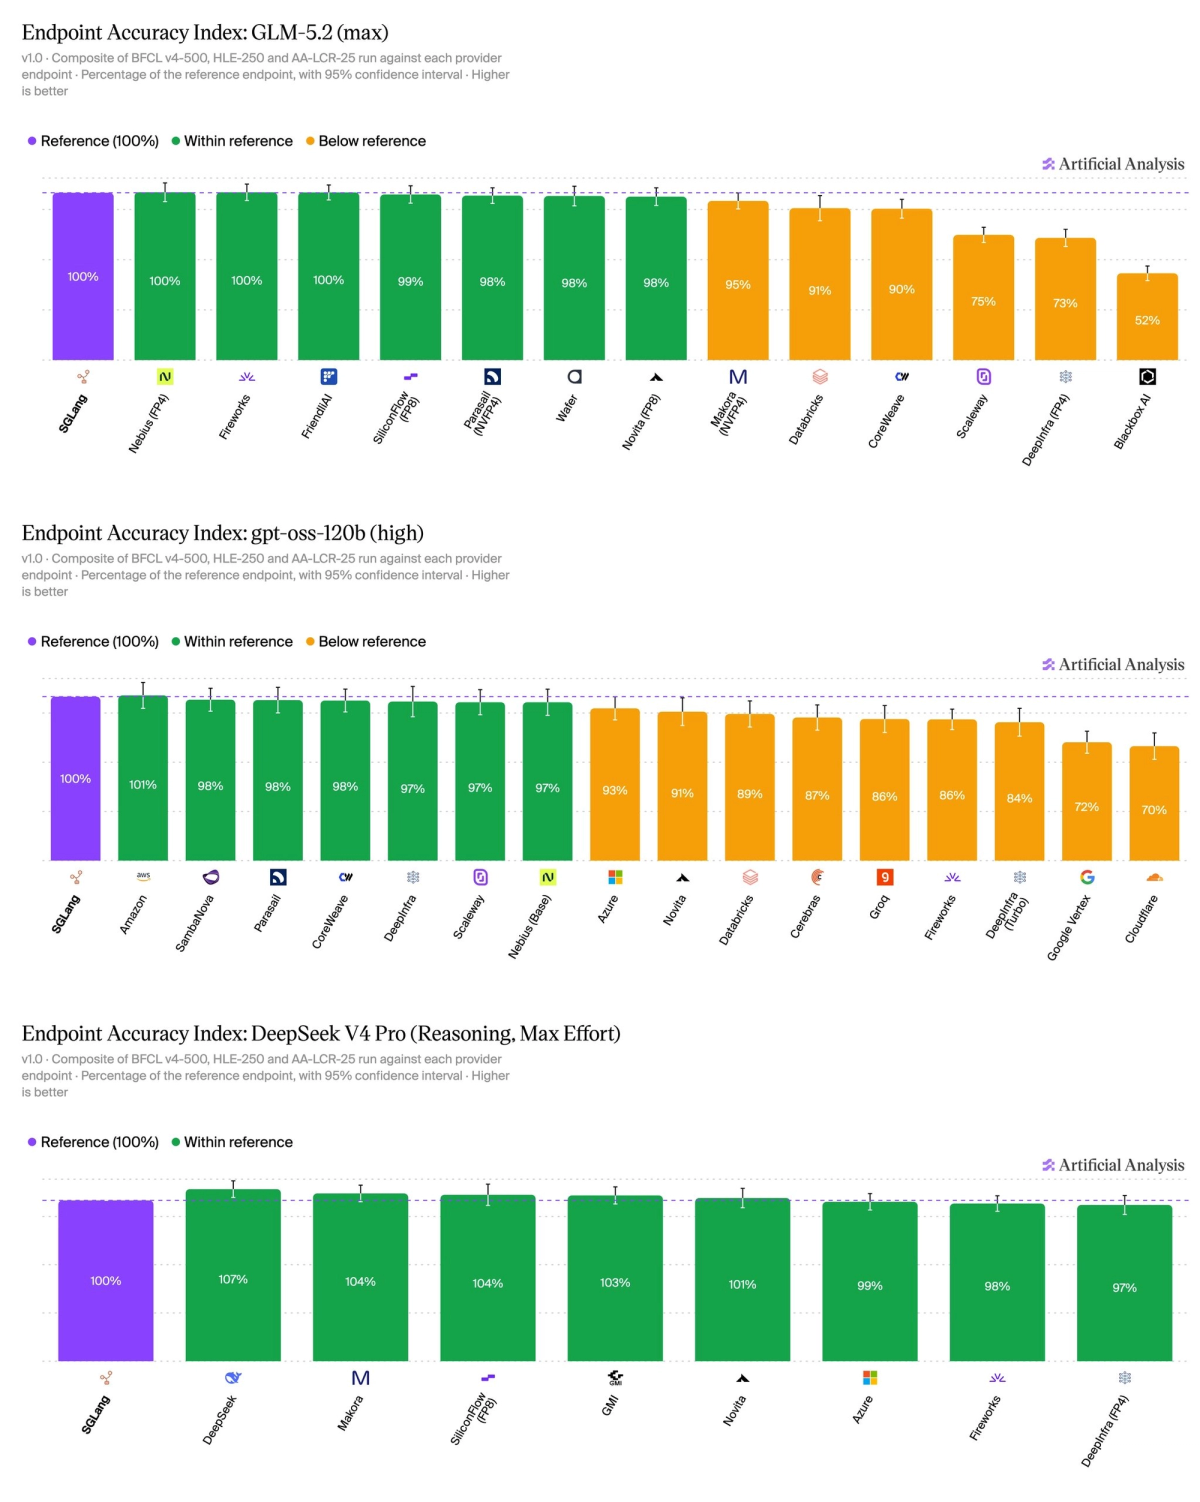
Мы сравниваем каждую бессерверную конечную точку с нашим собственным эталонным развертыванием официальных весов, где 100 % соответствует эталону. Конечная точка находится на эталонном четности, когда ее результат попадает в 95% доверительный интервал эталонного значения. Покрытие доступно для GLM-5.2, gpt-oss-120b и DeepSeek V4 Pro, а скоро будет запущено покрытие точности Kimi K3.
Ключевые элементы индекса точности конечных точек
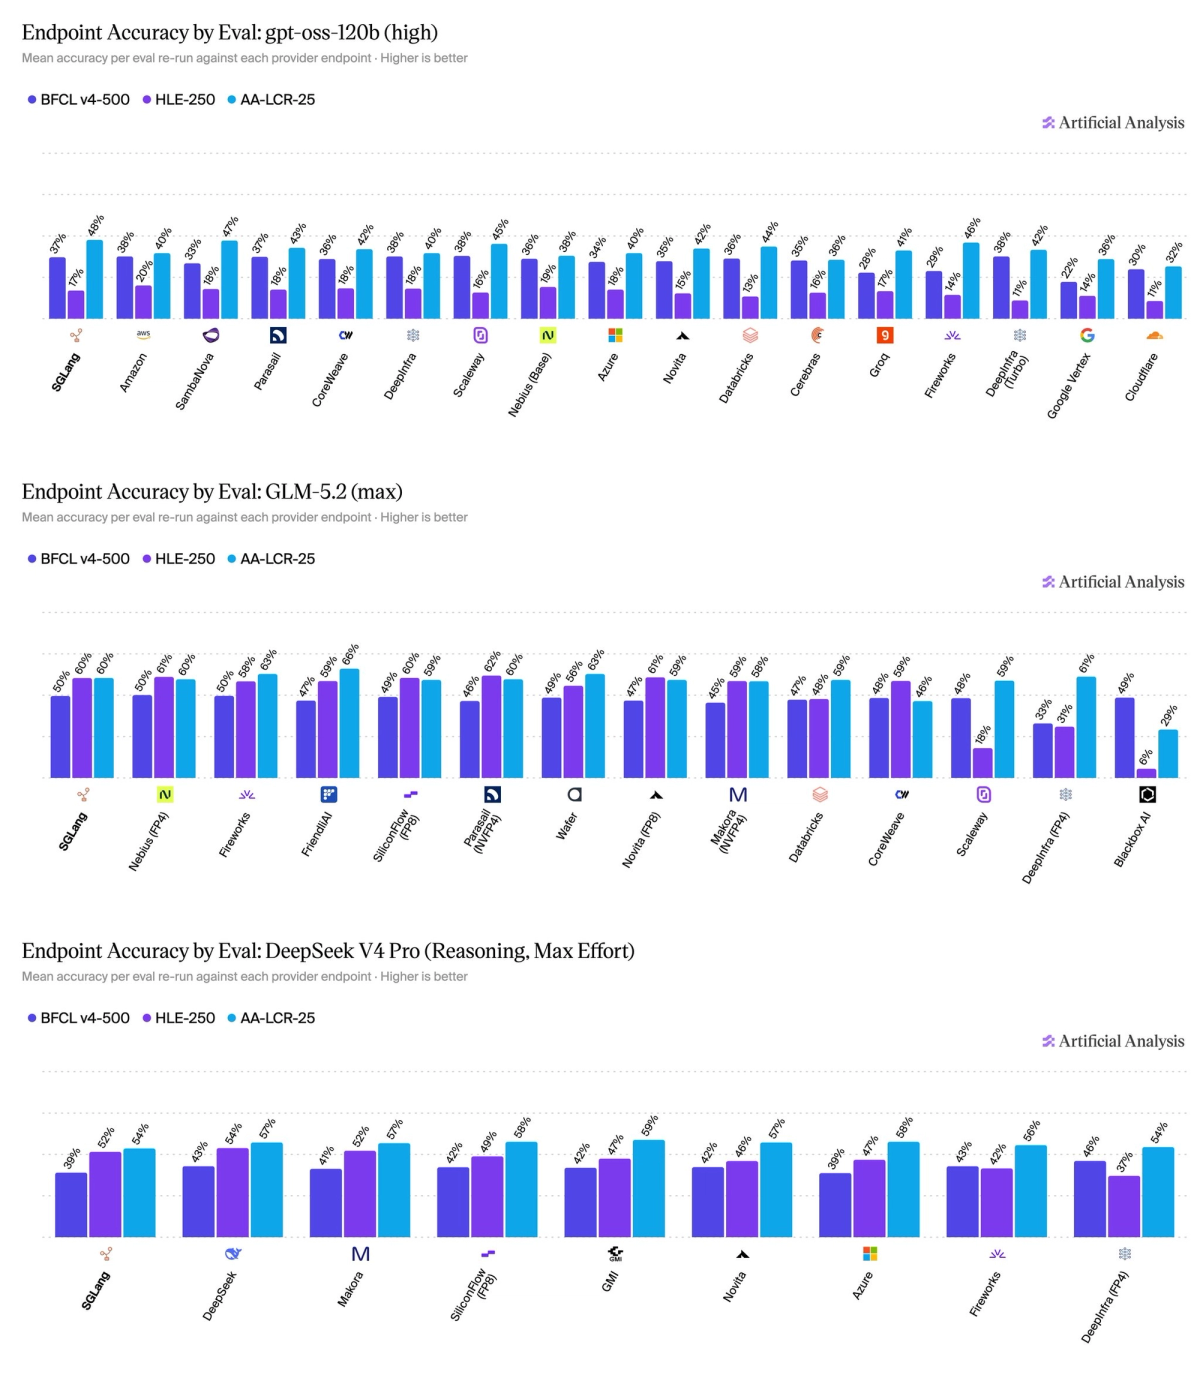
- Три области с одинаковым весом: вызов инструментов (BFCL-500, 500 вопросов, 3 повтора), научное рассуждение (HLE-250, 250 вопросов, 10 повторов) и длительное вспоминание контекста (AA-LCR-25, 25 вопросов, 10 повторов). Каждое подмножество разделяет конечные точки вариантов обслуживания, которые определяют разницу в точности, при этом размер повторов рассчитан на узкие доверительные интервалы.
- Эталонное развертывание: мы самостоятельно размещаем официальные веса с рекомендованной лабораторией точностью, следуя рецепту обслуживания лаборатории, и публикуем полные команды для каждого эталона.
- Параметры вывода: мы запускаем максимально поддерживаемый режим рассуждения модели и максимальную поддерживаемую длину вывода и контекстное окно каждой конечной точки.
- Доверительные интервалы: тест на четность учитывает неопределенность как в прогонах конечной точки, так и в прогонах ссылки.
- Ротационный охват: модели появляются, когда их обслуживает достаточное количество поставщиков, и прекращают свое существование, когда их заменяет более новая версия того же семейства. Мы тестируем новые конечные точки по мере их запуска поставщиками и периодически обновляем все перечисленные конечные точки.
- Момент времени: каждый результат имеет дату, когда он был измерен, а многодневные контрольные показатели приурочены к их последнему дню.
Ключевые результаты GLM-5.2
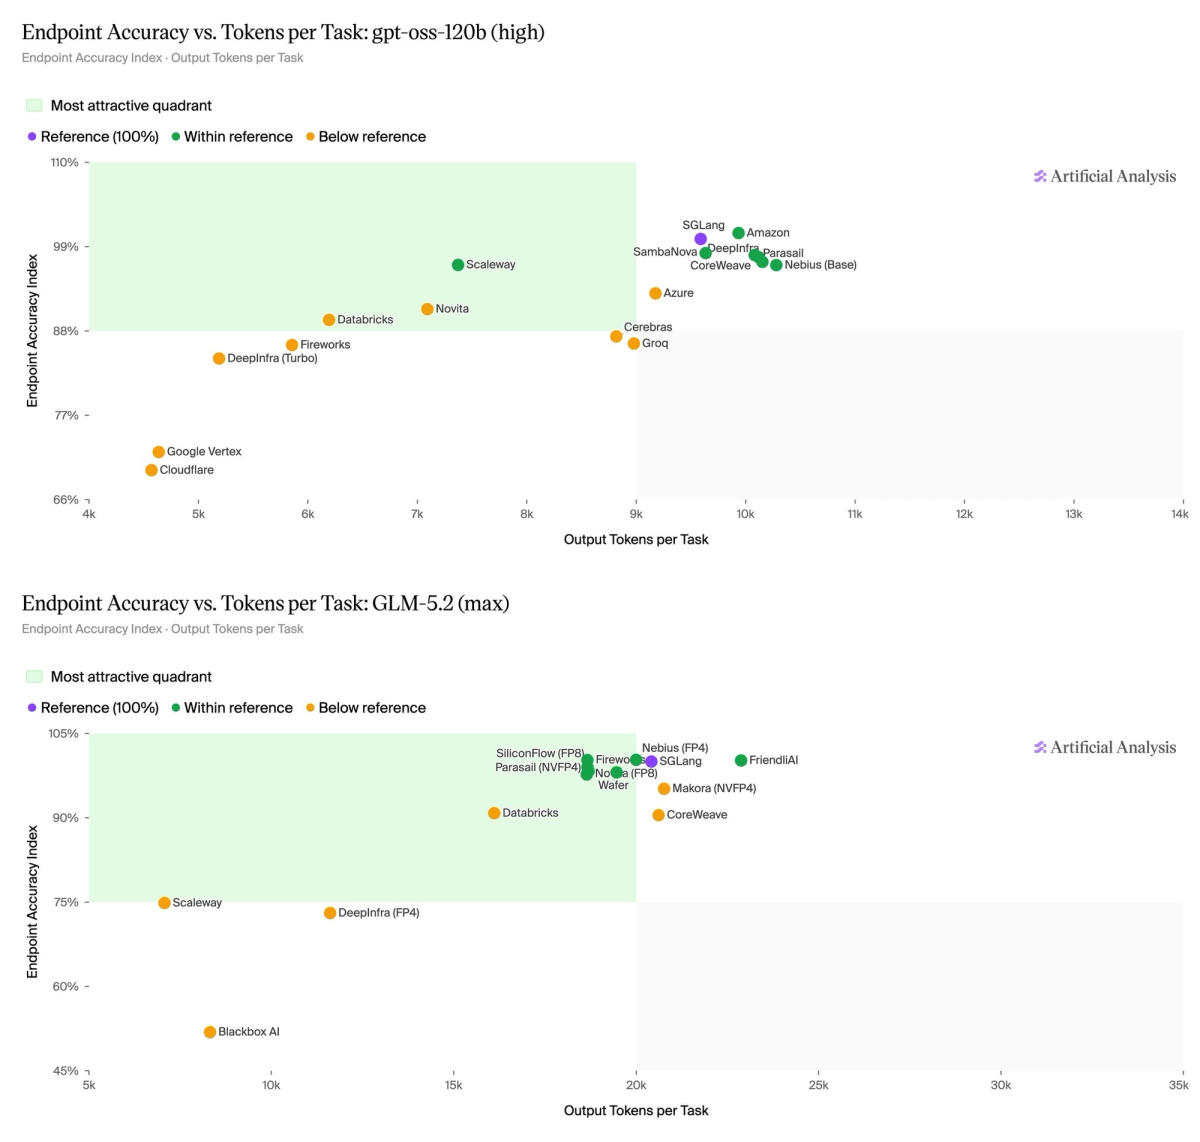
- Ограничения выходных токенов ограничивают точность. Ограничительные ограничения отсекают ответы до того, как модель завершит рассуждения, а самые строгие конечные точки получают половину контрольного или меньше по HLE-250.
Ключевые результаты для gpt-oss-120b
- Обработка вызовов инструментов разделяет конечные точки. Поставщики анализируют и форматируют вызовы инструментов по-разному, а некоторые конечные точки набирают 22% по BFCL-500 против 37% по эталону.
- Конфигурация обслуживания меняет действия модели при тех же запрошенных настройках. Некоторые конечные точки создают гораздо меньше токенов рассуждения на одном и том же настроенном уровне, а окна с ограниченным контекстом усекают длинные контекстные задачи.
Ключевые результаты для DeepSeek V4 Pro
- Конечные точки DeepSeek V4 Pro больше соответствуют эталону. Большинство конечных точек находятся на эталонном паритете, а собственные конечные точки DeepSeek оцениваются немного выше эталонного.
Как рассчитывается индекс точности конечной точки: мы проводим одни и те же три оценки для каждой конечной точки и эталонного развертывания, оцениваем каждую как процент от эталонного результата и усредняем три оценки с одинаковым весом.
Конечные точки с оценкой ниже эталонного обычно производят меньше токенов вывода на задачу. Ограничения вывода и сокращение усилий по рассуждению проявляются непосредственно в использовании токенов, а конечные точки с наименьшим баллом в обеих моделях производят примерно половину выходных токенов эталона.
**Полные результаты: **