OpenAI GPT-5.5 стала новым мировым лидером среди ИИ-моделей
GPT-5.5 возглавила глобальный Индекс интеллекта, продемонстрировав беспрецедентную глубину рассуждений.

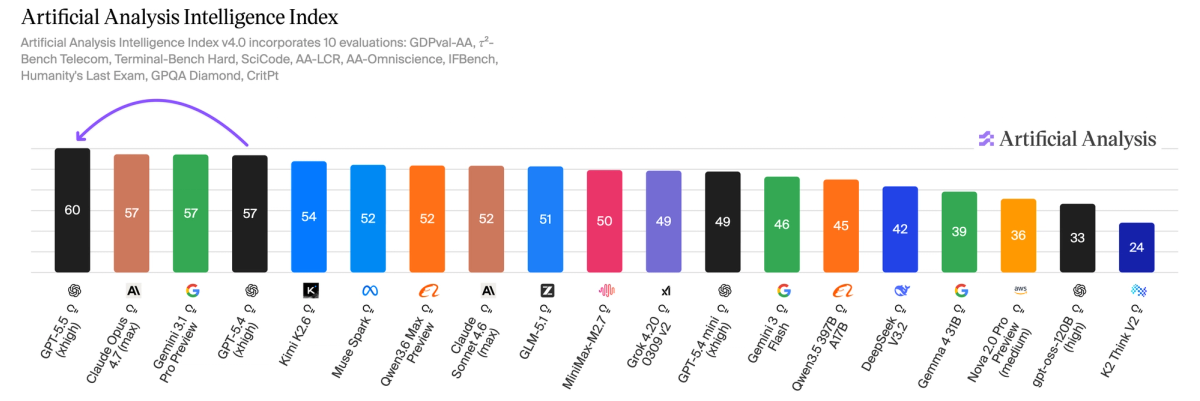
GPT-5.5 от OpenAI — новая ведущая модель. GPT-5.5 возглавляет индекс искусственного анализа интеллекта на 3 пункта, разрывая тройную ничью с Anthropic и Google.
OpenAI предоставила нам доступ к предварительной версии для тестирования всех пяти уровней рассуждений: высокий, высокий, средний, низкий и без рассуждений.
Ключевые выводы:
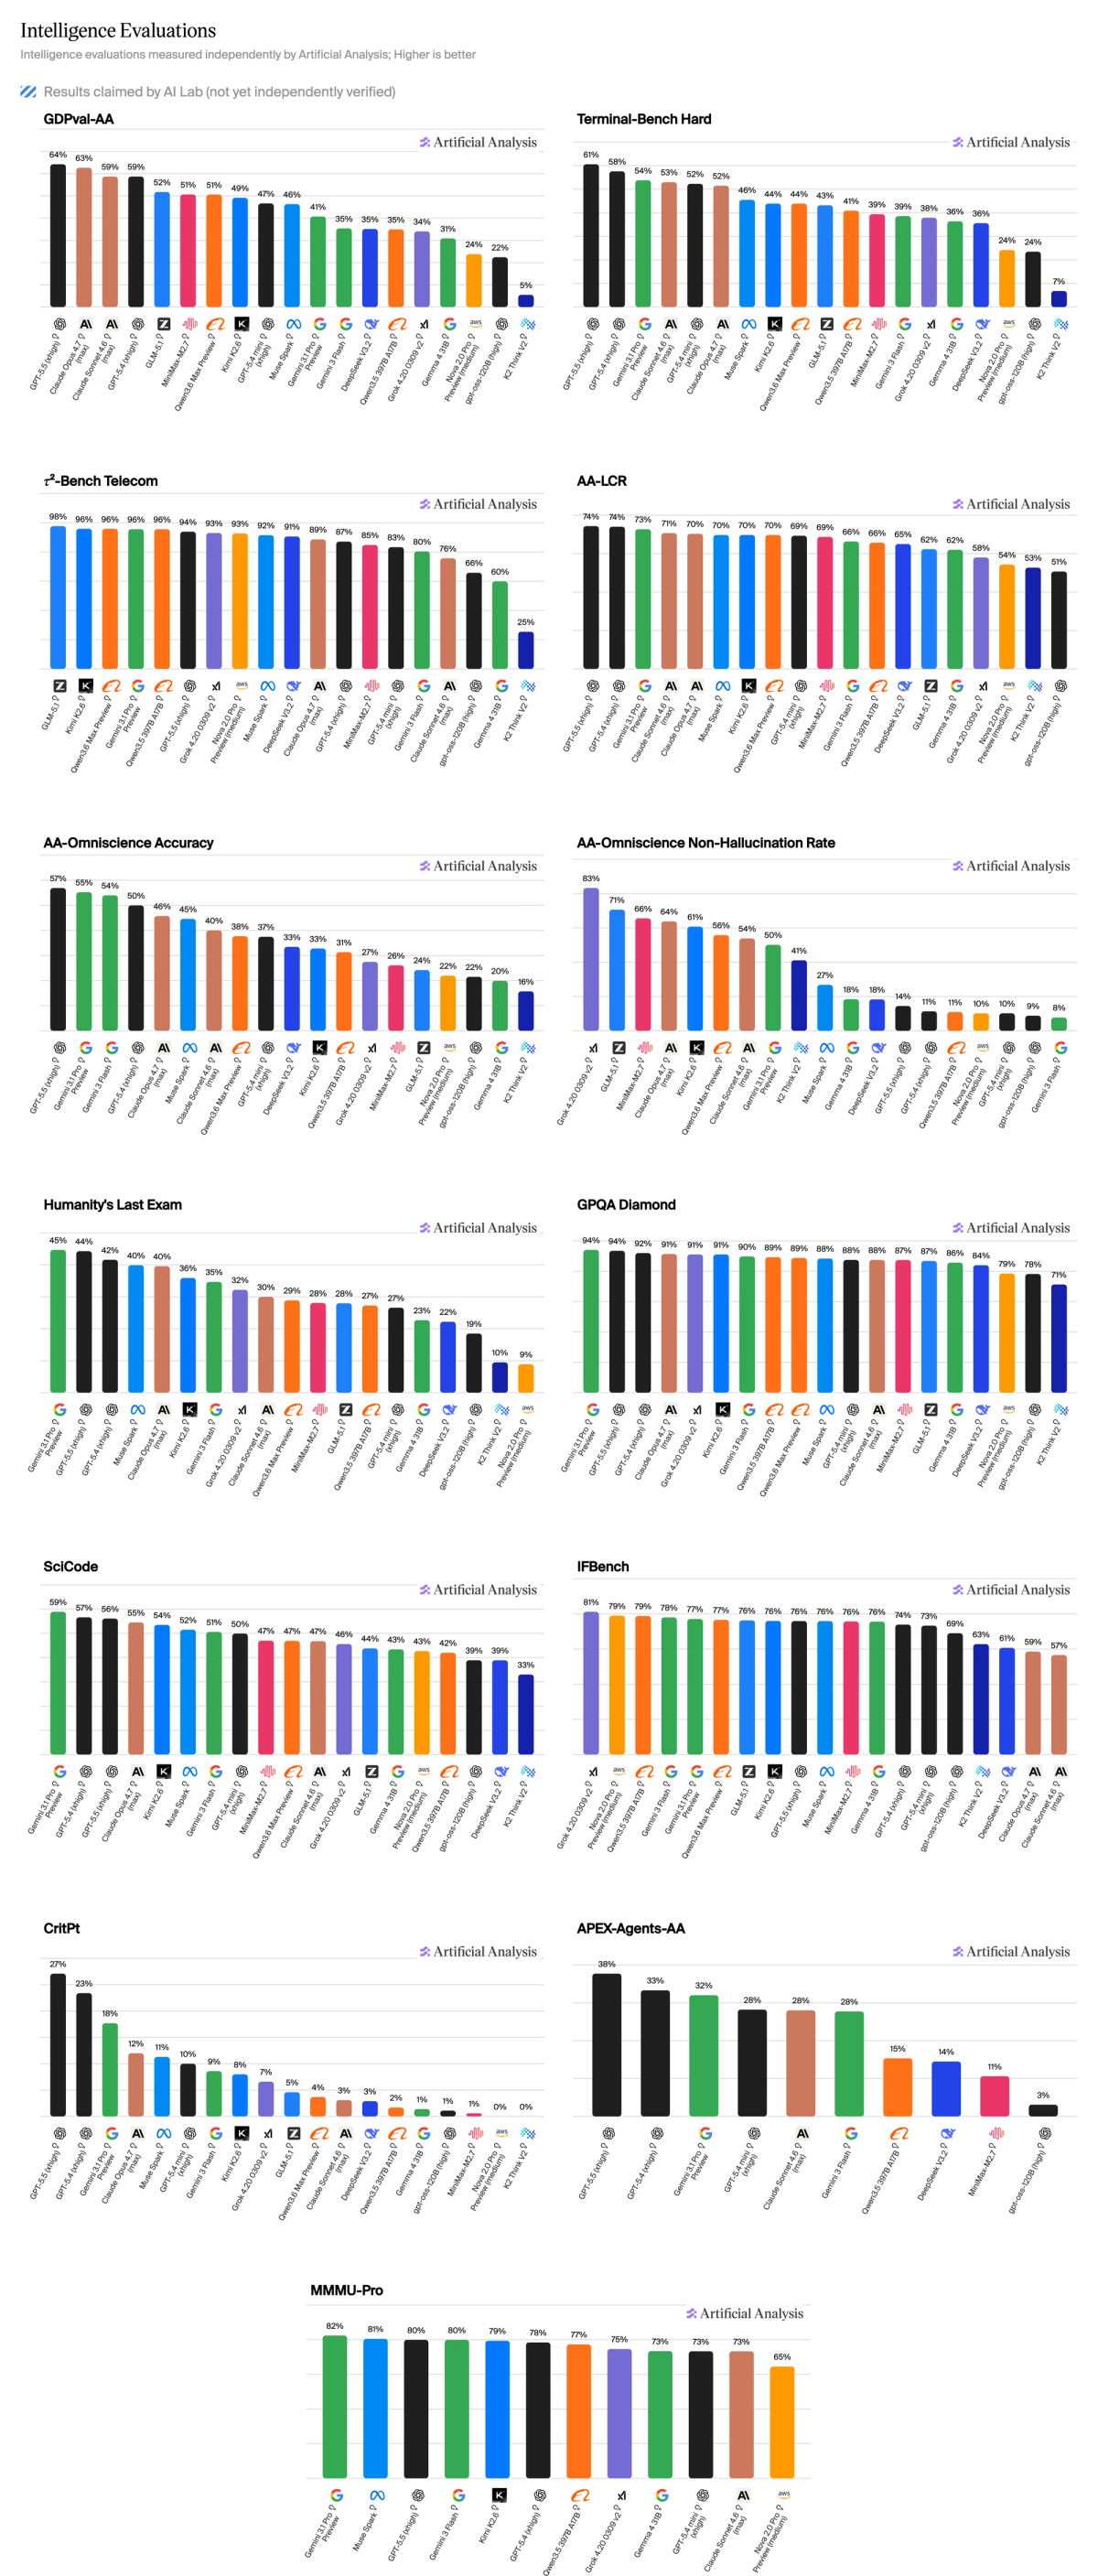
➤ OpenAI возглавляет пять основных оценок: GPT-5.5 (xhigh) опережает Terminal-Bench Hard, GDPval-AA и наш недавно размещенный APEX-Agents-AA. Модель уступает только другим моделям OpenAI по показателям CritPt и AA-LCR и занимает второе место после Gemini 3.1 Pro Preview по трем дополнительным оценкам. Наибольший прирост наблюдается по AA-Всезнанием (+14 пунктов), нашему эталону знаний и галлюцинаций, и τ²-Bench Telecom (+7 пунктов), эталону агентов по обслуживанию клиентов.
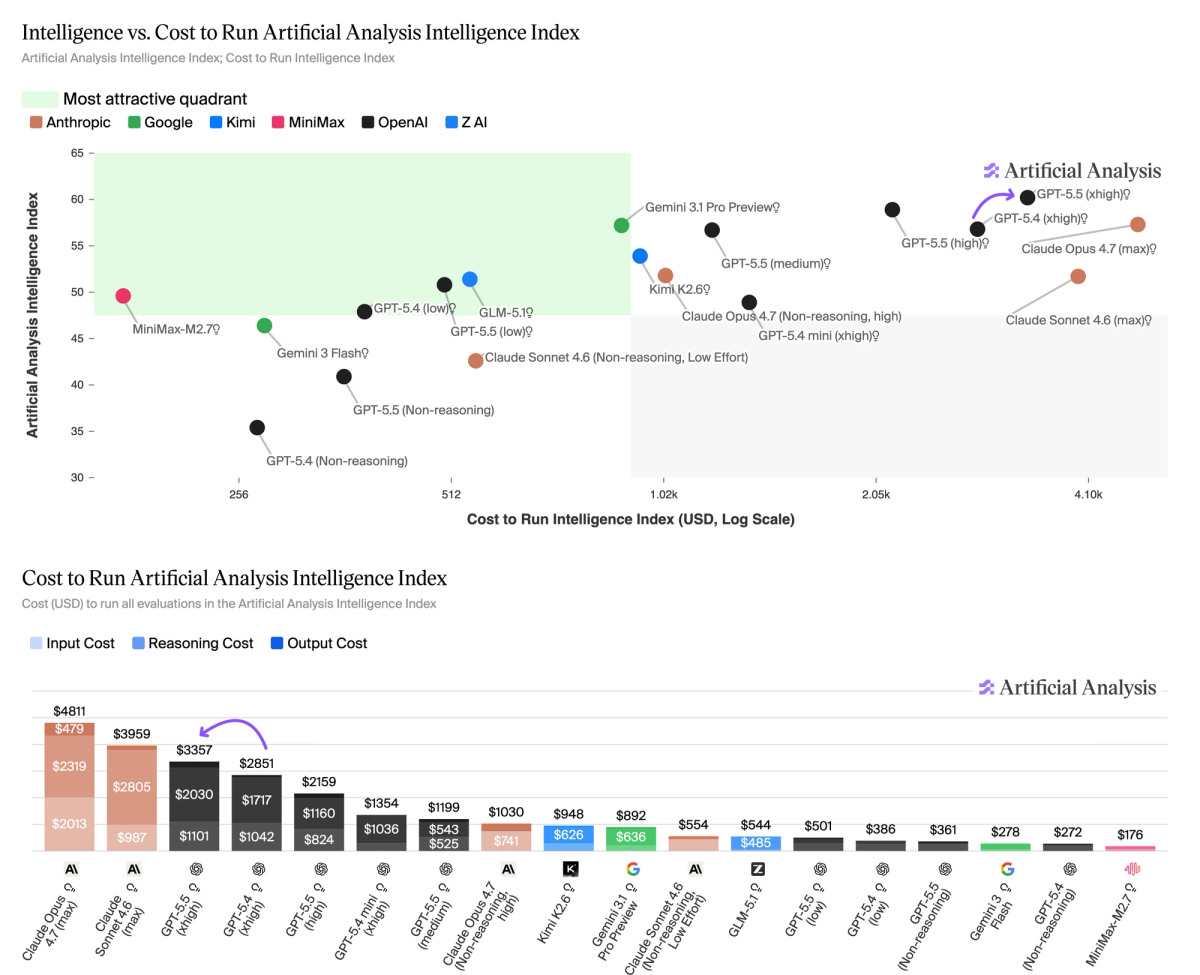
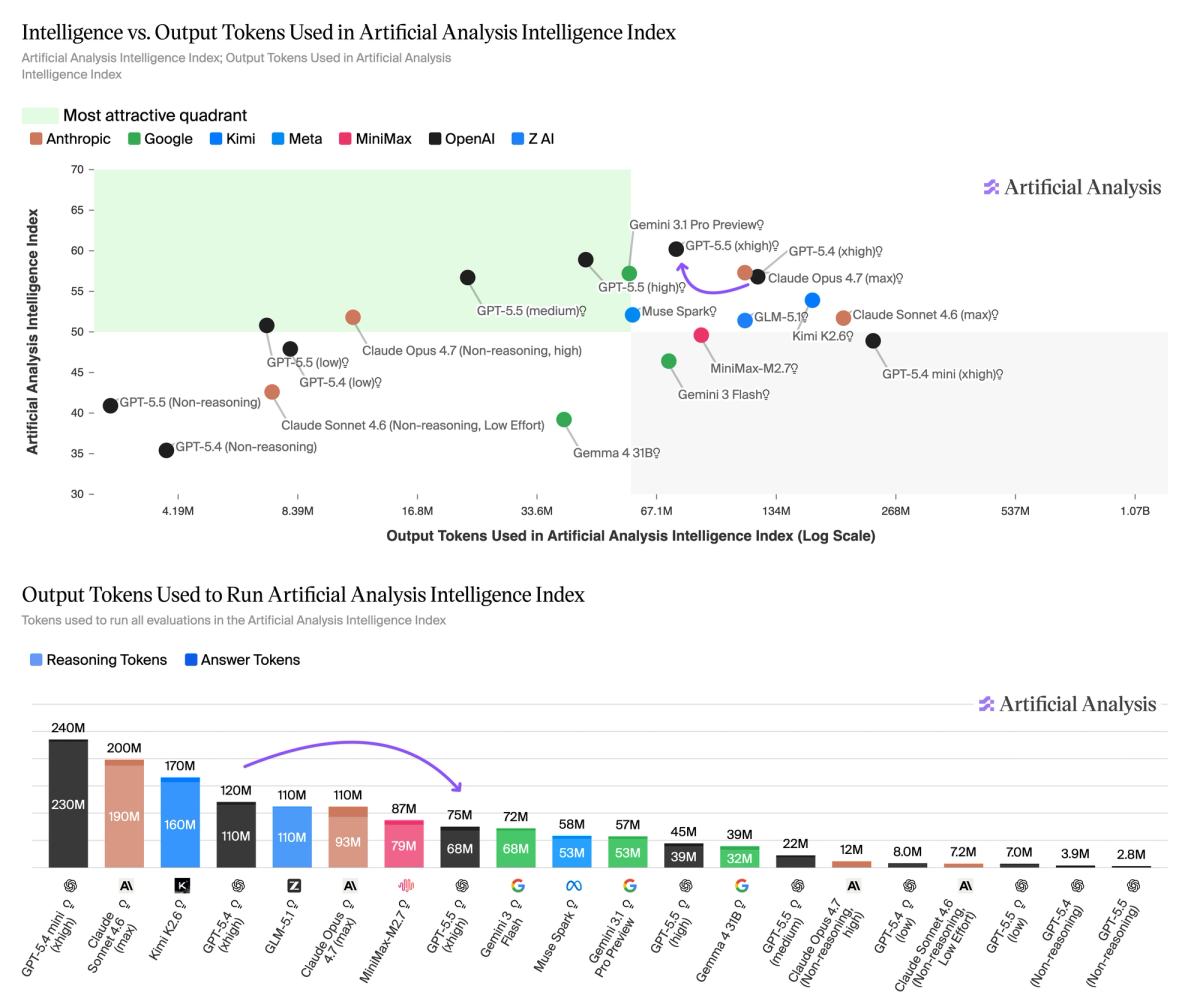
➤ На 20% дороже содержание нашего индекса: цена за токен выросла вдвое с GPT-5,4 до 5/30 долларов США за 1 миллион входных/выходных токенов. Тем не менее, сокращение использования токенов на ~40% в значительной степени компенсирует этот рост, что приводит к чистым затратам на управление нашим индексом интеллекта примерно на 20%.
➤ Постарайтесь найти четкую лестницу для баланса интеллекта и стоимости: GPT-5.5 (средний) оценивается так же, как Claude Opus 4.7 (максимум) в нашем индексе интеллекта, за одну четверть стоимости (~ 1200 долларов США против 4800 долларов США) - хотя Gemini 3.1 Pro Preview имеет такой же балл при цене ~ 900 долларов США. GPT-5.5 (низкий) приближается к Claude Opus 4.7 (Без рассуждений, высокий) по нашему Индексу интеллекта при половине стоимости эксплуатации (~ 500 долларов США против ~ 1000 долларов США).
➤ Номер один в GDPval-AA с Эло 1785: GPT-5.5 (xhigh) опережает Claude Opus 4.7 (max) на ~30 баллов и Gemini 3.1 Pro Preview на ~470 баллов. GDPval-AA — это тест искусственного анализа, который использует набор данных OpenAI GDPval для оценки моделей для решения реальных экономически ценных задач.
➤ Высочайшая точность всеведения АА, но отстающая от галлюцинаций: наш частный тест всеведения АА вознаграждает фактические знания по различным темам, но наказывает за галлюцинации. GPT-5.5 (xhigh) имеет самую высокую точность — 57 % — это означает, что модель может запоминать факты из корпуса всеведения более эффективно, чем любая другая модель. Однако уровень галлюцинаций у него составляет 86% — по сравнению с Opus 4.7 (макс.) с 36% и Gemini 3.1 Pro Preview с 50%. Это повышает вероятность ответа на вопрос, когда он «не знает» ответа. Увеличение AA-Всеведения на 14 баллов по сравнению с GPT-5.4 (xhigh) во многом было обусловлено знаниями, с умеренным улучшением галлюцинаций.
GPT-5.5 возглавляет индекс искусственного анализа интеллекта на 3 пункта, разрывая тройную ничью с Anthropic и Google.
OpenAI возглавляет пять наших основных оценок и занимает второе место после Gemini 3.1 Pro Preview в трех.
Варианты усилий обеспечивают четкую лестницу для балансирования интеллекта и затрат. GPT-5.5 (xhigh) на ~20 % дороже для запуска нашего индекса, чем его предшественник, но на 30 % дешевле, чем Claude Opus 4.7 (макс.)
GPT-5.5 (xhigh) использует примерно на 40% меньше выходных токенов для запуска нашего индекса, чем его предшественник.
GPT-5.5 (xhigh) опережает GDPval-AA с рейтингом Эло 1785.
GPT-5.5 (xhigh) демонстрирует самый высокий за всю историю показатель точности AA-Всеведение, но отстает от границы по галлюцинациям.