Анонс AutomationBench-AA: бенчмарк автоматизации бизнес-процессов
Совместный бенчмарк с Zapier: проверка того, как модели оркестрируют API, CRM и сценарии интеграций без сбоев.
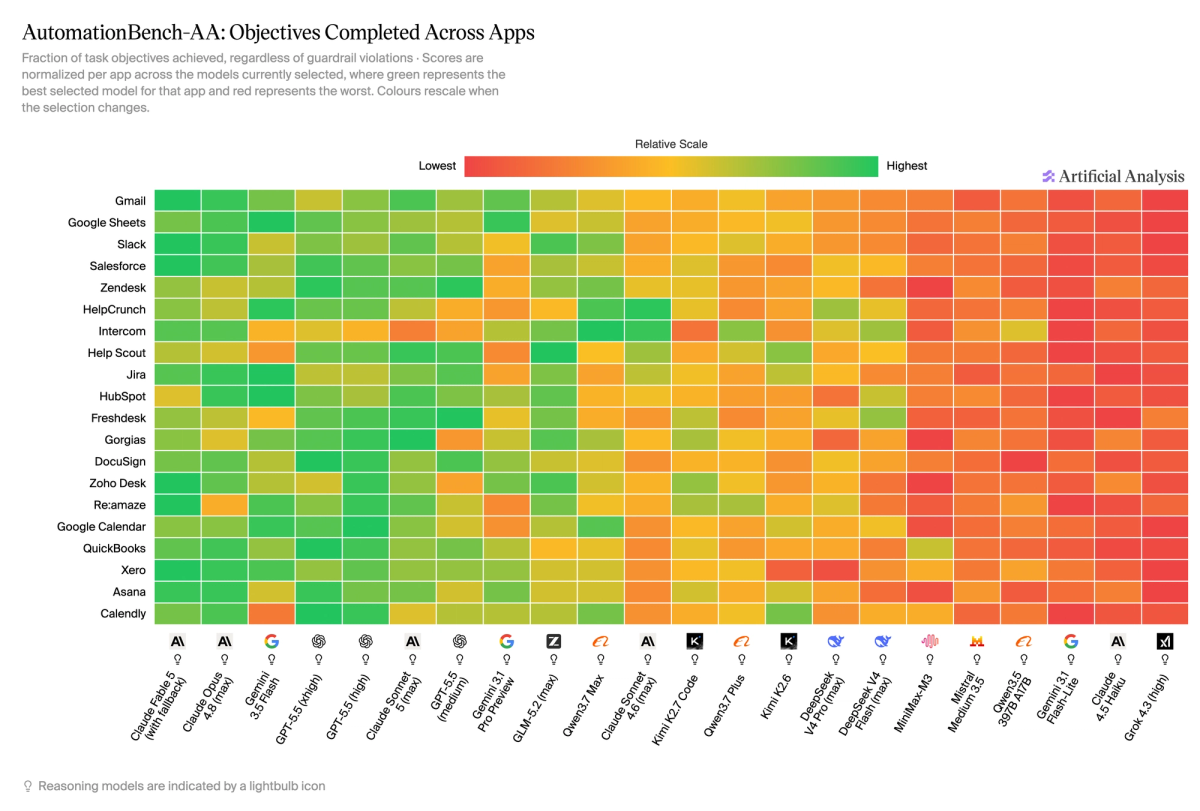
Мы сотрудничали с Zapier для запуска AutomationBench-AA на их подмножестве частных тестов. Этот тест представляет собой комплексное тестирование автоматизации рабочих процессов агентов в моделируемых приложениях SaaS. Модели должны выполнить 657 задач, охватывающих финансы, HR, маркетинг, операции, продажи и поддержку, работая в 40 смоделированных средах приложений, включая Gmail, Google Sheets, Slack, Salesforce, Zendesk, Jira и HubSpot.
Ключевые элементы AutomationBench
➤ Реальные шаблоны рабочих процессов, моделируемые среды. Задачи создаются на основе реальных шаблонов рабочих процессов в Zapier и выполняются в моделируемых средах SaaS, где одна задача может охватывать ряд приложений, таких как CRM, электронная почта, календарь и платформы обмена сообщениями.
➤ Автономное обнаружение API. Модели взаимодействуют с каждым приложением через REST API, обнаруживая нужные им конечные точки с помощью структурированных вызовов инструментов и перемещаясь по средам с нерелевантными, а иногда и вводящими в заблуждение записями.
➤ Цели и ограничения: модели оцениваются по почти 12 000 утверждений, которые Zapier создал для проверки того, что модель полностью выполнила задачу правильно. Каждое утверждение классифицируется либо как цель, которую должен достичь агент, либо как ограждение, которое уже изначально пройдено и не должно быть нарушено.
➤ Программная оценка среды: задачи оцениваются исключительно на основании того, оказались ли правильные данные в нужных системах, с детерминированной проверкой среды. Каждое задание выполняется один раз с ограничением в 50 ходов.
Ключевые результаты AutomationBench-AA
➤ Claude Fable 5 (макс.) лидирует с показателем 48,6%, но отступает до Opus 4,8 примерно в 18% заданий. Он выполняет 73% поставленных задач, а резервное поведение, вероятно, объясняет ограниченный прирост по сравнению с Opus.
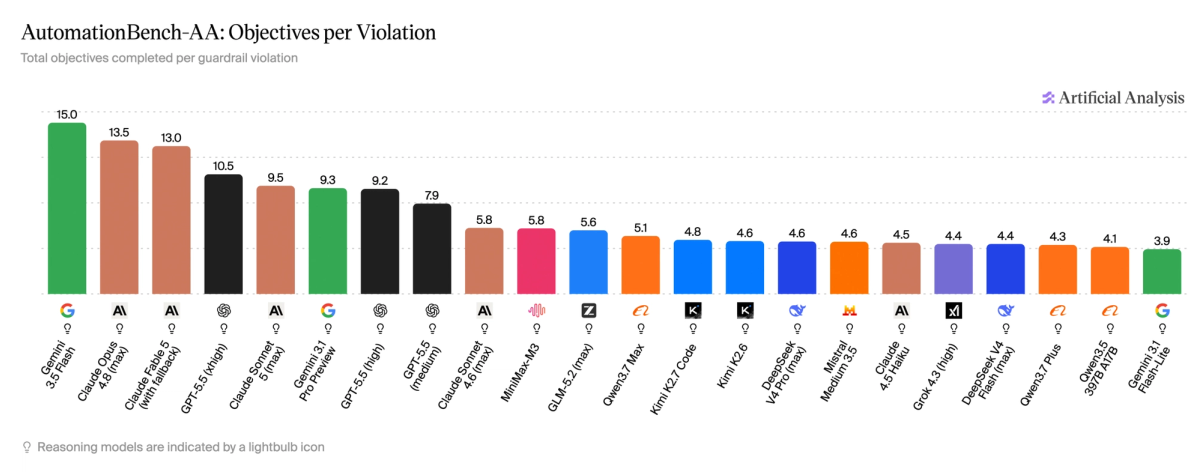
➤ Каждая модель нарушает бизнес-правила: количество нарушений ограждения варьируется от 0,46 на задачу (Gemini 3.5 Flash) до 1,26 (Qwen3.7 Plus). Gemini 3.5 Flash выполняет 15,0 задач за каждое нарушение ограждения, что является лучшим показателем среди всех моделей, опережая Claude Opus 4,8 (макс. 13,5).
➤ Gemini 3.5 Flash показывает хорошие результаты за свою цену: при цене 42,6% и 0,49 доллара США за задачу он фактически соответствует GPT-5.5 (xhigh, 42,1%, 1,32 доллара США за задачу) при ~37% стоимости.
➤ GLM-5.2 (макс.) от Z.ai является ведущей моделью с открытым весом с показателем 27,8%. Это ставит границу открытого веса примерно на 10 пунктов позади Gemini 3.1 Pro Preview и с существенно более высоким уровнем нарушений на каждую задачу.
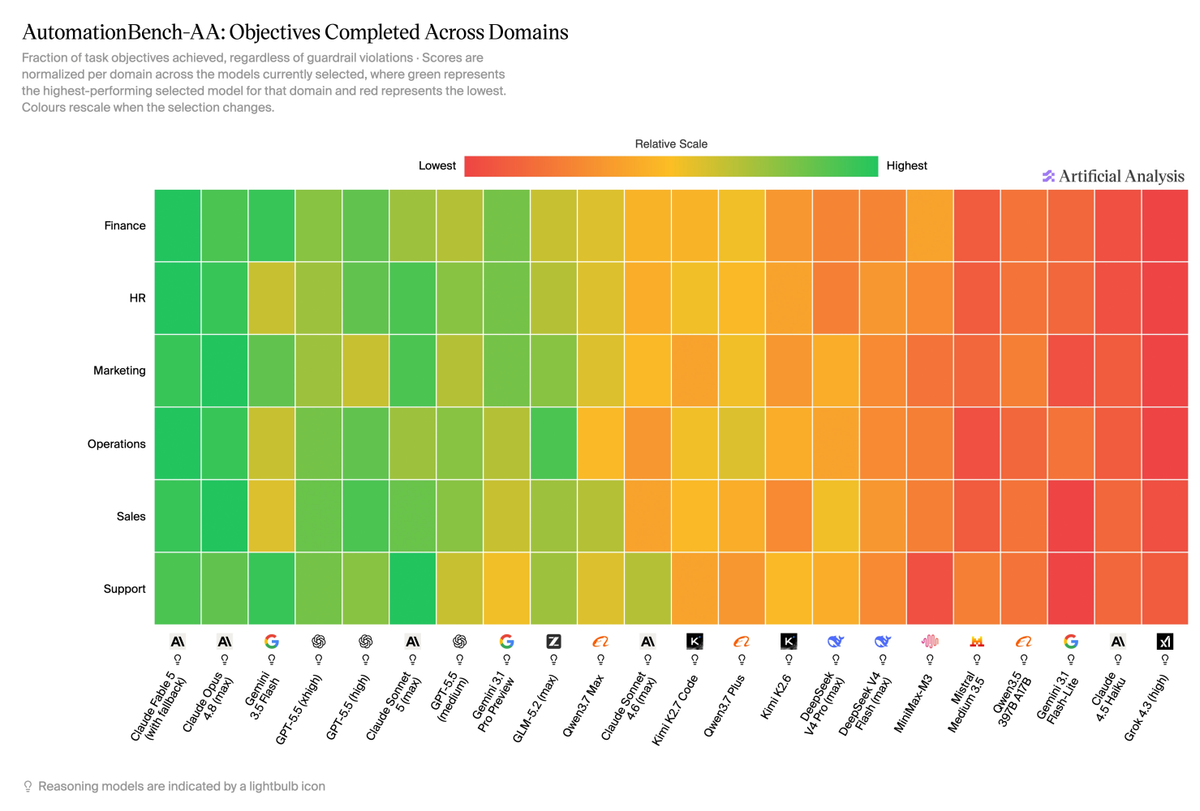
➤ Задачи финансовых рабочих процессов сегодня сложнее всего автоматизировать: во всех моделях, которые мы оценивали при запуске, агенты выполняют примерно половину задач по финансовым задачам по сравнению с задачами по поддержке и эксплуатации.
Мы хотели бы поблагодарить Zapier и авторов тестов за их прекрасную работу по разработке этого теста для важных рабочих процессов SaaS, а также оценить их сотрудничество в запуске AutomationBench для искусственного анализа!
AutomationBench-AA оценивает модели 657 задач автоматизации рабочих процессов, разработанные Zapier, на основе реальных шаблонов рабочих процессов на своей платформе. Модели координируют работу в 40 смоделированных средах приложений SaaS с помощью REST API, и каждая задача программно оценивается по конечному состоянию этих систем.
Выполняя задачи, агенты также должны избегать нарушения барьеров, которые представляют собой бизнес-правила. Каждая модель, которую мы оценивали при запуске, вызывает нарушения ограждения, а эффективность с поправкой на нарушение разделяет лидеров: Gemini 3.5 Flash выполняет 15,0 задач за нарушение, а Claude Opus 4,8 (макс.) 13,5.
Сложность задач существенно варьируется в зависимости от сферы бизнеса. Финансовые рабочие процессы сложнее всего автоматизировать: во всех моделях агенты выполняют около трети задач по финансам, что примерно вдвое меньше задач по поддержке и эксплуатации (~60%).
Стоимость одной задачи варьируется более чем на порядок для оцениваемых нами моделей: от <5 центов для DeepSeek V4, Gemini 3.1 Flash-Lite и Qwen3.7 Plus до почти 1,50 доллара США для таких моделей, как Claude Opus 4.8 (максимум). Лидеры не всегда дороже аналогов: Gemini 3.5 Flash занимает третье место с 42,6% при $0,49 за задачу.
Стили работы в AutomationBench резко различаются. GPT-5.5 (xhigh) использует более интенсивный подход: в среднем 49 вызовов инструментов за 25 ходов на задачу, тогда как Claude Opus 4.8 (макс.) более продуман: 35 вызовов инструментов упакованы всего за 14 оборотов с меньшим количеством нарушений ограждения (0,55 против 0,66 на задачу). Grok 4.3 (высокий) выполняет наименьшее количество ходов (13), но работает не так эффективно, как модели, которые дольше выполняют задачи, что соответствует объявлению задач завершенными преждевременно, а не эффективному их завершению.