Обзор свежих релизов моделей с открытыми весами: сравнение характеристик
Большой сравнительный дайджест: Llama, Qwen, DeepSeek, Mistral и компактные модели для локального запуска.
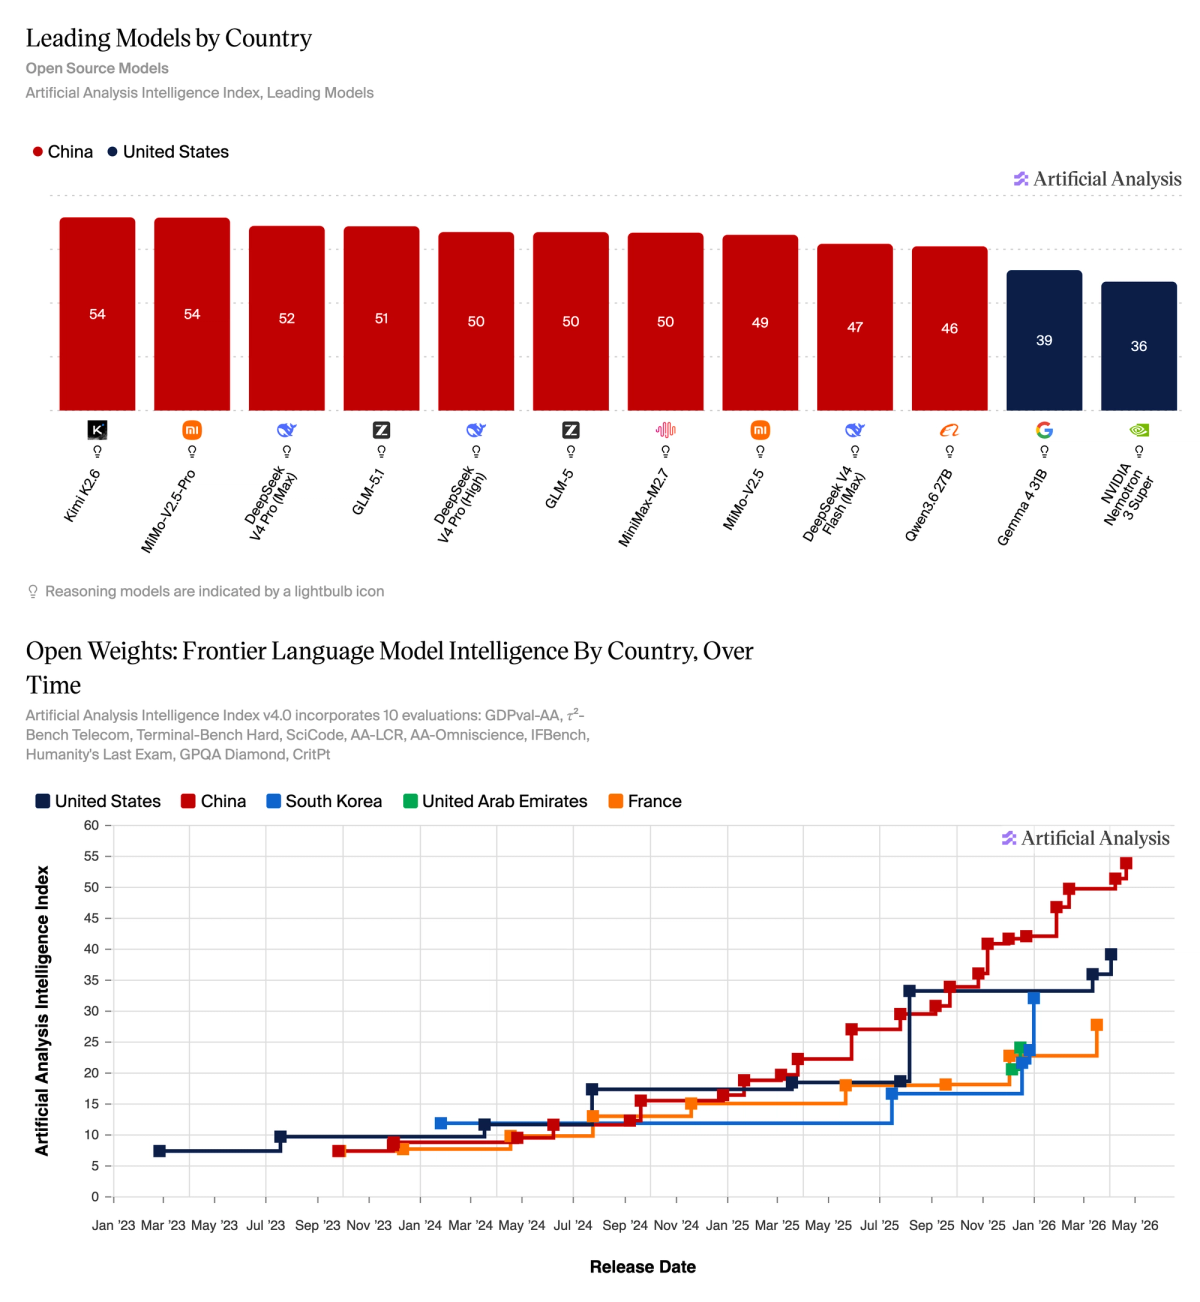
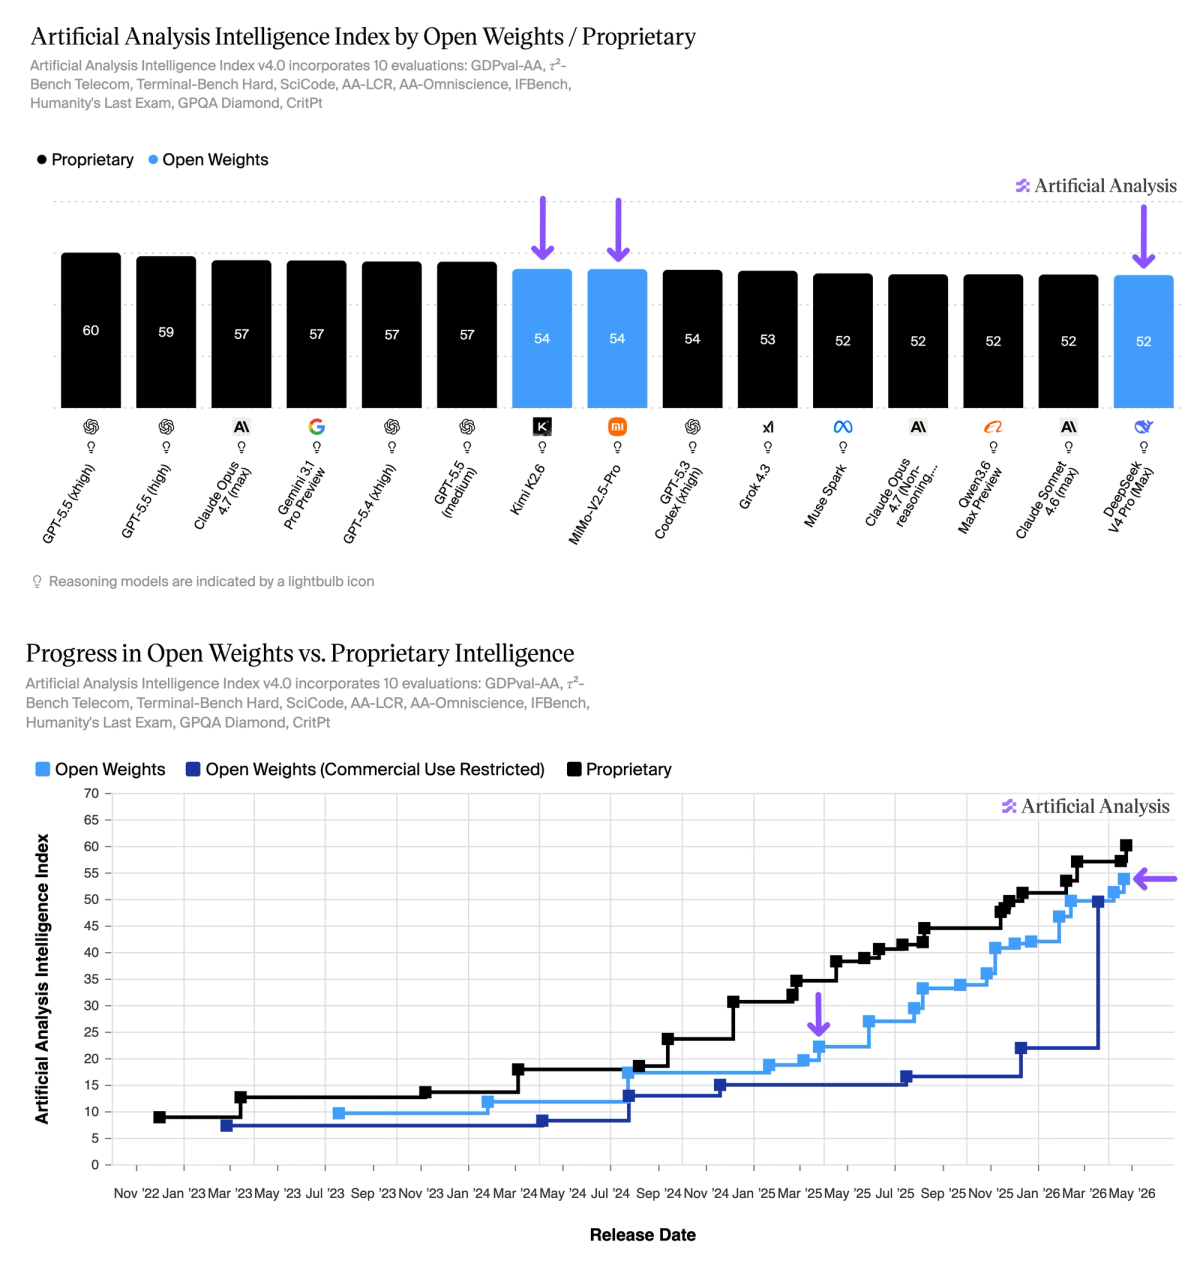
Все три ведущие модели с открытыми весами были выпущены на прошлой неделе. Продолжается прогресс среди моделей с открытыми весами наряду с проприетарными, при этом отставание от GPT-5.5, ведущей запатентованной модели, занимает 6 пунктов в индексе искусственного интеллекта.
Kimi K2.6 (Рассуждение) от Moonshot AI и MiMo V2.5 Pro (Рассуждение) от Xiaomi занимают лидирующие позиции в рейтинге моделей с открытыми весами в индексе искусственного анализа интеллекта (54), а DeepSeek V4 Pro (Рассуждение, Максимальное усилие) от DeepSeeks — 52. Это ставит лучшие модели с открытыми весами в пределах 3–6 пунктов от ведущих собственных моделей: OpenAI GPT-5.5 (xhigh) на 52. 60, а также Gemini 3.1 Pro Preview от Google и Claude Opus 4.7 от AnthropicAI (Адаптивное мышление, максимальное усилие) на 57.
Для контекста: всего год назад моделью с открытыми весами, получившей самый высокий балл, была DeepSeek V3 0324, которая достигла 22-го места в индексе интеллекта и была примерно на 13 пунктов ниже собственной модели с самым высоким рейтингом, Claude 3.7 Sonnet (Reasoning) с 35-м баллом.
Ключевые выводы:
➤ Три наиболее интеллектуальных модели с открытым весом представляют собой архитектуры MoE с числом триллионов и более параметров и разрешительными лицензиями. Kimi K2.6 (Рассуждение) имеет общее количество 1Т/32Б активных параметров с контекстным окном 256К, MiMo V2.5 Pro (Рассуждение) имеет общее количество 1Т/42Б активных с контекстным окном 1М, а DeepSeek V4 Pro (Рассуждение, максимальное усилие) имеет общее количество 1,6Т/49Б активных с контекстным окном 1М.
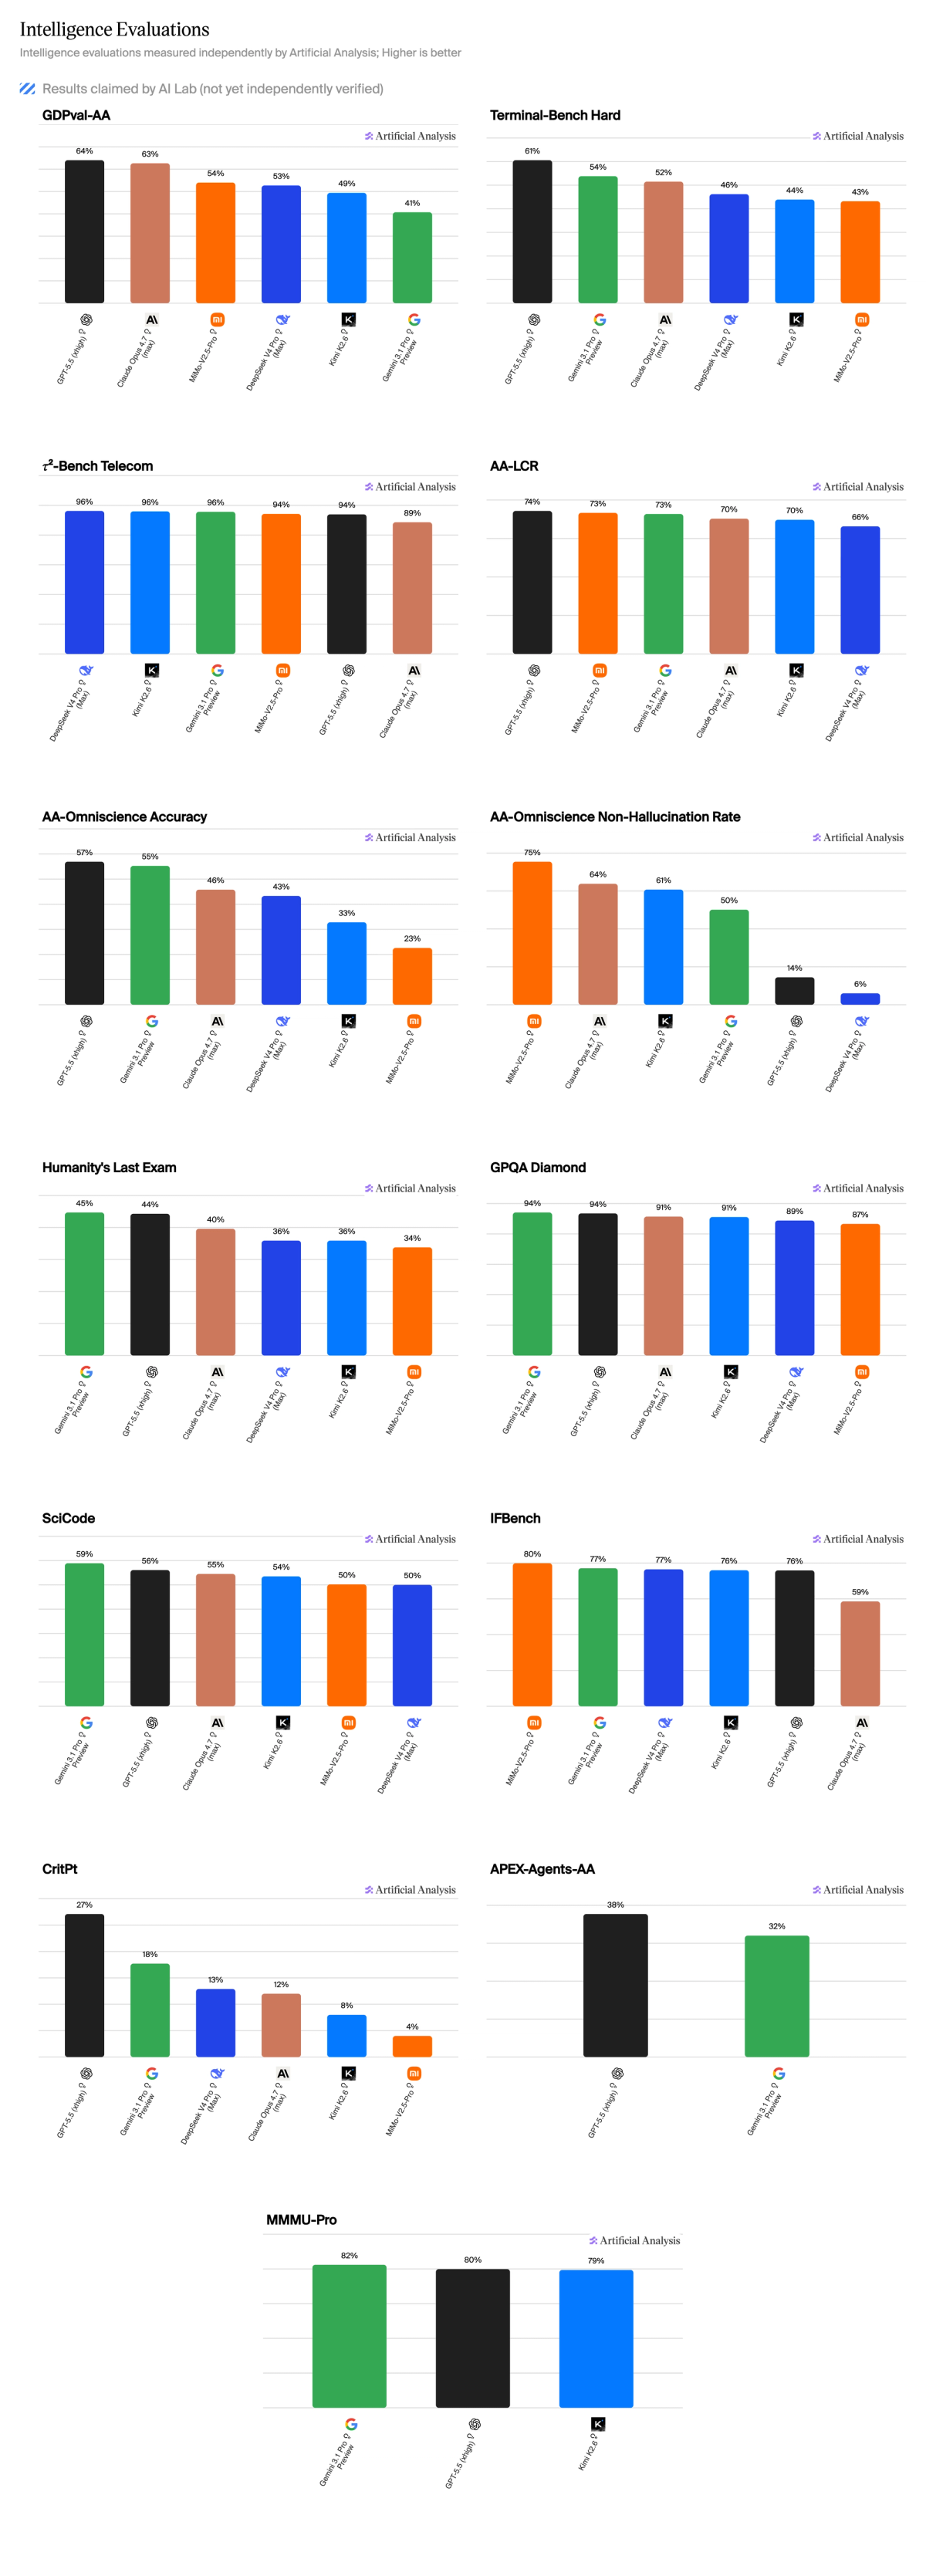
➤ Разрыв с проприетарным кодированием остается большим при самых сложных рассуждениях и оценках агентного кодирования. На HLE (Последний экзамен человечества) три лучшие модели с открытым весом набирают 34–36% по сравнению с 44% для GPT-5.5 (xhigh) и 45% для Gemini 3.1 Pro Preview. По CritPt (физика исследовательского уровня) они набирают 4–12% по сравнению с 27% для GPT-5,5 (xhigh). На TerminalBench Hard (агентное кодирование и использование терминала) они набирают 43–46% против 61% для GPT-5.5 (xhigh) и 54% для Gemini 3.1 Pro Preview.
➤ Всеведение (знание + галлюцинация) демонстрирует большой разрыв с проприетарными моделями: DeepSeek V4 Pro (Рассуждение, Максимальное усилие) галлюцинирует значительно больше, чем его аналоги с открытыми весами. DeepSeek V4 Pro (Рассуждение, Максимальное усилие) получает оценку -10, MiMo V2.5 Pro (Рассуждение) +4 и Kimi K2.6 (Рассуждение) +6. Для сравнения: GPT-5.5 (xhigh) набирает +20, Claude Opus 4,7 (Адаптивное мышление, максимальное усилие) +26 и Gemini 3.1 Pro Preview +33.
Ведущие модели с открытыми весами производятся в китайских лабораториях искусственного интеллекта. Все 10 лучших моделей с открытыми весами в индексе интеллекта созданы китайскими лабораториями искусственного интеллекта. Двумя самыми высокими из лабораторий за пределами Китая являются Gemma 4 31B (Reasoning) и NVIDIA Nemotron 3 Super (Reasoning).
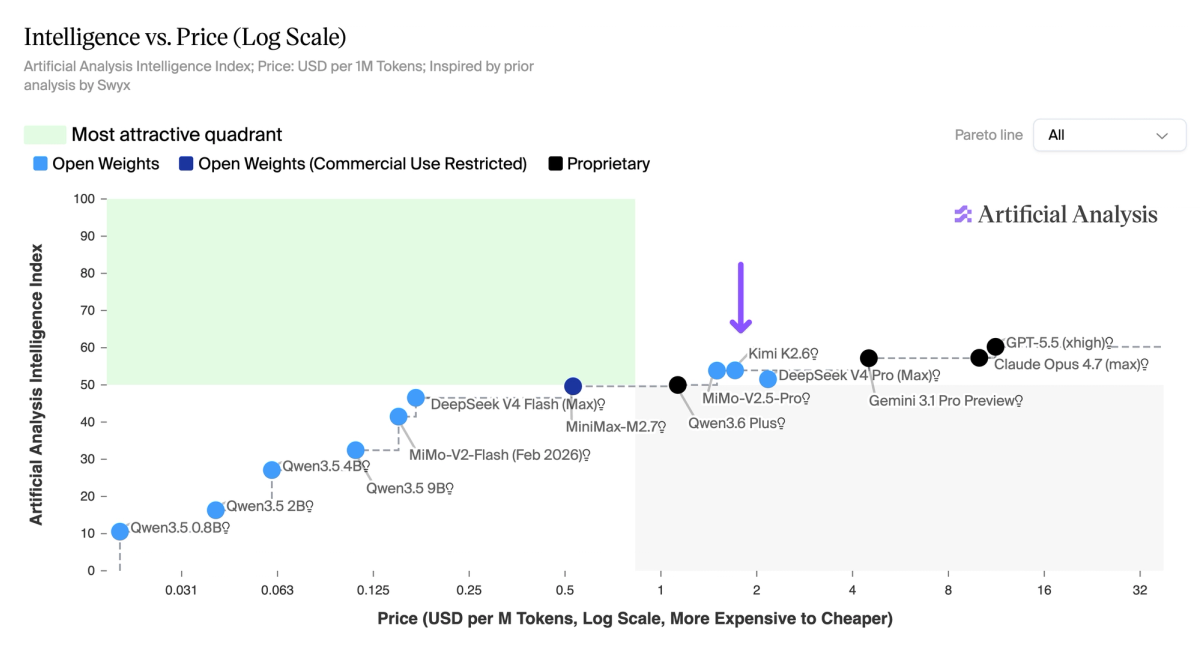
Открытые веса доминируют на границе Парето в соотношении интеллекта и цены. 9 из 13 моделей на границе Парето являются моделями с открытыми весами (включая MiniMax M2.7). Kimi K2.6 (Рассуждение) и MiMo V2.5 Pro (Рассуждение) находятся на границе Парето, а DeepSeek V4 Pro (Рассуждение, Максимальное усилие) находится чуть ниже. Эти три модели обладают интеллектом, сопоставимым с ведущими патентованными моделями, и стоят от половины до одной шестой цены.
Полные результаты индекса интеллекта для Kimi K2.6 (Рассуждение), MiMo V2.5 Pro (Рассуждение), DeepSeek V4 Pro (Рассуждение, Максимальное усилие) и ведущих патентованных моделей здесь