Grok 4.6 возвращает xAI в число лидеров по интеллекту и стоимости
Детальный анализ Grok 4.6: агрессивная ценовая политика и высокая производительность в технических задачах.
Grok 4.6 от SpaceXAI набрал 61 балл в индексе искусственного анализа интеллекта, встав в один ряд с GPT-5.6 Sol, с выдающейся агентской производительностью при меньших затратах.
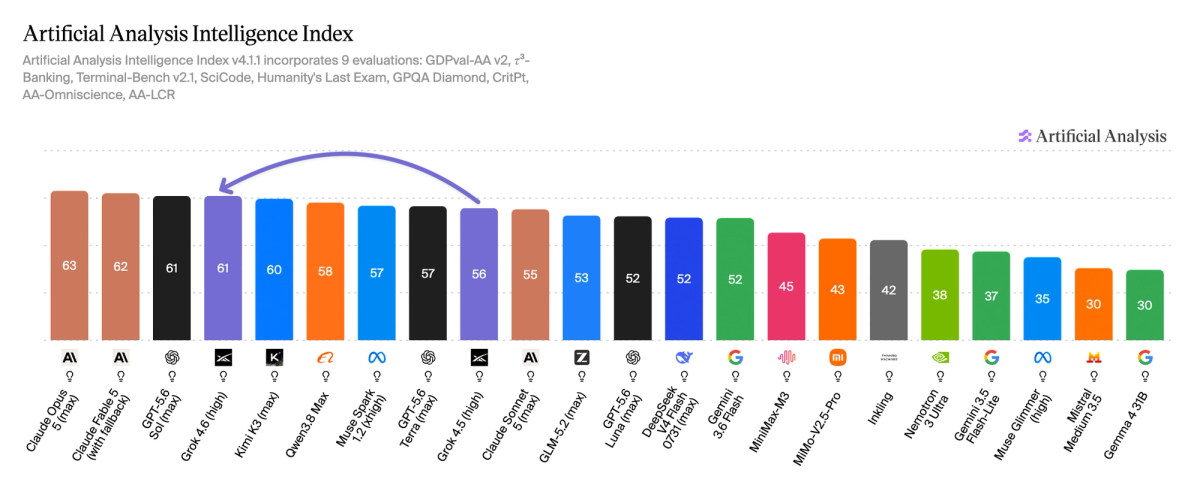
Grok 4.6 набирает 5 баллов по сравнению с Grok 4.5 по индексу интеллекта чуть более чем через месяц после его выпуска, или +23 балла по сравнению с Grok 4.3. Это возвращает SpaceXAI на передовой уровень интеллекта наряду с OpenAI, уступая только Anthropic.
Ключевые выводы: ➤ Grok 4.6 выходит на передний план индекса искусственного анализа интеллекта: он набирает 61 балл, что соответствует GPT-5.6 Sol (максимум), уступает Claude Opus 5 (максимум, 63) и Claude Fable 5 (максимум с резервным вариантом, 62) и чуть опережает Kimi K3.
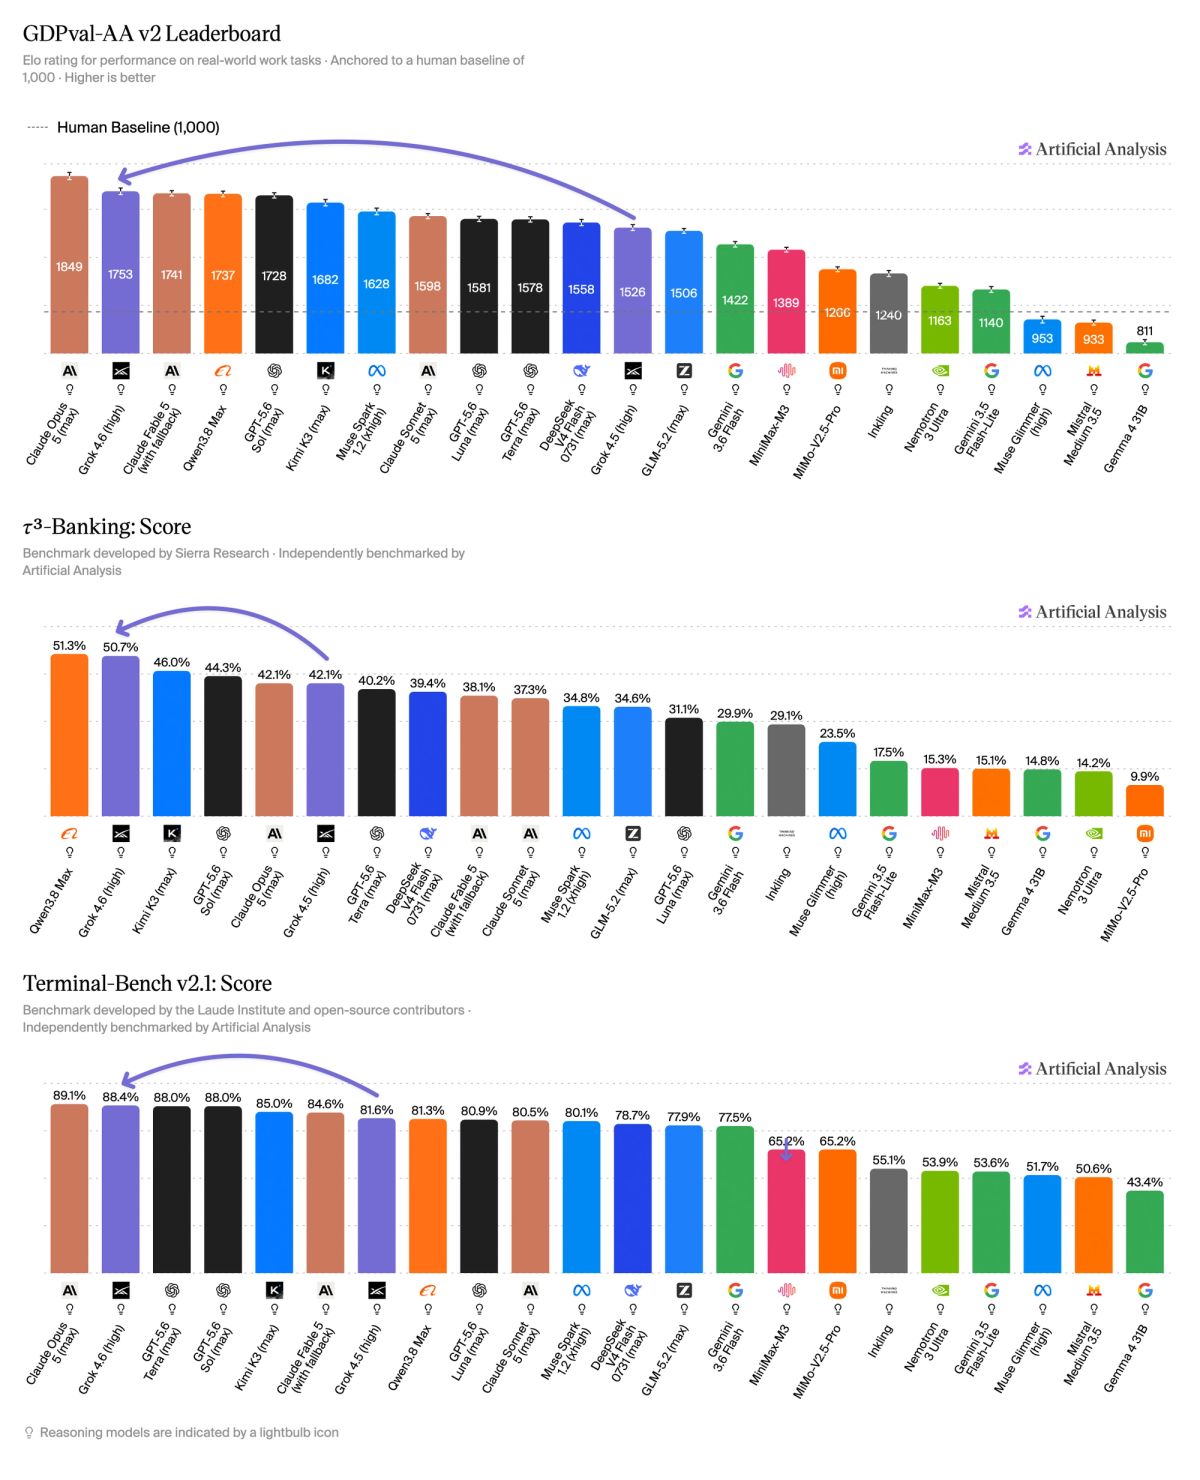
➤ Высокая агентская производительность: Grok 4.6 достигает показателя GDPval-AA v2 Elo 1753, уступая только Claude Opus 5 и перекрываясь доверительными интервалами с Claude Fable 5 и Qwen3.8 Max. Он набирает 50,7% по 𝜏³-Banking, входит в два верхних рейтинга вместе с Qwen3.8 Max (51,3%) и 88,4% по Terminal-Bench v2.1, что соответствует ведущим моделям.
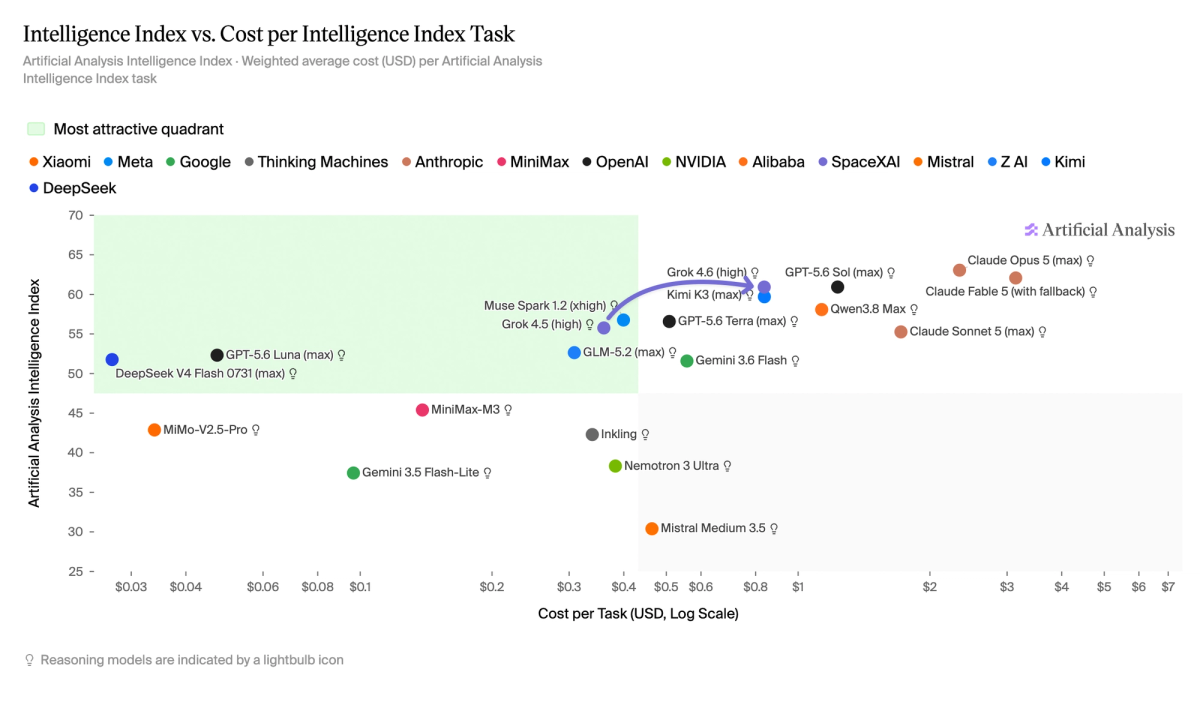
➤ Интеллект на переднем уровне с меньшими затратами: основная цена не изменилась с Grok 4.5 и составляет 2/6 долларов США за 1 миллион токенов ввода/вывода, что более чем на 60% ниже Claude Opus 5 (5 долларов США/25 долларов США) и GPT-5.6 Sol (5 долларов США/30 долларов США). Это стоило 0,84 доллара за задачу, как и Kimi K3 с немного более высоким интеллектом, что помещало его на границу Парето интеллекта и стоимости за задачу.
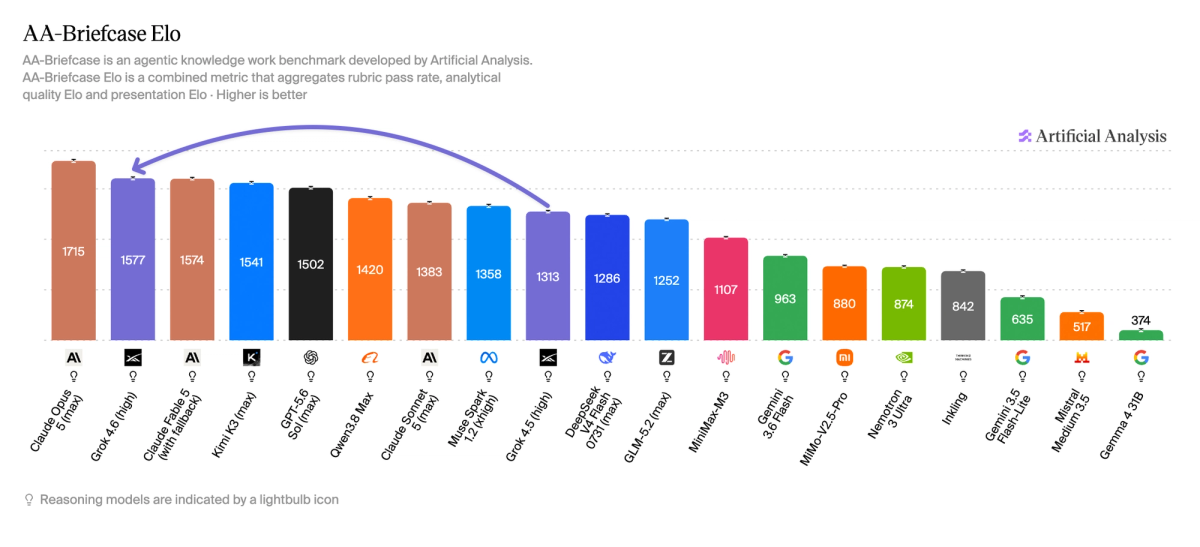
➤ Grok 4.6 находится на 5-м уровне Fable в AA-Briefcase, нашем частном эталоне долгосрочных задач агентской работы с знаниями, с рейтингом Elo 1577 - позади семейства Claude Opus 5. Он особенно эффективен, выполняя задачи в среднем за ~ 53 хода и ~ 0,5 млрд входных жетонов по сравнению с ~ 103 ходами и ~ 2,0 млрд входных жетонов для Claude Opus 5 (максимум).
Другие подробности модели: ➤ Контекстное окно с 500 тыс. токенов (без изменений с Grok 4.5).
➤ Цена $2/$6 за 1 миллион токенов ввода/вывода; попадания в кеш снижены до 0,5 доллара США за 1 миллион токенов, что больше, чем в Grok 4.5, где он составлял 0,3 доллара США за 1 миллион токенов за попадания в кеш.
Самые сильные результаты Grok 4.6 получены в области агентной работы, а не статического рассуждения. По GDPval-AA v2, нашему ведущему показателю работы агентов в реальном мире, он набирает рейтинг Elo 1753, уступая только Claude Opus 5, и статистически неотличим от Claude Fable 5 и Qwen3.8 Max, учитывая перекрывающиеся доверительные интервалы.
Эта закономерность сохраняется для всех типов задач. 𝜏³-Banking (50,7%) тестирует многооборотное обслуживание клиентов с использованием инструментов и помещает Grok 4.6 в два лучших, а Terminal-Bench v2.1 (88,4%) ставит его в один ряд с лидерами по задачам программного обеспечения на базе терминалов. Лишь немногие модели одновременно конкурентоспособны в сфере умственной работы, обслуживания клиентов и использования терминалов; В сочетании с ценой это ставит Grok 4,6 на границу Парето по соотношению затрат и производительности для каждой агентской оценки в Индексе интеллекта.
Сохранение неизменных цен на протяжении поколения является необычным для передовых стран, где рост разведки обычно сопровождался ростом цен. Grok 4.6 обеспечивает прирост индекса интеллекта на 5 пунктов при неизменной цене 2/6 долларов США, а наши измеренные затраты на задачу в 0,84 доллара отражают как эту цену, так и разумную эффективность токена.
Для покупателей важно сравнение с моделями, набравшими баллы в пределах двух баллов: Claude Opus 5 по цене 5/25 долларов и GPT-5.6 Sol по цене 5/30 долларов. Grok 4.6 фактически предлагает тот же показатель индекса интеллекта, что и GPT-5.6 Sol, но за долю от цены выходного токена, которая является параметром, который доминирует в стоимости в рабочих нагрузках, требующих большого количества рассуждений.
Grok 4.6 дебютирует в AA-Briefcase, нашем частном эталоне долгосрочных задач агентской работы с знаниями, с рейтингом Elo 1577. Это ставит его на 5-й уровень Fable после семейства Claude Opus 5, с неизменно высокими показателями по классификации рубрик, качеству представления и аналитическому качеству, а не силой в одном измерении, компенсирующей слабость в другом.
Профиль эффективности так же примечателен, как и оценка. Grok 4.6 решает задачи в среднем за ~53 хода и ~0,5B входных жетонов, против ~103 ходов и ~2,0B входных токенов для Claude Opus 5 (максимум). Долгосрочная агентская работа быстро накапливает контекст, поэтому модель, которая дает сопоставимый ответ за половину ходов и четверть входных токенов, имеет ценовое преимущество, значительно превосходящее цену за токен.
Полная разбивка отдельных оценок в Индексе искусственного анализа интеллекта