Бенчмарки GPT-5.6: замеры интеллекта, скорости и затрат
Независимые результаты тестирования флагмана OpenAI: сравнение с семейством Claude и Gemini на актуальных задачах.
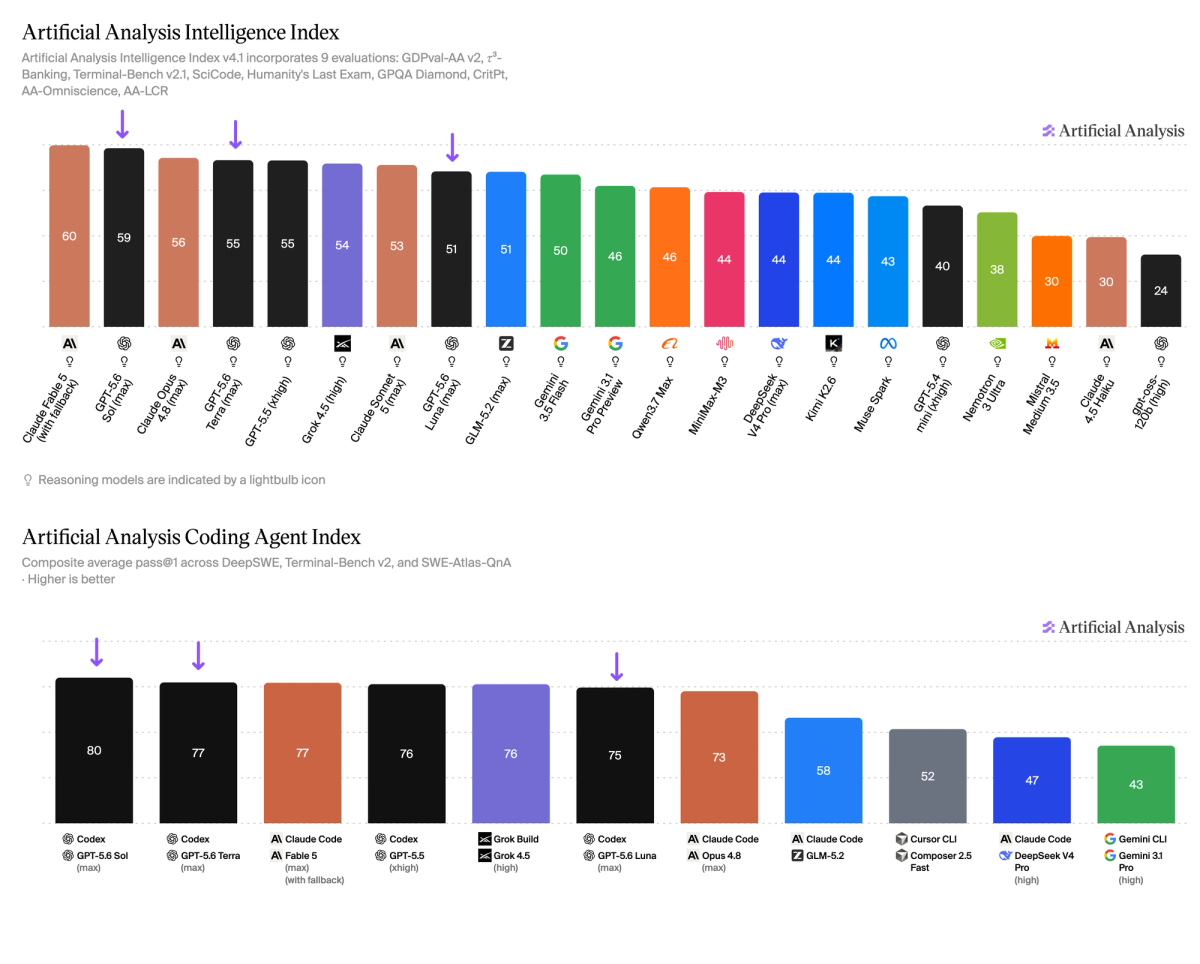
GPT-5.6 Sol находится на втором месте после Claude Fable 5 в индексе искусственного анализа интеллекта (одна треть стоимости) и лидирует в индексе кодирующего агента искусственного анализа в системе OpenAI Codex.
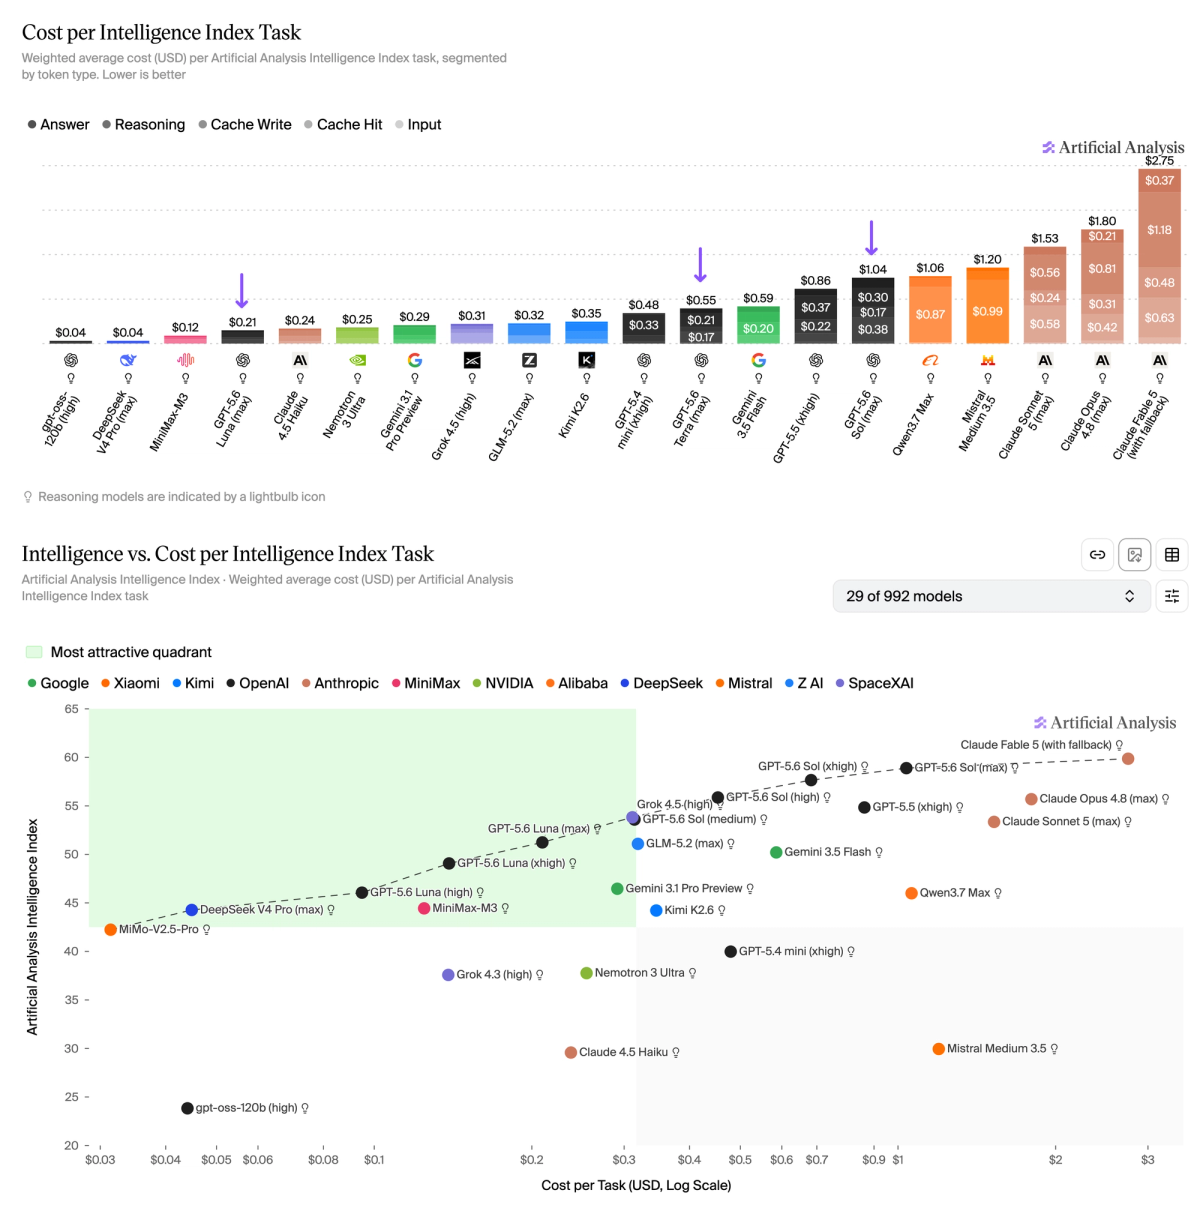
Мы поддержали OpenAI, выпустив предварительную оценку GPT-5.6 Sol, Terra и Luna. GPT-5.6 Sol (макс.) набирает на 1 балл ниже Claude Fable 5 (макс.) в индексе искусственного интеллекта анализа и составляет 59 баллов, что составляет примерно одну треть стоимости. GPT-5.6 Терра (макс.) и Луна (макс.) набирают 55 и 51 балл соответственно в Индексе интеллекта, при этом стоимость выполнения задачи на ~50% и ~80% ниже, чем у Сола.
GPT-5.6 Sol (max) лидирует в индексе кодирующего агента искусственного анализа с 80 баллами.
Ключевые выводы
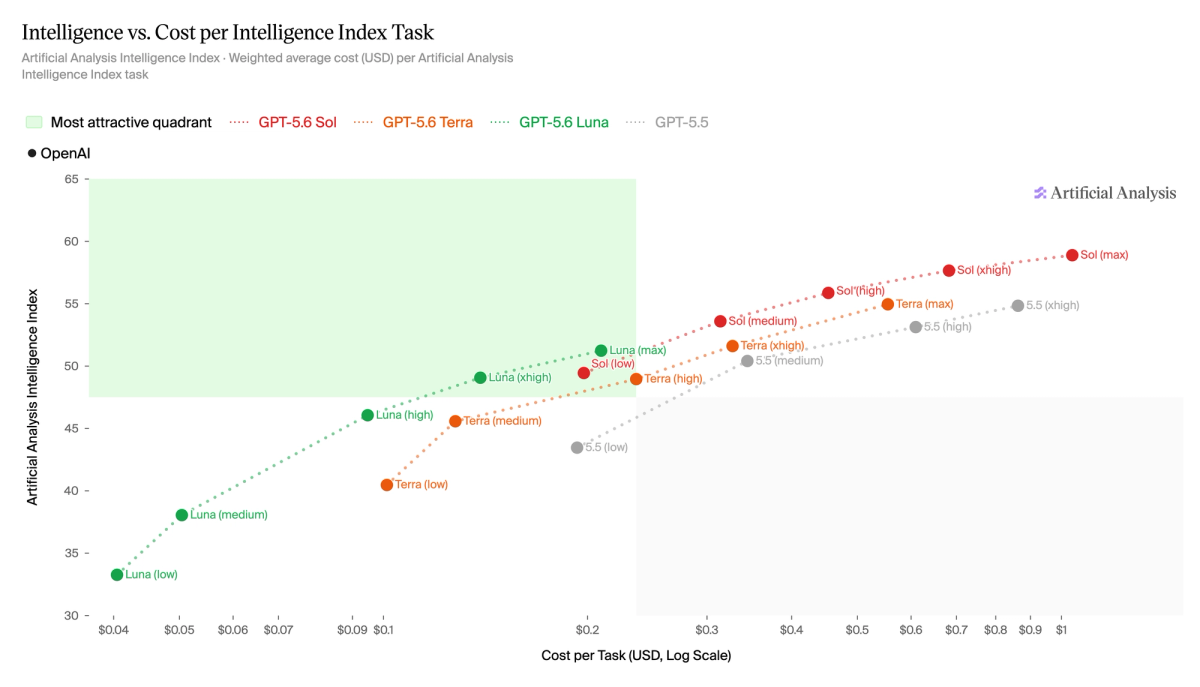
➤ Одна треть стоимости Claude Fable 5: при максимальных усилиях по рассуждению GPT-5.6 Sol стоит 1,04 доллара за задачу в индексе искусственного анализа интеллекта, предлагая уровень интеллекта, аналогичный Claude Fable 5, примерно за одну треть стоимости. Уровни рассуждения в GPT-5.6 Sol и Luna предлагают ряд вариантов на границе Парето между интеллектом и стоимостью за задачу. Например, GPT-5.6 Luna (макс.) соответствует или превосходит по интеллекту GLM-5.2 (макс.) и Gemini 3.5 Flash при более низкой цене. GPT-5.6 Terra (максимум) и Luna (максимум) стоят 0,55 и 0,21 доллара за задачу индекса интеллекта, что на ~ 50% и ~ 80% меньше, чем Sol. В ходе рассуждений каждая новая модель GPT-5.6 превосходит GPT-5.5 на границе Парето (исключая нерассуждение). Примечательно, что Луна и Солнце всегда находятся на границе Парето впереди Терры. Это означает, что для любого уровня усилий Терры существует уровень усилий Луны или Солнца, который более интеллектуален без дополнительных затрат или одинаково интеллектуален с меньшими затратами.
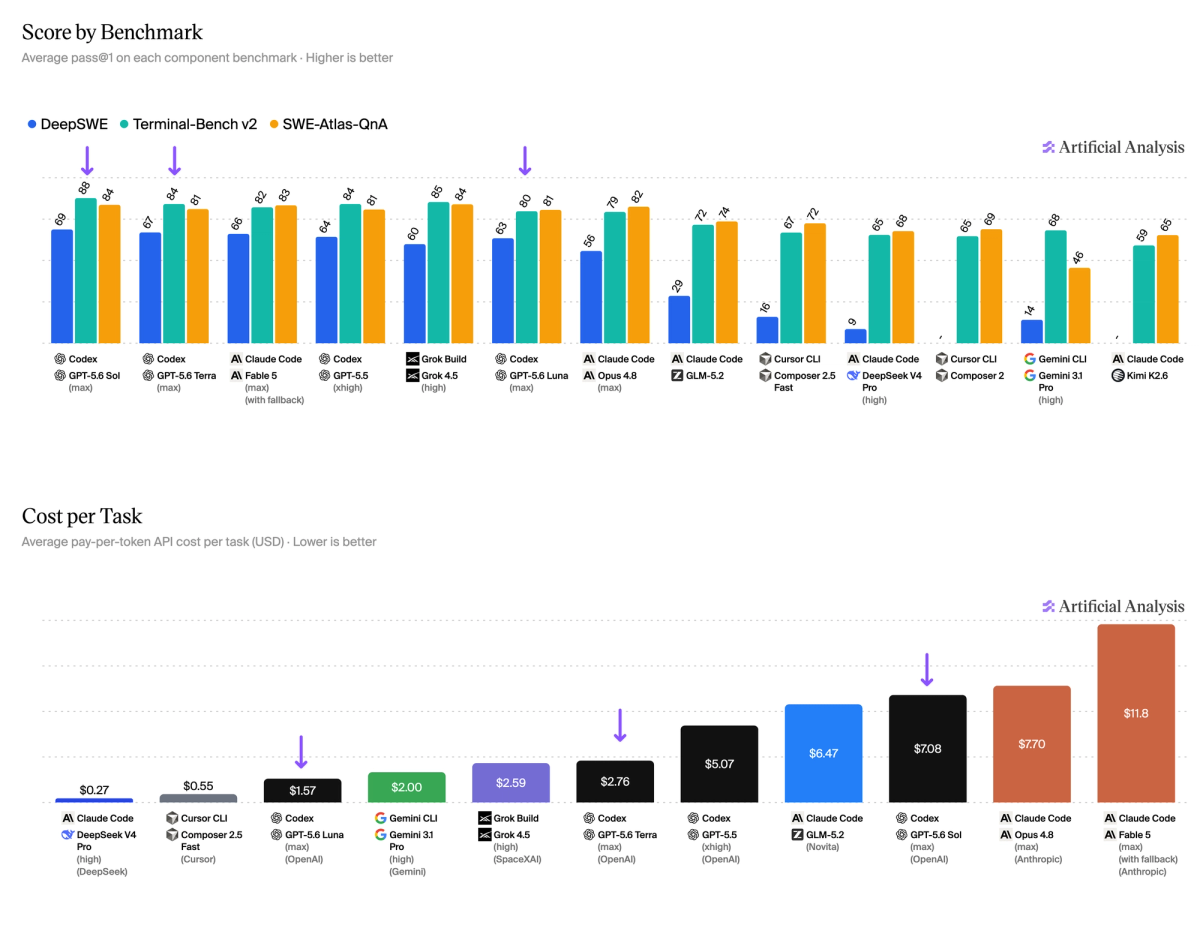
➤ Лидерство во всех оценках агентов кодирования: новый индекс агентов кодирования искусственного анализа сочетает модели с агентными средствами и включает три передовые оценки кодирования — DeepSWE, Terminal-Bench v2 и SWE-Atlas-QnA. GPT-5.6 Sol (макс.) в Кодексе набирает 80 баллов в индексе, лидируя во всех трех оценках (сравнивая Grok 4.5 в Grok Build для SWE-Atlas-QnA). Помимо более высокого результата, стоимость каждой задачи на ~ 40% и ~ 10% дешевле, чем у Claude Fable 5 (максимум) и Opus 4.8 (максимум) соответственно в Claude Code. GPT-5.6 Terra (макс.) и Luna (макс.) набрали 77 и 75 баллов в Индексе кодирующего агента соответственно, что означает снижение затрат на задачу на ~60% и ~80% по сравнению с Sol.
➤ Самый высокий показатель Эло презентации в портфеле AA: GPT-5.6 Sol (макс.) занимает второе место после Claude Fable 5 (макс.) в портфеле AA и имеет самый высокий показатель Эло презентации среди всех моделей. AA-Briefcase — это новый эталон для тестирования моделей реалистичных задач работы с знаниями в сложных проектах, созданных отраслевыми экспертами. GPT-5.6 Sol (макс.) имеет самый высокий показатель Presentation Elo — его выходные данные для файлов различных типов, включая PowerPoint и Excel, являются наиболее визуально привлекательными среди всех моделей. Fable 5 (макс.) по-прежнему лидирует в рейтинге AA-Briefcase, во многом благодаря рейтингу рубрики 56% против 42% у GPT-5.6 Sol (макс.). Fable 5 (макс.) также набирает 1764 балла по аналитическому качеству Elo против GPT-5.6 Sol (макс.) — 1592.
➤ Первые модели OpenAI с ценами на запись в кэш: GPT-5.6 впервые в OpenAI представляет цену на запись в кэш. Стоимость Sol, Terra и Luna составляет 5 долларов США/30 долларов США, 2,5 долларов США/15 долларов США и 1 доллар США/6 долларов США соответственно за миллион токенов ввода/вывода. OpenAI сохранила свою предыдущую скидку в 90% на чтение кэша, но присоединяется к Anthropic, введя надбавку к стоимости записи в кэш, в 1,25 раза превышающую цену входных токенов. Запись в кэш происходит, когда входные токены фиксируются в памяти. Плата за запись в кэш более точно отражает стоимость обслуживания модели, поскольку кэшированные токены занимают память независимо от того, используются ли они повторно или нет. Также в соответствии с моделями Anthropic GPT-5.6 обеспечивает максимальный уровень рассуждения.
➤ Низкое использование токенов: GPT-5.6 Sol (макс.) использует меньше выходных токенов, чем большинство моделей сопоставимого интеллекта, и определяет новую границу Парето между интеллектом и выходными токенами на задачу. GPT-5.6 Sol (макс.) обеспечивает небольшое улучшение эффективности токенов: 15 000 токенов на задачу индекса интеллекта по сравнению с GPT-5.5 с 16 000. Примечательно, что он использует меньше токенов и более интеллектуален, чем Claude Opus 4.8 (максимум), GLM-5.2 (максимум) и Gemini 3.5 Flash (максимум).
GPT-5.6 Sol (макс.) предлагает уровень интеллекта, аналогичный Claude Fable 5, примерно за треть стоимости. Семейство моделей определяет новую границу Парето «Интеллект против стоимости задачи».
В ходе рассуждений каждая модель GPT-5.6 превосходит GPT-5.5 на границе Парето (исключая нерассуждение). Примечательно, что Луна и Солнце всегда находятся на границе Парето впереди Терры.
GPT-5.6 Sol (макс.) в Кодексе лидирует во всех оценках в Индексе кодирующего агента искусственного анализа (связывая Grok 4.5 в Grok Build для SWE-Atlas-QnA). У него более низкая стоимость за задачу, чем у Claude Fable 5 (максимум) и Claude Opus 4.8 (максимум).
GPT-5.6 Sol (макс.) занимает второе место после Claude Fable 5 (макс.) в портфеле AA и имеет самый высокий показатель Эло презентации среди всех моделей.
GPT-5.6 Sol определяет новую границу Парето между интеллектом и выходными токенами на задачу в индексе интеллекта искусственного анализа. Терра и Луна не находятся на границе Парето.
GPT-5.6 Sol (макс.) оценивается аналогично Claude Fable 5 (макс.) в GDPval-AA v2, что отражает аналогичную способность выполнять экономически ценные задачи.
GPT-5.6 Sol (макс.) предлагает незначительное улучшение по сравнению с GPT-5.5 в Индексе всеведения АА, с небольшим повышением точности в сочетании с увеличением частоты галлюцинаций.
Разбивка отдельных оценок в индексе искусственного анализа интеллекта v4.1.