ITBench-AA: бенчмарк для проверки ИИ-агентов на реальных SRE-инцидентах
Как нейросети справляются с авариями в проде: расследование логов, поиск первопричины и применение фиксов.

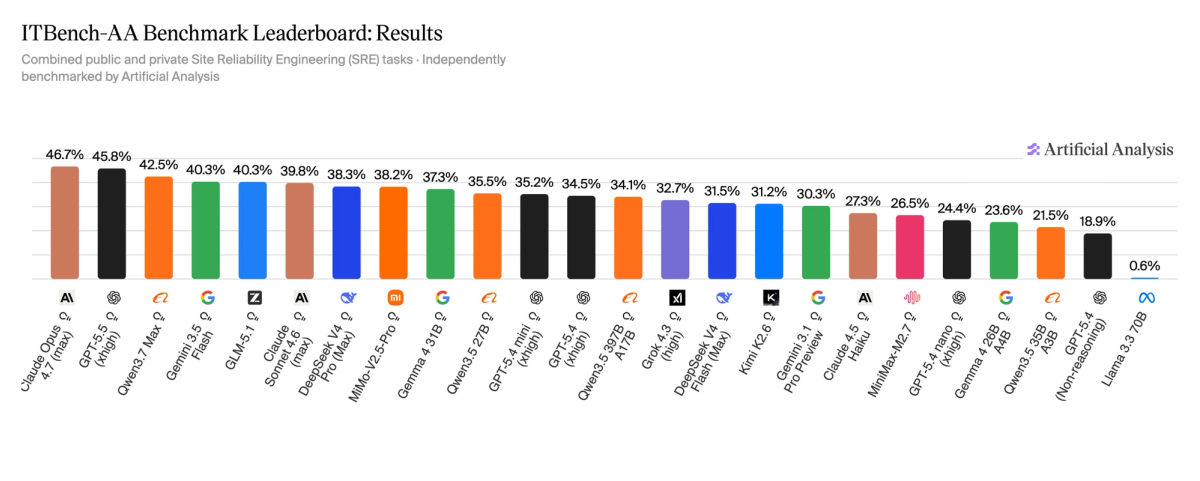
**AI Стата и IBM запускают ITBench-AA, первый из новой серии тестов, оценивающих модели агентных корпоративных ИТ-задач, начиная с задач проектирования надежности объектов, где передовые модели оцениваются ниже 50 %. **
Задача SRE ITBench-AA — оценить производительность модели при реагировании на инциденты Kubernetes, где модели должны диагностировать работающие системы путем чтения журналов, отслеживания зависимостей и выявления первопричин в сложной инфраструктуре. Базовый набор данных ITBench был разработан IBM. Лаборатория инноваций в области программного обеспечения, использующая глубокий опыт IBM в области корпоративных ИТ-операций.
Искусственный анализ тесно сотрудничал с IBM в течение последних 6 месяцев над разработкой реализации набора данных для передовой оценки ИИ, начиная с проектирования надежности объектов (SRE) и постепенно расширяясь до задач финансовых операций (FinOps) и директора по информационной безопасности (CISO).
Обзор SRE ITBench-AA
➤ Всего 59 задач SRE: 40 общедоступных задач и 19 совершенно новых, отложенных задач.
➤ Каждая задача предоставляет снимок инцидента Kubernetes, содержащий оповещения, события, трассировки, метрики, журналы и топологию приложения. Модель должна идентифицировать минимальный набор независимых объектов Kubernetes, ответственных за инцидент.
➤ Сбои охватывают типичные режимы сбоев SRE, включая инциденты инфраструктуры, служб, приложений и хаоса, такие как исчерпание квоты ресурсов, сбои развертывания, исчерпание пула соединений и сетевые разделы.
Детали методологии
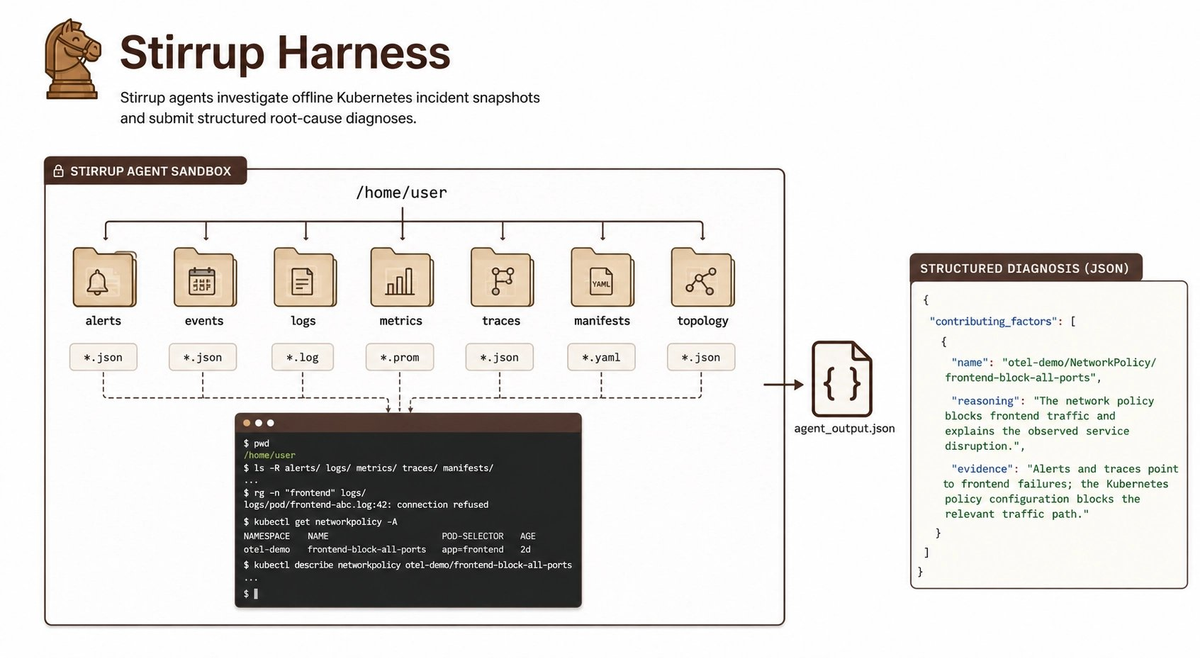
➤ Агентский пакет: каждая задача решается с помощью модели, работающей в нашем эталонном пакете Stirrup с открытым исходным кодом, с доступом оболочки к изолированной файловой системе, содержащей соответствующие журналы и снимки. Максимум 100 ходов на задание, 3 повтора на задание.
➤ Модели отправляют список основных причин (развертывания Kubernetes, службы, модули и т. д.), которые, по их мнению, стали причиной инцидента. Каждое отправленное сообщение сравнивается с набором основных причин, предоставленным IBM.
➤ Для оценки используется средняя точность при полном воспроизведении: если модель упускает какую-либо из основных причин, она получает 0,0 за это повторение. Если он идентифицирует их все, ему присваивается балл, равный его точности — доле представленных объектов, которые являются фактическими первопричинами, т. е. истинные положительные результаты / (истинные положительные результаты + ложные положительные результаты). Оценка заголовка — это среднее значение по 59 заданиям × 3 повтора.
➤ Привязь (стремя) остается неизменной для всех оцениваемых моделей, что позволяет сравнивать модели между собой.
Основные выводы
➤ Claude Opus 4.7 (Адаптивное мышление, максимальное усилие) лидирует с 47%, за ним следуют GPT-5.5 (xhigh) с 46% и Qwen3.7 Max с 42%
➤ Все пограничные модели имеют балл ниже 50%, что делает ITBench-AA SRE одним из наименее насыщенных агентных тестов в нашем наборе. Для контекста: пограничные модели оцениваются значительно выше на Terminal-Bench.
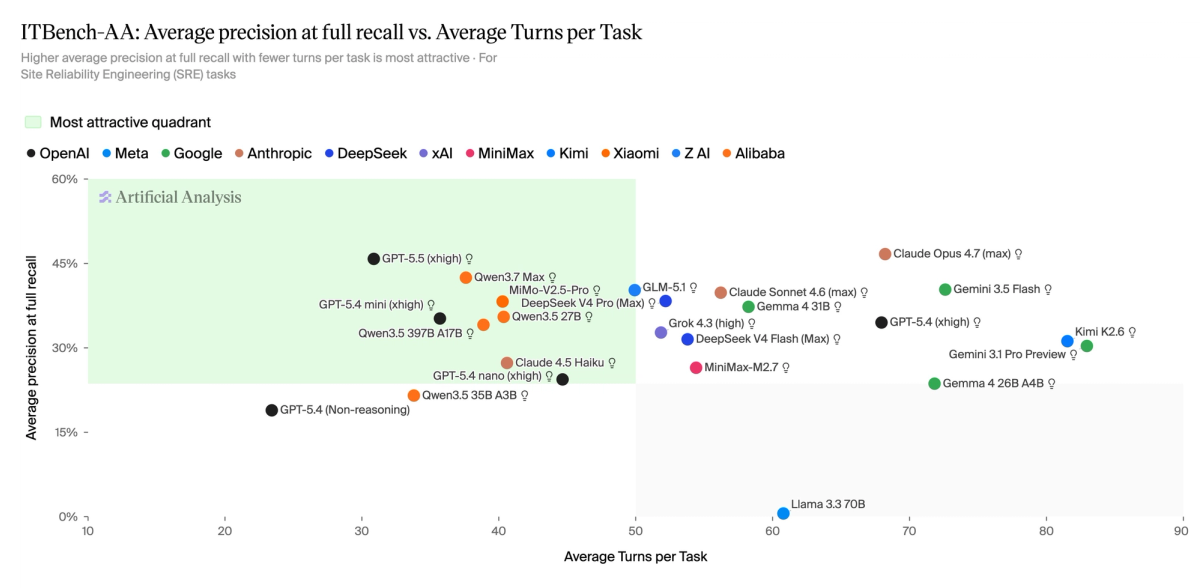
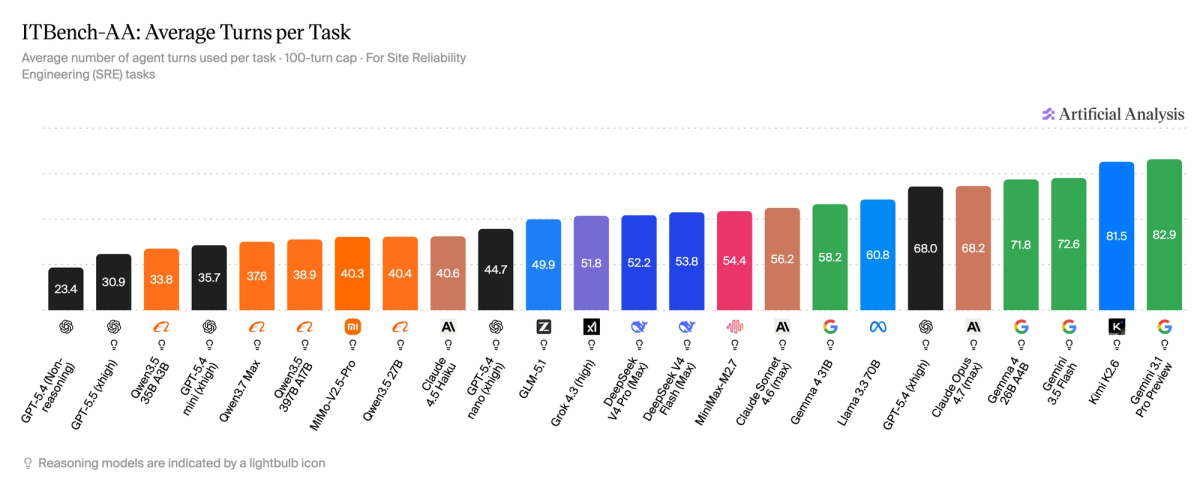
➤ Количество поворотов различается почти в 3 раза, а более длинные траектории не обеспечивают более высокую точность. GPT-5.5 (xhigh) составляет в среднем 31 ход на задачу при 46 %, а Gemini 3.1 Pro Preview — в среднем 83 хода при 30 %. Модели, в которых проводятся чрезмерные исследования, имеют тенденцию выявлять механизмы внесения ошибок или сопутствующие симптомы как ложноположительные результаты.
➤ GLM-5.1 (Рассуждение) опережает модели по открытому весу на 40%, что эффективно связано с Gemini 3.5 Flash (высокий). За ним следует DeepSeek V4 Pro (Рассуждение, Максимальное усилие) с 38%, за ним следует Gemma 4 31B (Рассуждение) с 37%, опережая Gemini 3.1 Pro Preview с 30%
Задачи требуют, чтобы агенты исследовали снимки инцидентов Kubernetes с помощью команд оболочки и отправляли структурированный диагноз JSON с указанием ответственных объектов-основных причин.
В одной общедоступной задаче SRE агент видит сбои, с которыми сталкиваются пользователи, на пути внешнего интерфейса. Он использует команды оболочки для проверки автономного снимка: при просмотре предупреждений отображается окно инцидента, а затем трассировки/журналы сужают сбой до трафика внешнего интерфейса. Топология определяет затронутые сервисы, а манифесты Kubernetes показывают, что сетевая политика блокирует интерфейс. Успешная диагностика определяет ответственный объект основной причины: otel-demo/NetworkPolicy/frontend-block-all-ports.
Больше поворотов не означает лучшие ответы. Модели, которые предоставляют дополнительные сущности, помимо истинной основной причины, подвергаются наказанию. Вот почему некоторые модели с длинными траекториями уступают более коротким: Gemini 3.1 Pro Preview в среднем делает 83 поворота и набирает 30%, а GPT-5.5 (xhigh) в среднем делает 31 поворот и набирает ~46%.