Анонс Speech Agent Arena: битва голосовых ИИ-агентов в реальном диалоге
Арена голосовых агентов: слепое сравнение задержки ответа, естественности интонаций и устойчивости к перебиваниям.
Анонсируем нашу новую арену речевого агента, которая оценивает модели преобразования речи в речь в реальных сценариях для анализа разговорных предпочтений и уровня успеха задач.
Существующие тесты Speech to Speech охватывают рассуждения, моделируемые агентские задачи и динамику разговора, такую как очередность и обработка прерываний. Speech Agent Arena сравнивает модели и каскадные системы по мере того, как люди выполняют реальные задачи, измеряя разговорные предпочтения и успешное использование инструментов. Это позволяет нам предоставить оценку, которая более точно отражает реальное использование, предлагая понимание того, с какими моделями пользователи больше всего предпочитают общаться и насколько эффективно эти модели поддерживают их запросы.
Обзор арены речевого агента и уровень успешности выполнения задач
Участники-люди сравнивают две скрытые модели речи к речи в одном и том же назначенном сценарии: один из 15 агентных сценариев (задачи, требующие вызова инструментов, например, заказ на вынос) или 20 неагентных сценариев (задачи без вызова инструментов, например, вопрос о часах работы). После отдельных живых бесед с каждой моделью участники выбирают ту, которую они предпочитают, и эти парные голоса используются для соответствия баллу Эло предпочтений. Для агентных сценариев показатель успешности задач — это доля подходящих диалогов (без отклонений участников или непроверяемых случаев), в которых модель выполнила запрошенное действие посредством правильного окончательного вызова или вызовов инструмента.
Для всех примеров, кроме записи на прием к стоматологу для новых пациентов, подсказки модели сценария, схемы инструментов и инструкции для участников в настоящее время являются конфиденциальными, чтобы уменьшить переобучение. Кроме того, Speech Agent Arena в настоящее время использует квалифицированный пул платных, проверенных сторонних участников для проведения и оценки взаимодействия агентов.
Ключевые результаты
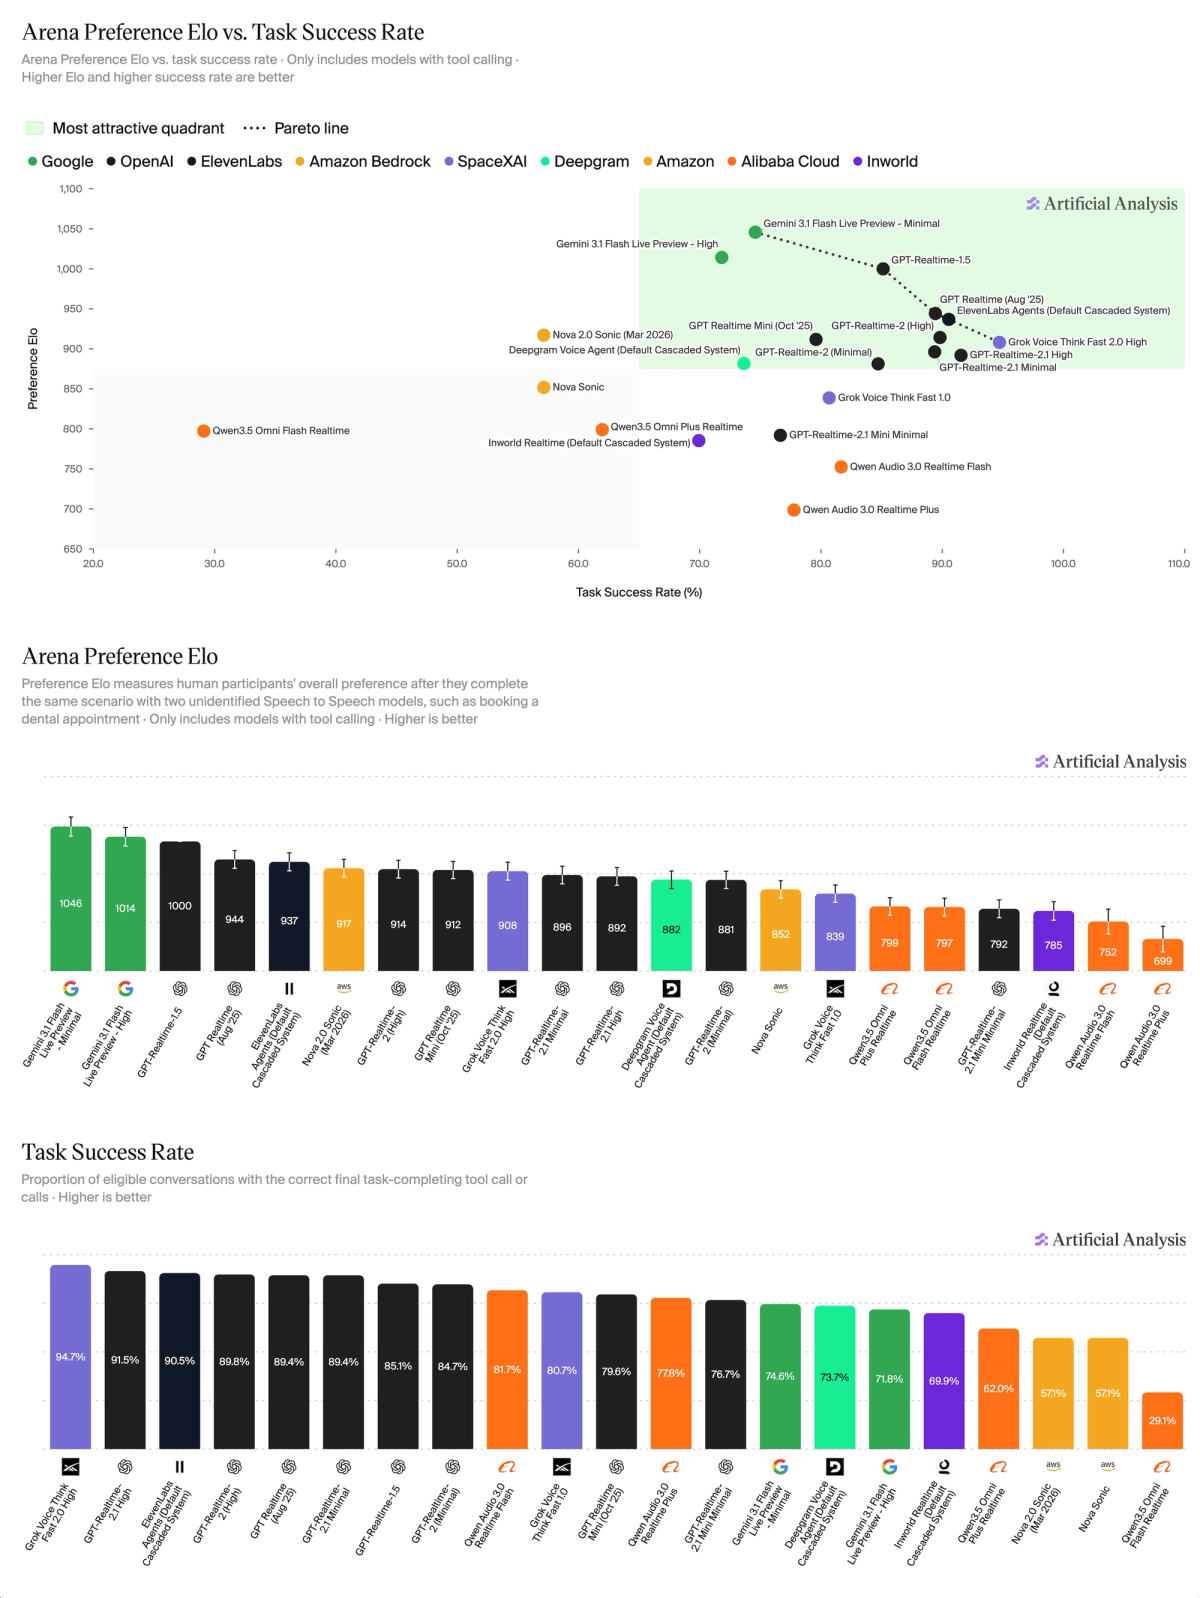
➤ Предпочтение арены Elo: GoogleAI Gemini 3.1 Flash Live Preview — минимальное число потенциальных клиентов — 1046 Elo, за ним следует Gemini 3.1 Flash Live Preview — высокий уровень — 1014, OpenAI GPT-Realtime-1.5 — 1000, GPT Realtime (25 августа 2019 г.) — 944 и ElevenLabs Agents (каскадная система Scribe v2 по умолчанию) Realtime/GPT-4o Mini/Eleven v3, с предварительно зарегистрированной схемой инструмента) 937. В рассмотренных обсуждениях наиболее предпочтительные модели имели тенденцию реагировать быстрее, звучать более естественно и издавать меньше неестественных звуков или звуковых артефактов.
➤ Показатель успешности задач: SpaceXAI Grok Voice Think Fast 2.0 High лидирует с 94,7%, за ним следуют OpenAI GPT-Realtime-2.1 High с 91,5%, ElevenLabs Agents (каскадная система по умолчанию) с 90,5% и GPT-Realtime-2 (High) с 89,8%, с GPT Realtime (25 августа) и GPT-Realtime-2.1 Minimal равен 89,4%. Предварительный просмотр Gemini 3.1 в реальном времени — общее предпочтение минимального лидера составляет 1046 Эло, но зафиксирован показатель успешности выполнения задач 74,6%, что показывает, что предпочтительный диалог не всегда приводит к успешному завершению задачи — некоторые разговоры могут звучать так, как будто запрошенное действие было завершено, даже если требуемый последний вызов инструмента оказался неудачным.
Мы продолжаем расширять охват собственных и каскадных систем речи в речь и приветствуем отзывы по мере добавления новых моделей, поставщиков и сценариев.
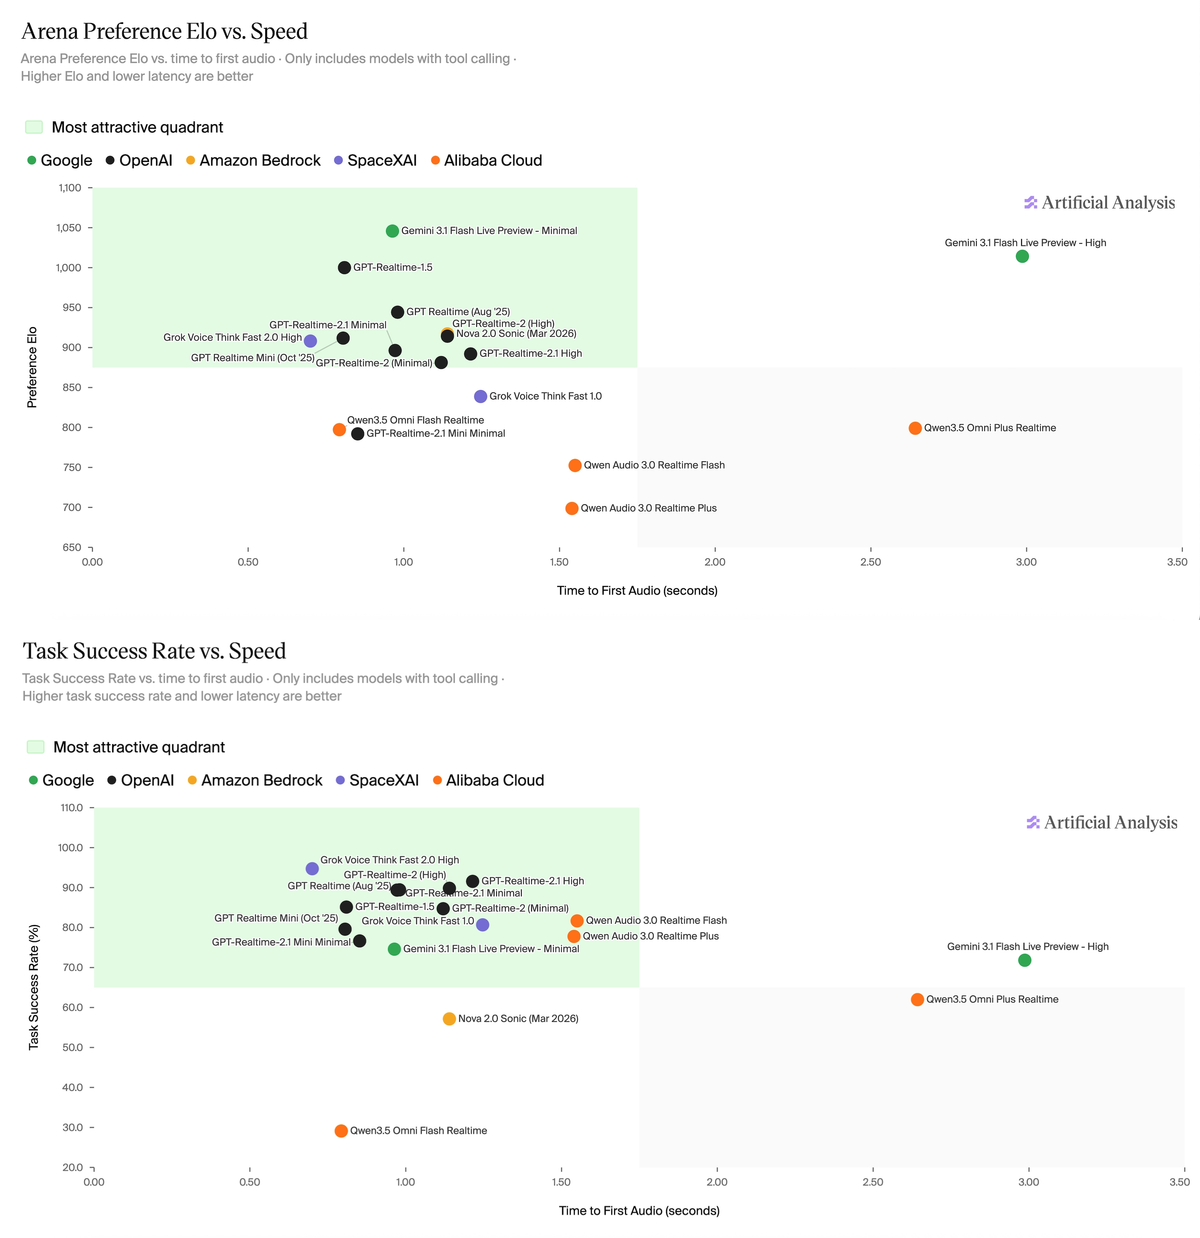
Общее предпочтение Elo обычно увеличивается по мере уменьшения времени до первого аудио (TTFA), что позволяет предположить, что отзывчивость способствует предпочтительному разговорному опыту. Gemini 3.1 Flash Live Preview — Minimal лидирует по общему предпочтению с 1046 Elo с TTFA 0,96 секунды по сравнению с GPT-Realtime-2 (High) с 914 Elo и 1,14 секунды и Qwen Audio 3.0 Realtime Plus с 699 Elo и 1,54 секунды.
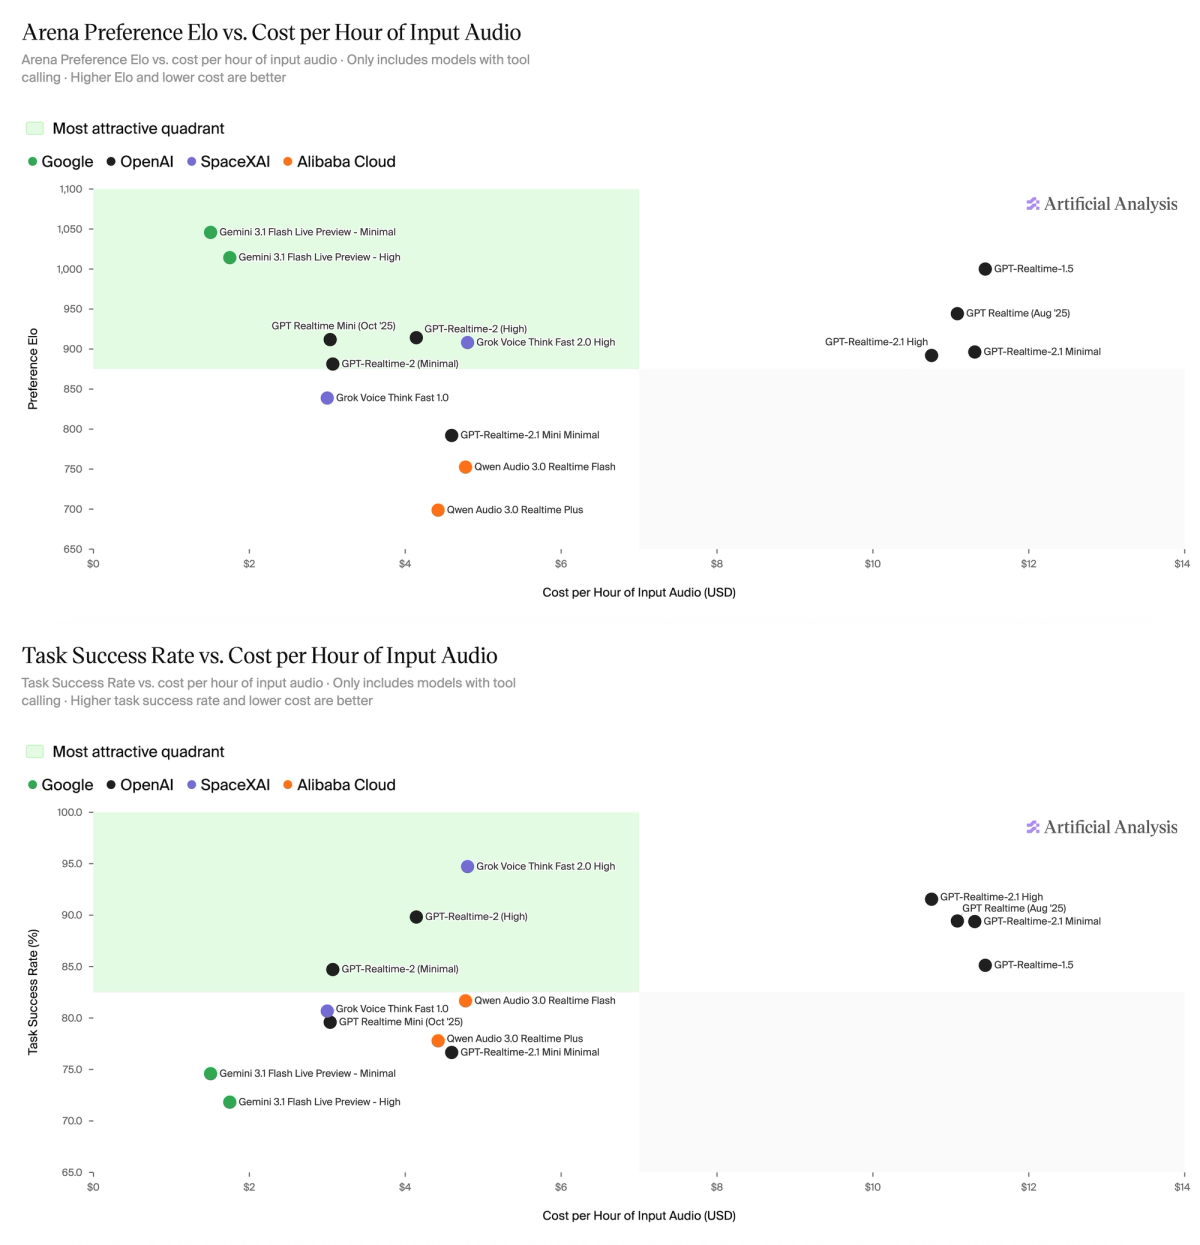
Модели добиваются сильных разговорных предпочтений и успеха в выполнении задач в существенно разных ценовых категориях. Gemini 3.1 Flash Live Preview — Minimal приводит к общему предпочтению с 1046 Эло со стоимостью 1,50 доллара США в час входного аудио и показателем успешности выполнения задач 74,6%, а Grok Voice Think Fast 2.0 High лидирует с показателем успешности выполнения задач 94,7% при 4,80 доллара США в час. GPT-Realtime-2.1 High обеспечивает успешность выполнения задачи на уровне 91,5% и стоит 10,75 долларов США в час.