Анонс Индекса открытости моделей AI Стата Openness Index
Методология оценки открытости: доступность весов, датасетов обучения, архитектурных описаний и лицензий.

Мы представляем индекс открытости искусственного анализа — стандартизированный, независимо оцениваемый показатель того, насколько «открыты» модели ИИ с точки зрения их доступности и прозрачности в отношении методологии и данных.
Открытость имеет решающее значение для заинтересованных сторон в экосистеме ИИ: она позволяет
- Исследователи должны понимать входные данные и поведение моделей с большей детализацией, а также разрабатывать и внедрять инновации в методологии и обучении.
- Разработчики должны размещать и использовать модели наиболее подходящим для своего варианта использования способом, а также обучать модели репликации или расширению возможностей модели.
- Потребители должны понимать происхождение моделей, предвзятости и другие последствия обучающих данных или методологии.
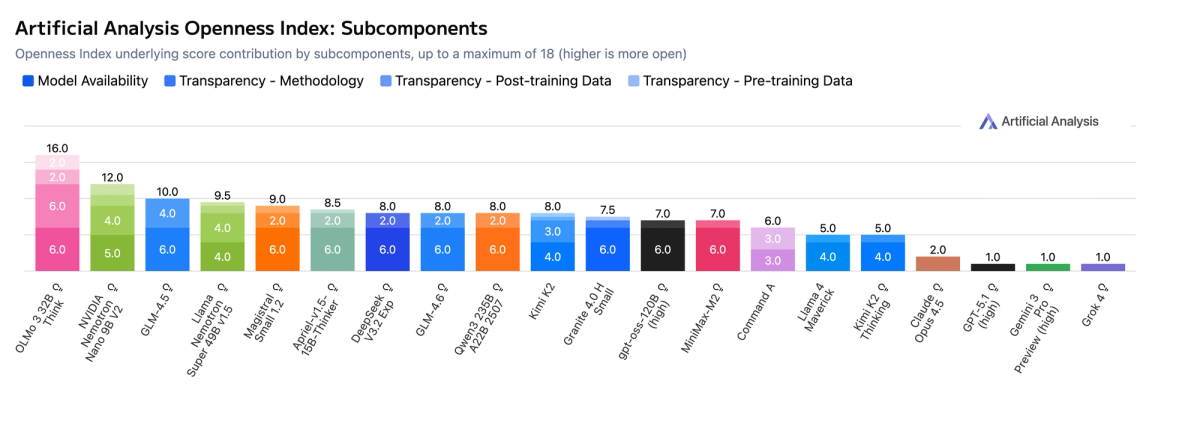
Оценка индекса открытости (отдельные модели)
Зачем нужен индекс открытости
Экосистема и индустрия искусственного интеллекта придают большое значение открытости и видимости прогресса, но существует ключевой пробел в общении и понимании этих же концепций. Сегодня открытость трудно описать или понять, и ее часто неправильно понимают.
Модели обычно называют «открытыми» или «закрытыми» в зависимости от того, можете ли вы получить доступ к их весам. Однако доступ к модели и ее использование требуют большего количества нюансов, чем одни только веса, из-за требований лицензирования. Более того, чтобы полностью проанализировать или воспроизвести модель, нужно сделать гораздо больше.
Мы считаем, что разработчики моделей ИИ заслуживают более качественных показателей, позволяющих понять, насколько открыты их модели и какую роль они призваны выполнять в экосистеме ИИ. Эти же показатели также помогают потребителям и разработчикам понять открытость и сделать выбор относительно того, какие модели использовать или создавать.
Современные языковые модели различаются по архитектуре, обучающим данным, методологии и коду. Тем не менее, зачастую эти решения, вклады и компромиссы малопрозрачны, что затрудняет исследователям копирование или развитие работы. Инновации и прозрачные выпуски, такие как DeepSeek R1, ускорили прогресс, поделившись «как» своих моделей.
Методология
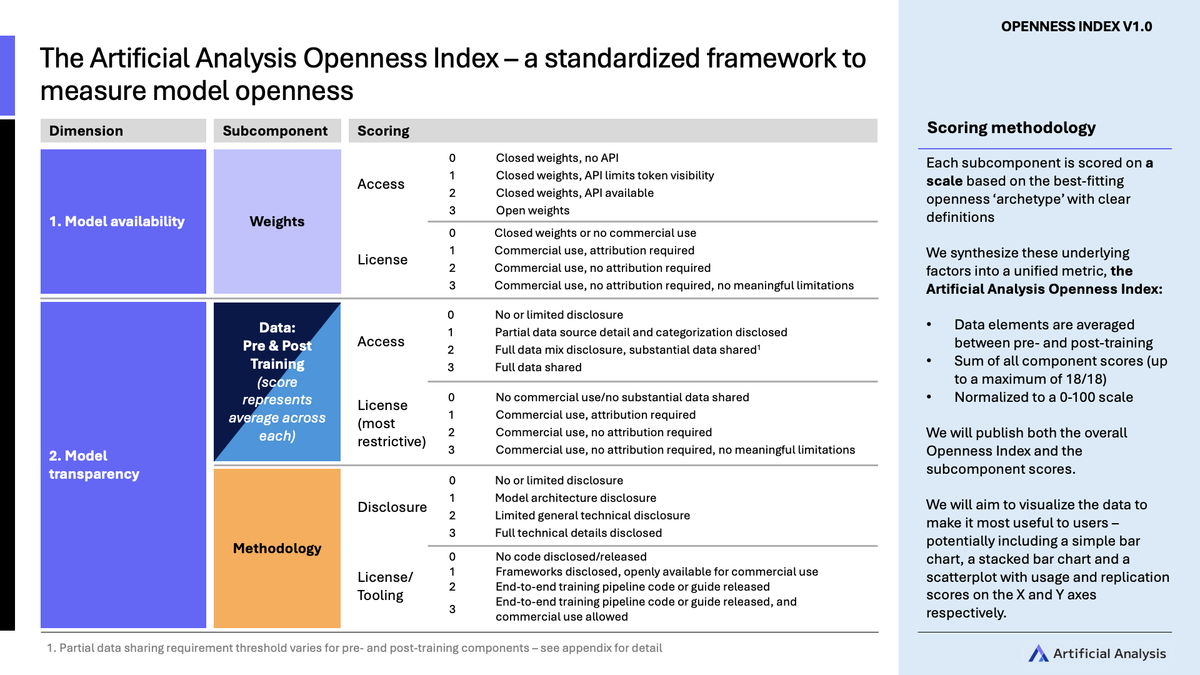
Мы разработали качественный рубрикаторный подход к индексу, который отражает наш взгляд на ключевые факторы, которые сегодня делают модели «открытыми» или «закрытыми», помимо весов моделей.
Мы признаем, что открытость предполагает компромиссы. Соображения конкуренции и безопасности могут препятствовать обмену информацией, соблюдение нормативных требований может потребовать ограничения доступа или использования, а некоторые данные могут быть пригодны для обучения, но не для раскрытия. Индекс измеряет степень открытости, не предполагая «оптимального» показателя для какого-либо конкретного сценария.
- Чтобы понять доступность и прозрачность модели, мы анализируем открытость весов модели, данных перед обучением, данных после обучения и методологии. Мы учитываем как общий доступ к ним, так и лицензирование, регулирующее их использование.
- Индекс открытости искусственного анализа использует систему баллов для категоризации моделей по этим областям, которая затем суммируется в балл индекса открытости искусственного анализа модели. Эта оценка поддерживает сравнение моделей с более высокими оценками, что указывает на большую общую открытость.
Методология высокого уровня индекса открытости
Скачать подробный методический документ (PDF)
Первоначальные выводы
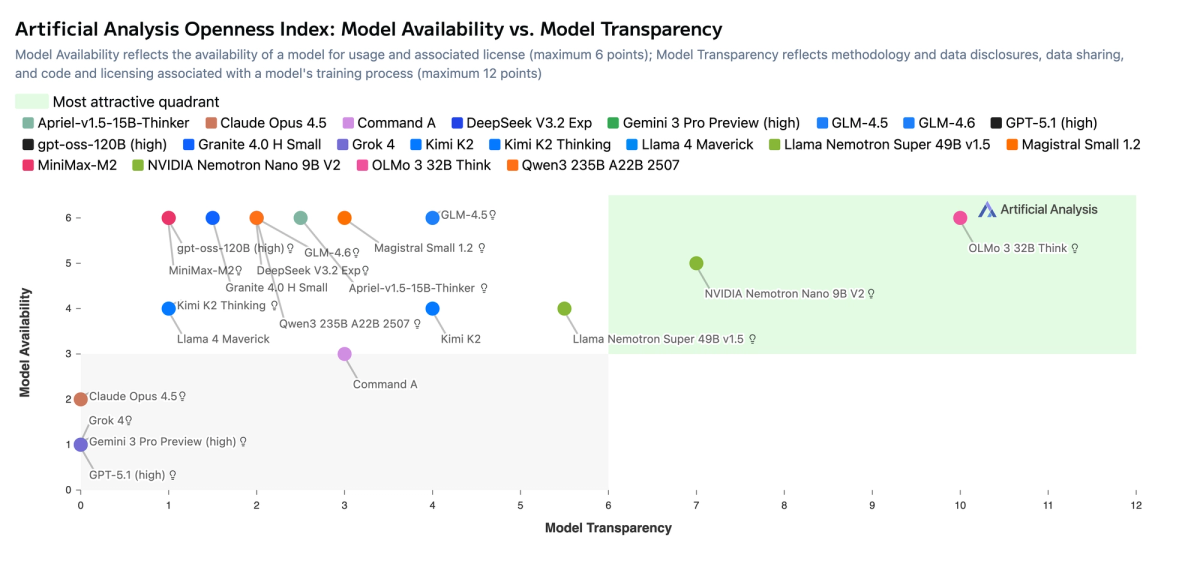
Сегодняшние модели ИИ демонстрируют широкий диапазон степеней открытости, но ни одна из моделей, которые мы оценивали для выпуска Индекса открытости, не достигла максимально возможного балла в Индексе.
- Лишь немногие модели и поставщики используют полностью открытый подход. Мы видим сильную и растущую экосистему моделей с открытыми весами, включая ведущие модели из китайских лабораторий, такие как Kimi K2, Minimax M2 и DeepSeek V3.2. Однако публикации данных и методологий происходят гораздо реже: семейство OpenAI gpt-oss является ярким примером открытых весов и лицензирования Apache 2.0, но в остальном раскрытие минимальное.
- OLMo от Allen AI (AI2) лидирует по индексу открытости на момент запуска. Выполняя миссию AI2 по обеспечению «по-настоящему открытых» исследований, семейство OLMo достигает высшего балла в 89 баллов в Индексе, отдавая приоритет полной тиражируемости и разрешенному лицензированию весов, обучающих данных и кода. С недавним запуском OLMo 3 в него вошли последняя версия данных, утилит и программного обеспечения AI2, полная информация об обучении модели рассуждения и новый набор данных Dolci после обучения.
- Семейство NVIDIA Nemotron также очень открыто. Такие модели, как NVIDIA Nemotron Nano 9B v2, достигают 67 баллов в Индексе благодаря их выпуску вместе с обширными техническими отчетами с подробным описанием процесса обучения, инструментами с открытым исходным кодом для построения моделей, а также наборами данных после обучения Nemotron-CC и Nemotron. Доступность модели и прозрачность модели (отдельные модели)
Использование индекса открытости
Индекс открытости искусственного анализа можно использовать в сочетании с нашими измерениями интеллекта, чтобы полностью понять варианты модели. Мы надеемся, что это станет отправной точкой для исследователей и лабораторий для поиска компромиссов и преимуществ, связанных с большей открытостью модельной экосистемы.
Ознакомьтесь с полным рейтингом Индекса открытости на нашей странице оценки Индекса открытости.


