Индекс интеллекта AI Стата v4.1: акцент на агентские нагрузки
Эволюция методологии: почему простые тесты с выбором ответа уходят в прошлое и как оценивать автономных агентов.
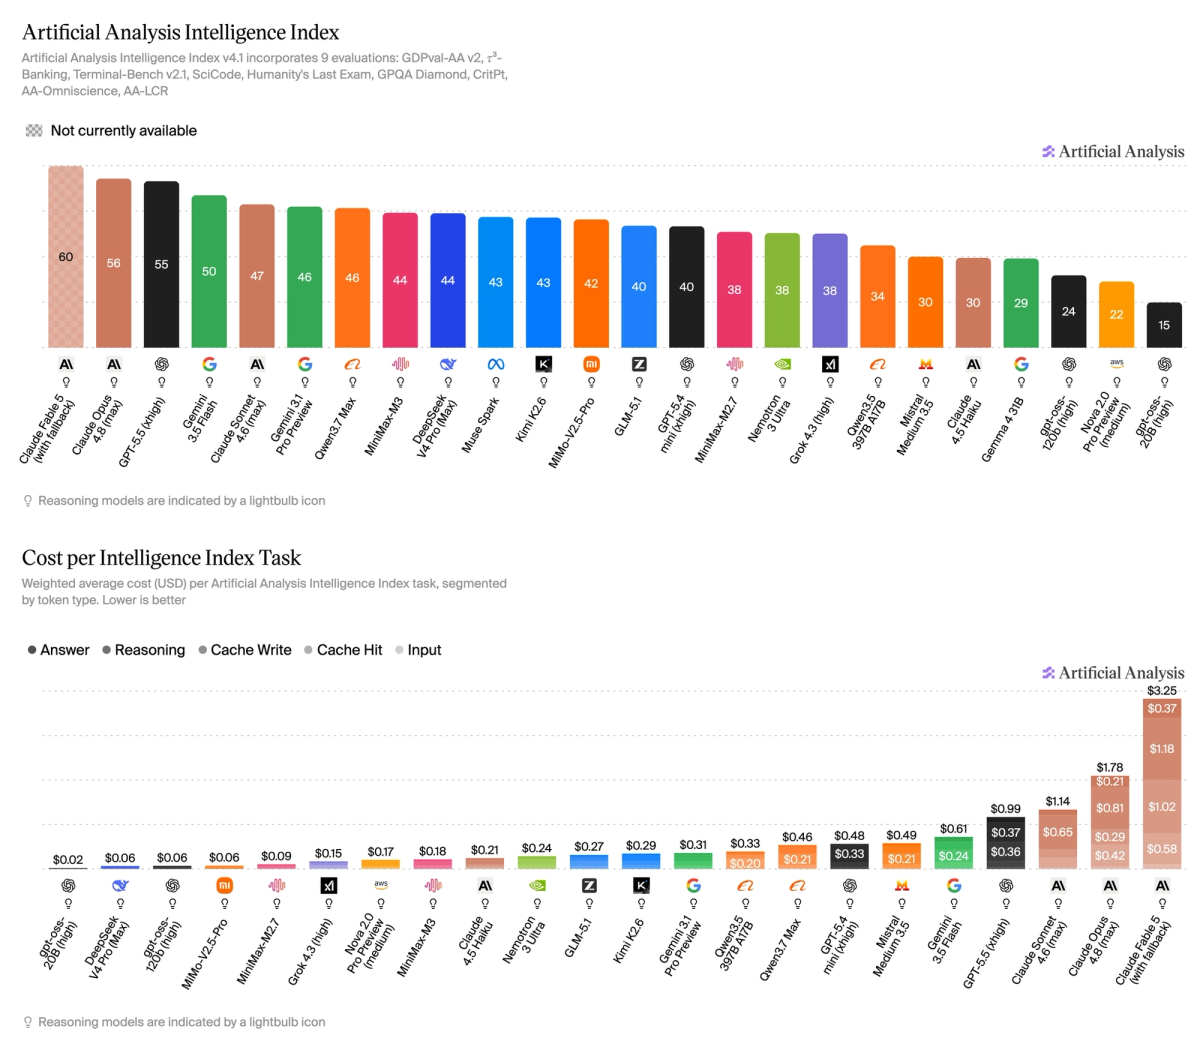
Индекс интеллекта искусственного анализа — это наша метрика синтеза для оценки интеллекта модели и отслеживания прогресса ИИ. Версия 4.1 знаменует собой более широкий сдвиг в сторону агентных рабочих нагрузок с тремя основными изменениями
Обновлены и переоценены оценки агентных задач
- Мы обновили три оценки, удалили одну и изменили вес индекса интеллекта:
- Терминал-Bench Hard обновлен до Terminal-Bench 2.1, а τ²-Bench Telecom — до τ³-Bench Banking. Оба переходят к новым, более надежным наборам задач с более сложными и реалистичными агентными сценариями, которые лучше разделяют передовые модели.
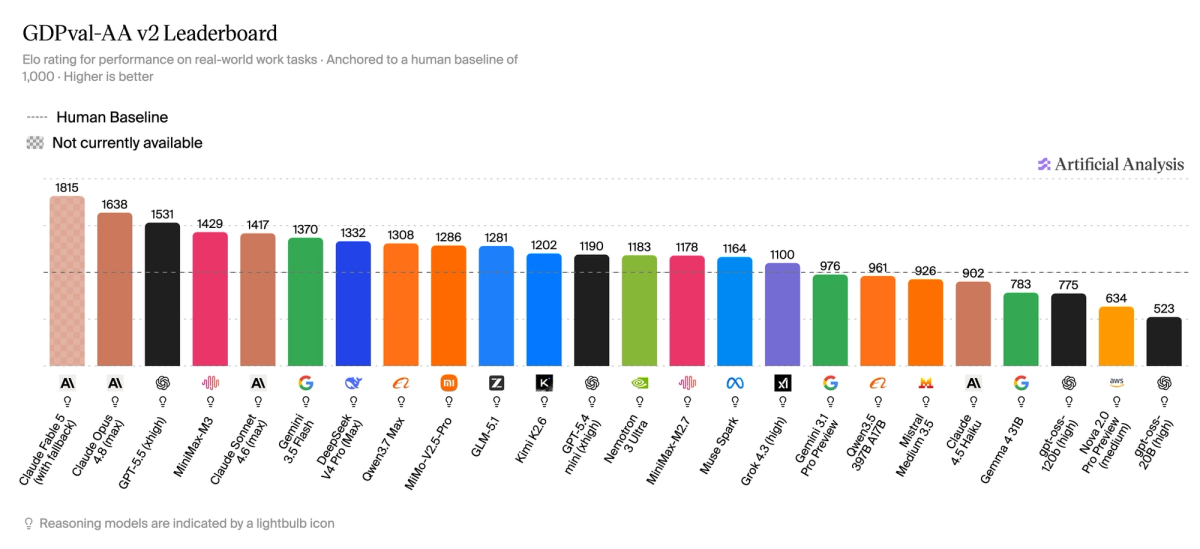
- GDPval-AA обновлен до GDPval-AA v2. Обновление изменяет базовые показатели Эло до уровня человека на уровне 1000, вводит вращающуюся группу судей пограничной модели и увеличивает предел хода со 100 до 250 для траекторий агентов с более длинным горизонтом.
- Удален IFBench из-за насыщенности. Тест больше не различает передовые модели в достаточной степени, поэтому мы удалили его из индекса интеллекта. Мы продолжим его использовать и публиковать результаты по новым выпускам моделей.
- Стоимость за задачу, время за задачу и жетоны за задачу: Три новых показателя для каждой задачи, сообщаемые для каждой модели и основанные на индексе интеллекта. Мы берем общую стоимость, общее время и общее количество выходных токенов для модели для запуска индекса интеллекта и делим их на количество задач в ее оценках, получая средние затраты, время и выходные токены для выполнения одной задачи индекса интеллекта.
- Отчеты о кэшированных входных токенах: Теперь мы сообщаем о кэшированных входных токенах и их влиянии на стоимость, включая стоимость запуска индекса интеллекта, чтобы лучше отражать реальную стоимость запуска каждой модели.
Ключевые результаты
- Ведущие модели: Claude Fable 5 (с резервной версией Opus 4.8, 60) лидирует в Индексе искусственного интеллекта анализа v4.1 на четыре пункта, но в настоящее время недоступна, в результате чего Claude Opus 4.8 (макс., 56) является самой интеллектуальной доступной моделью, опережая GPT-5.5 (xhigh, 55).
- Лидирующие модели с открытым грузом: среди моделей с открытым грузом лидируют DeepSeek V4 Pro (макс., 44) и MiniMax M3 (44), за ними следуют Kimi K2.6 (43) и MiMo-V2.5-Pro (42).
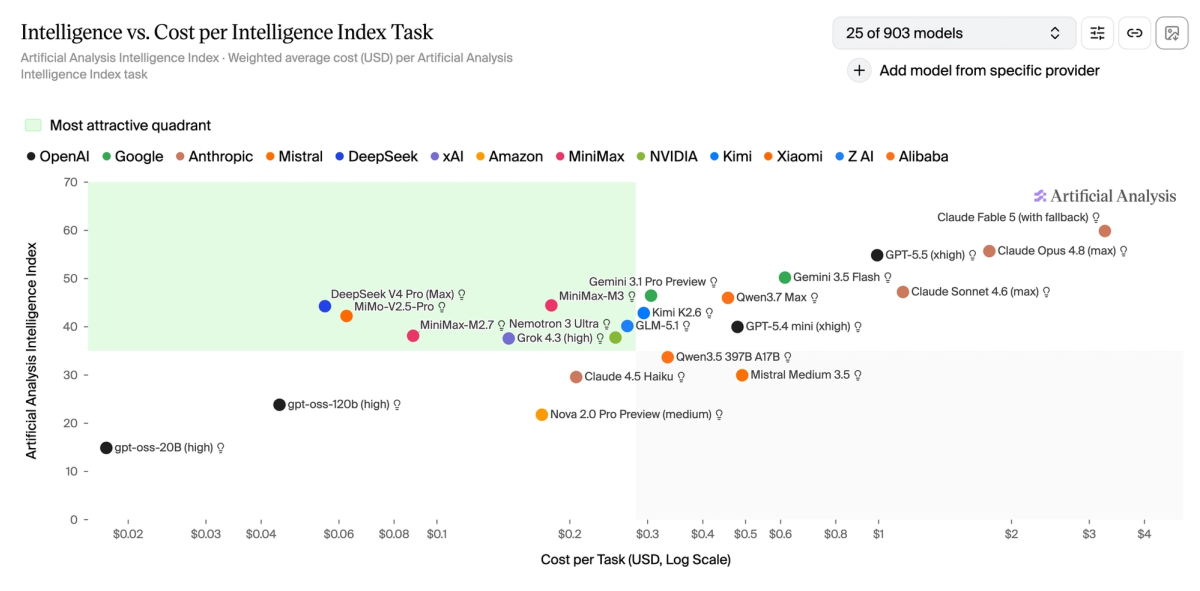
- Стоимость за задачу: Claude Opus 4.8 (макс.) — самая дорогая доступная модель по цене 1,78 доллара за задачу, а Claude Fable 5 — самая высокая в целом по цене 3,25 доллара. GPT-5.5 (xhigh) оценивается в пределах 0,99 доллара США за задание по индексу интеллекта Opus 4,8. DeepSeek V4 Pro (макс.) выделяется на диаграмме «Интеллект против стоимости задачи» по цене 0,04 доллара США за задачу, тогда как другие ведущие проприетарные модели стоят в 20–45 раз дороже.
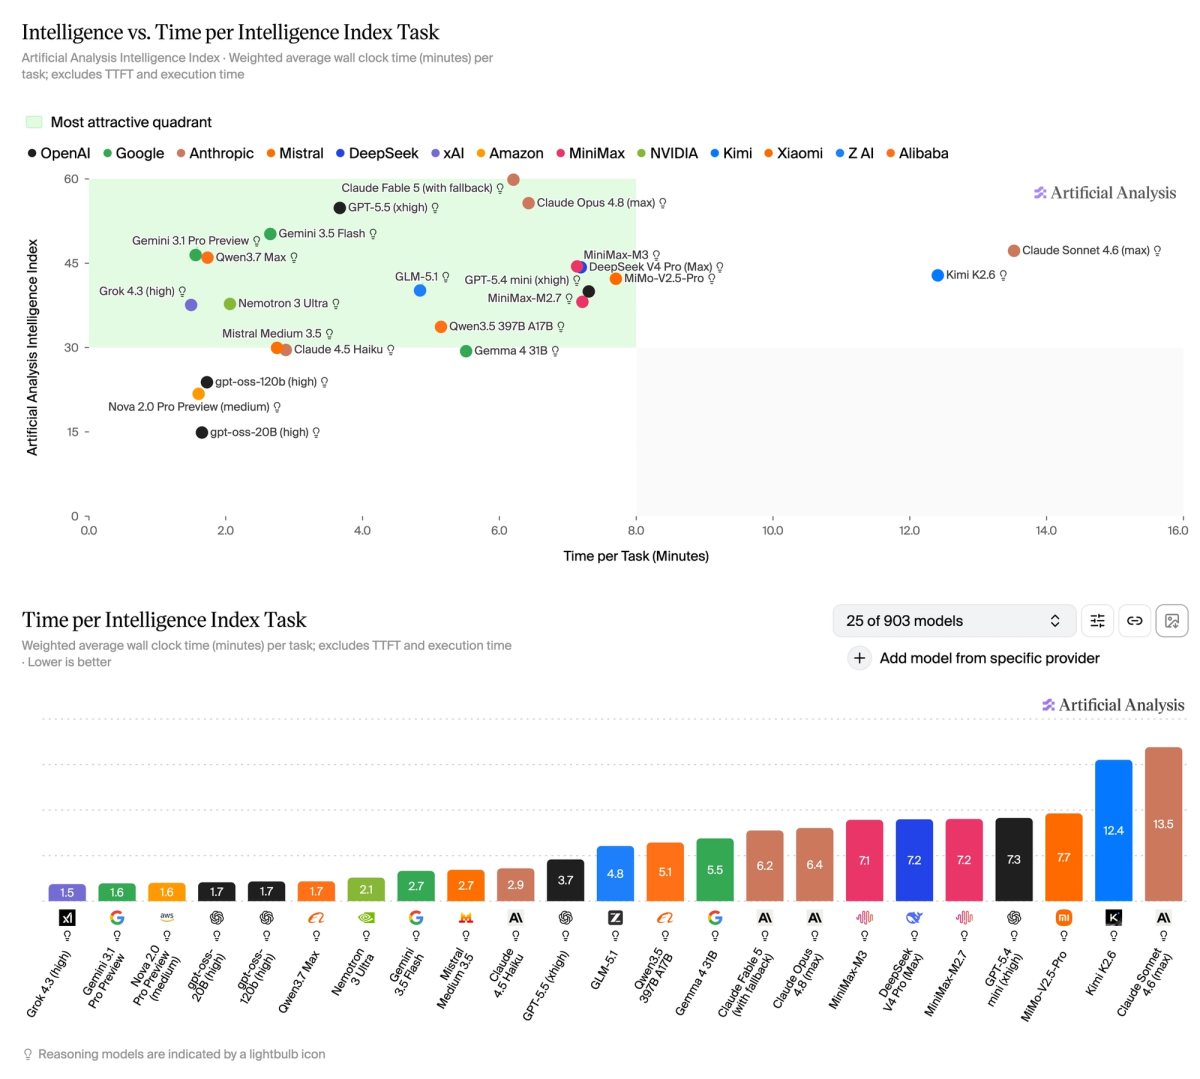
- Время на задачу: время на задачу (время декодирования вывода) варьируется от 1,5 минут для Grok 4.3 (высокая) до 13,5 для Claude Sonnet 4.6 (максимум), разброс примерно в 9 раз. Claude Opus 4.8 (макс.) выполняет задачу за 6,4 минуты, GPT-5.5 (xhigh) за 3,7, а Gemini 3.1 Pro Preview выделяется на диаграмме «Интеллект против времени на задачу» за 1,6 минуты и набирает 46 баллов.
DeepSeek V4 Pro (макс.) выделяется на диаграмме «Интеллект против стоимости задачи»: 0,04 доллара США за задачу при индексе интеллекта 44, выполнение одной задачи с индексом интеллекта более чем в 20 раз дешевле, чем GPT-5.5 (xhigh, 0,99 доллара США) и более чем в 40 раз дешевле, чем Claude Opus 4.8 (максимум, 1,78 доллара США).
Время выполнения задачи индекса интеллекта для ведущих моделей варьируется от 1,5 минут для Grok 4,3 (высокий) до 13,5 минут для Claude Sonnet 4,6 (максимум). Claude Sonnet 4.6 требует больше времени на выполнение задачи, чем Claude Opus 4.8 (максимум), поскольку для запуска индекса интеллекта он использует больше токенов вывода. Gemini 3.1 Pro Preview выделяется на диаграмме задач «Интеллект против времени на индекс интеллекта» с показателем 1,6 минуты и индексом интеллекта 46.
GDPval-AA v2 — это оценка с самым высоким весом в индексе интеллекта v4.1. Обновление изменяет базовый уровень ELO до уровня 1000, вводит вращающуюся группу судей пограничной модели и увеличивает предел поворотов со 100 до 250 для траекторий агентов с более длинным горизонтом. Claude Fable 5 (с резервным вариантом) лидирует на отметке 1818, за ним следует Claude Opus 4.8 (1638). GPT-5.5 (xhigh) набрал 1531 балл. Claude Fable 5 в настоящее время недоступен для использования.
Веса полного индекса интеллекта v4.1
- ВВПвал-АА v2: 20%
- Терминал-Скамейка 2.1: 16%
- τ³-Банковское банковское дело: 14%
- Последний экзамен человечества: 12%
- AA-Всезнание Точность: 8%
- Научный код: 8%
- GPQA: 6%
- АА-ЛКР: 6%
- КритПт: 6%
- АА-Всеведение, отсутствие галлюцинаций: 4%