GLM-5.2 стала новой ведущей открытой моделью в Индексе интеллекта
Флагман Zhipu AI с открытыми весами возглавил категорию open weights, продемонстрировав зрелые рассуждения.
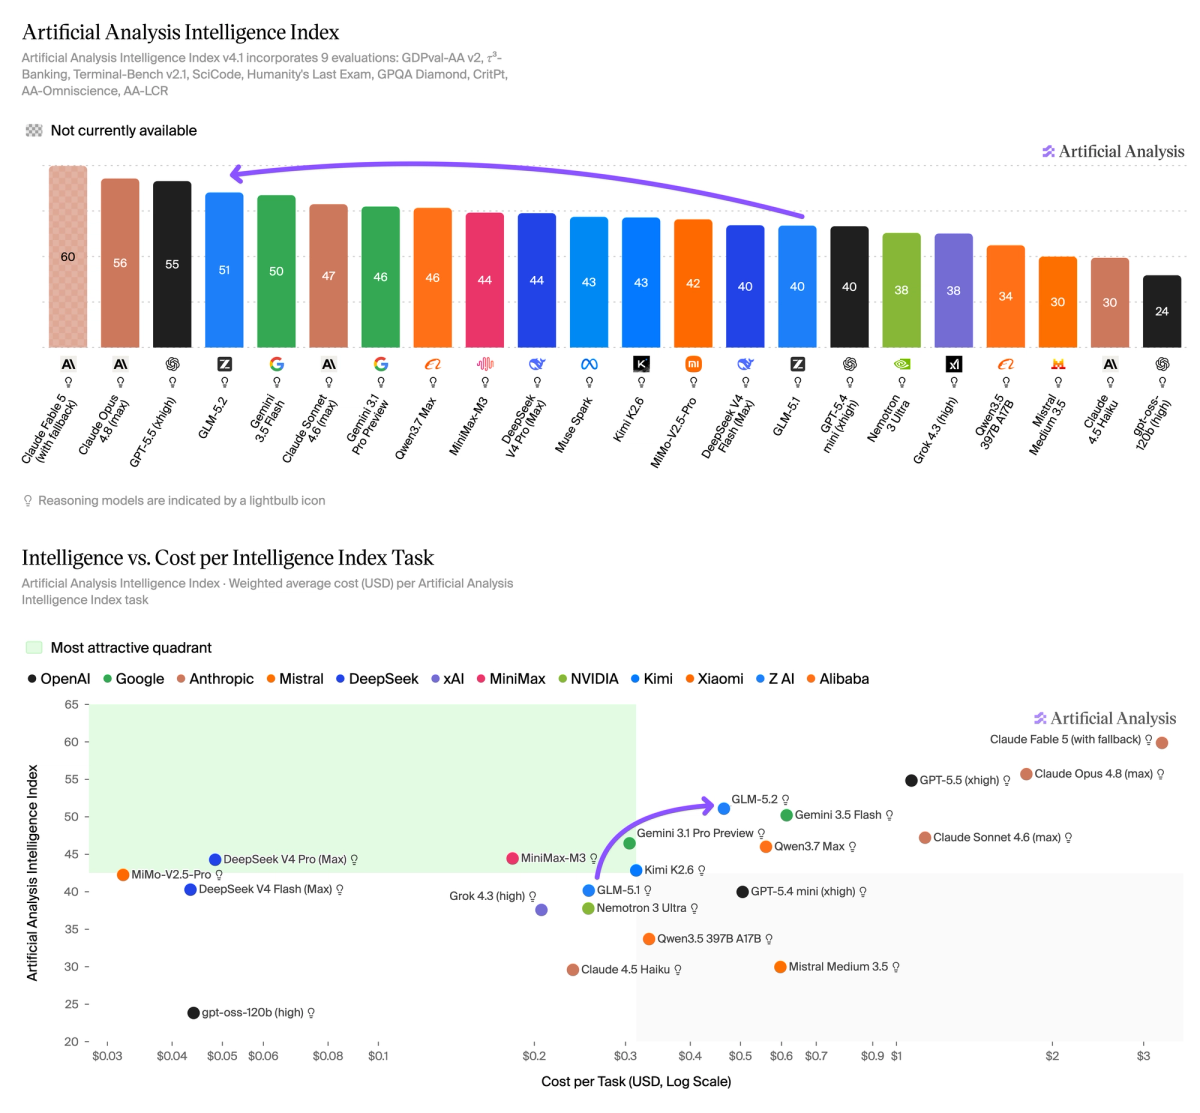
GLM-5.2 от Zai — это новая ведущая модель с открытыми весами в индексе интеллекта искусственного анализа, набравшая 51 балл, и она находится на границе Парето между интеллектом и стоимостью за задачу.
GLM-5.2 имеет тот же размер, что и GLM-5.1 (всего 744B / 40B активных параметров), но набирает на 11 баллов больше в индексе интеллекта v4.1, опережая MiniMax-M3 (44) и DeepSeek V4 Pro (макс. 44). В собственном API цена соответствует GLM-5.1: 1,4/4,4/0,26 доллара США за 1 млн токенов ввода/вывода/кэша.
Ключевые результаты
➤ GLM-5.2 — ведущая модель открытых весов в индексе интеллекта v4.1. С 51 годом он опережает MiniMax-M3 (44), DeepSeek V4 Pro (макс, 44) и Kimi K2.6 (43).
➤ Улучшения по большинству оценок, особенно по научным рассуждениям: GLM-5.2 превосходит GLM-5.1 по большинству оценок, во главе с научными рассуждениями по CritPt (+16 баллов до 21%) и HLE (+12 баллов до 40%), а также AA-LCR (+9 баллов до 71%), банкинга tau3 (+15 баллов до 27%) и SciCode (+7 баллов до 50%). TerminalBench v2.1 также улучшается (+16 баллов до 78%), а GPQA Diamond набирает 3 балла до 89%.
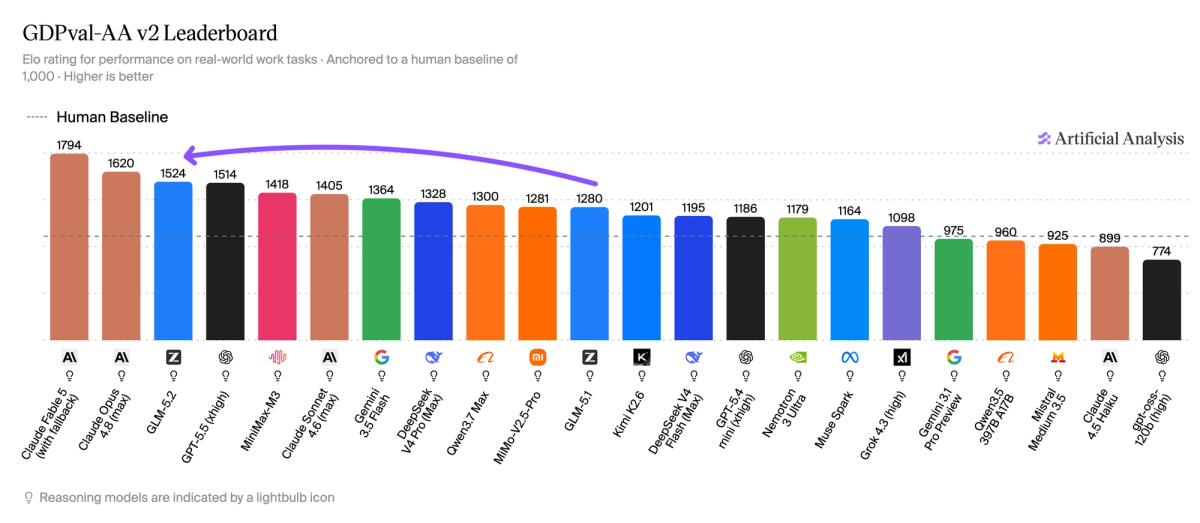
➤ Ведущая модель открытых весов на GDPval-AA v2 и конкурентоспособная с проприетарными моделями: GLM-5.2 набирает 1524 балла на GDPval-AA v2, опережая MiniMax-M3 (1418) и DeepSeek V4 Pro (макс. 1328). Этот впечатляющий результат ставит GLM-5.2 в один ряд с патентованными моделями, включая GPT-5.5 (рассуждение xhigh). GDPval-AA v2 основывается на исходном GDPval-AA, устанавливая базовый уровень Elo для производительности человека на уровне 1000, вводя вращающуюся группу судей пограничной модели и увеличивая предел хода со 100 до 250 для траекторий агентов с более длинным горизонтом.
➤ GLM-5.2 использует больше токенов вывода на задачу, чем другие ведущие модели с открытыми весами: модель использует 43 тыс. токенов вывода на задачу индекса интеллекта по сравнению с GLM-5.1 (26 тыс.) и выше MiniMax-M3 (24 тыс.), Kimi K2.6 (35 тыс.) и DeepSeek V4 Pro (макс., 37 тыс.)
➤ На границе Парето «Интеллект против стоимости задачи»: GLM-5.2 находится на границе Парето диаграммы «Интеллект против стоимости задачи» с самой низкой стоимостью задачи среди моделей на этом уровне интеллекта. GLM-5.2 стоит ~0,46 доллара США за задачу по сравнению с GLM-5.1 (0,25 доллара США), Kimi K2.6 (0,31 доллара США), MiniMax-M3 (0,18 доллара США) и DeepSeek V4 Pro (максимум 0,05 доллара США).
Дополнительные сведения о модели
➤ Лицензия: MIT
➤ Размер: всего 744 байт параметров, 40 байт активных параметров, что эквивалентно GLM-5.1.
➤ Контекстное окно: 1 млн токенов по сравнению с 200 тыс. на GLM-5.1.
➤ Цена: 1,4 доллара США/0,26 доллара США/4,4 доллара США за 1 миллион токенов ввода/кэша/выхода.
➤ Доступность: наряду с собственным API Z ai, GLM-5.2 доступен у сторонних поставщиков, включая DeepInfra, Novita, Nebius, Parasail, Siliconflow, GMI Cloud, Baseten и Fireworks.
GLM-5.2 опережает все модели открытых весов на GDPval-AA v2, нашем основном показателе реальной производительности агентов. С показателем 1524 он опережает MiniMax-M3 (1418) и DeepSeek V4 Pro (макс., 1328) и фактически находится на одном уровне с GPT-5.5 (xhigh, 1514). Мы визуально проверили результаты GLM-5.2 по ряду задач GDPval-AA. Ниже мы прикрепили подборку.
GLM-5.2 получил 4 балла по Индексу всеведения АА по сравнению с GLM-5.1 (2). Выигрыш достигается как за счет более высокой точности (25,1% против 24,2%), так и за счет более низкой частоты галлюцинаций (28,1% против 29,4%), при этом частота попыток остается неизменной на уровне 47%.
GLM-5.2 использует 43 тыс. токенов вывода для каждой задачи индекса интеллекта, из которых 37 тыс. — рассуждения. Это выше, чем у GLM-5.1 (26 тыс.) и выше, чем у аналогов с открытым весом MiniMax-M3 (24 тыс.) и Kimi K2.6 (35 тыс.), что ставит его среди менее эффективных токенов моделей с открытым весом на своем уровне интеллекта. GLM-5.2 находится в самом привлекательном квадранте диаграммы «Интеллект против токенов вывода».
Разбивка отдельных оценок в индексе искусственного анализа интеллекта v4.1.