Анонс Индекса интеллекта AI Стата v4.2
Обновление весов бенчмарков с акцентом на проверку реального кодинга и работу с внешними инструментами.
Мы ускоряем работу над элементами нашего предстоящего выпуска v5 с помощью промежуточных обновлений, чтобы идти в ногу с передовыми технологиями. Index v4.2 имеет более сложные и реалистичные задачи, а также больше наборов частных тестов для предотвращения игр.
Журнал изменений Intelligence Index v4.2
+ AA-Briefcase, наша агентская оценка работы с знаниями с помощью частного набора тестов.
+ GDP.pdf Surge, подробный контекстный документ на 4592 страницах PDF
- GPQA Diamond, исключительная оценка научных рассуждений, которая теперь насыщена
… плюс больший вес отложенных наборов тестов для предотвращения игр и оценка обновлений инфраструктуры для повышения надежности
Это обновление приближает Индекс к реальным сценариям использования с более сложными, сложными и реалистичными задачами и частными наборами тестов для предотвращения игр. Мы планировали и создавали элементы Index v5 в течение нескольких месяцев — прошло 8 месяцев с тех пор, как мы запустили Index v4 в январе.
Мы намеренно отложили обновления, чтобы поддерживать стабильность индекса во время недавних запусков крупных моделей. Однако, поскольку за последние недели граница сдвинулась так быстро, мы считаем важным немедленно выпустить промежуточное обновление, чтобы наш Индекс оставался таким же актуальным и полезным для пользователей, как и прежде.
Помимо этого промежуточного обновления, наша команда усердно работает над пятой версией Индекса. В ближайшем будущем мы планируем новые дополнительные выпуски. Следите за обновлениями!
Подробные изменения Intelligence Index v4.2
➤ Добавление AA-Briefcase: наша собственная оценка с использованием частного набора тестов AA-Briefcase проверяет модели на реалистичных задачах работы с агентскими знаниями в сложных проектах, созданных отраслевыми экспертами. Модели оцениваются в рамках многонедельных исследовательских проектов, каждый из которых включает множество связанных задач и тысячи входных исходных файлов. AA-Briefcase сочетает в себе рубрики и парную оценку для оценки поддающегося проверке успешности выполнения задач, аналитического качества и качества презентации, что дает целостное представление об общих способностях агента в информационной работе.
➤ Добавление файла GDP.pdf. Созданный компанией Surge AI файл GDP.pdf оценивает одноразовое профессиональное обоснование документов по 100 PDF-файлам и десяти доменам. Модели должны синтезировать доказательства, распределенные на 4592 страницах, включая текст, таблицы, диаграммы, сноски и исключения. Ответы оцениваются по 1275 атомарным критериям, разработанным экспертами; в заголовке «Показатель всех пройденных» задача засчитывается только тогда, когда все критерии удовлетворены.
➤ Взвешивание для измерения реального использования и предотвращения игр: 40 % взвешивания нашего индекса теперь составляют частные, закрытые тестовые наборы — вдвое больше, чем в версии 4.1. Предоставленные данные включают AA-Портфель, AA-Всеведение и решения для CritPt. Это снижает возможности лабораторий по оценке игр. Процент удержания еще больше увеличится в Index v5.
➤ Улучшение нашей инфраструктуры выставления оценок. В AA-LCR v1.1 мы добавили подсказку системы выставления оценок и исправили ошибки и неясности в ключах ответов, повысив точность выставления оценок. Для GDPval-AA v2 и AA-Briefcase мы улучшили выборку и повторно привязали шкалу Эло, что делает рейтинги более стабильными по мере добавления новых моделей. Для SciCode мы улучшили надежность тестовых программ, чтобы гарантировать, что медленный, но правильный код не будет считаться сбоем.
Ключевые результаты
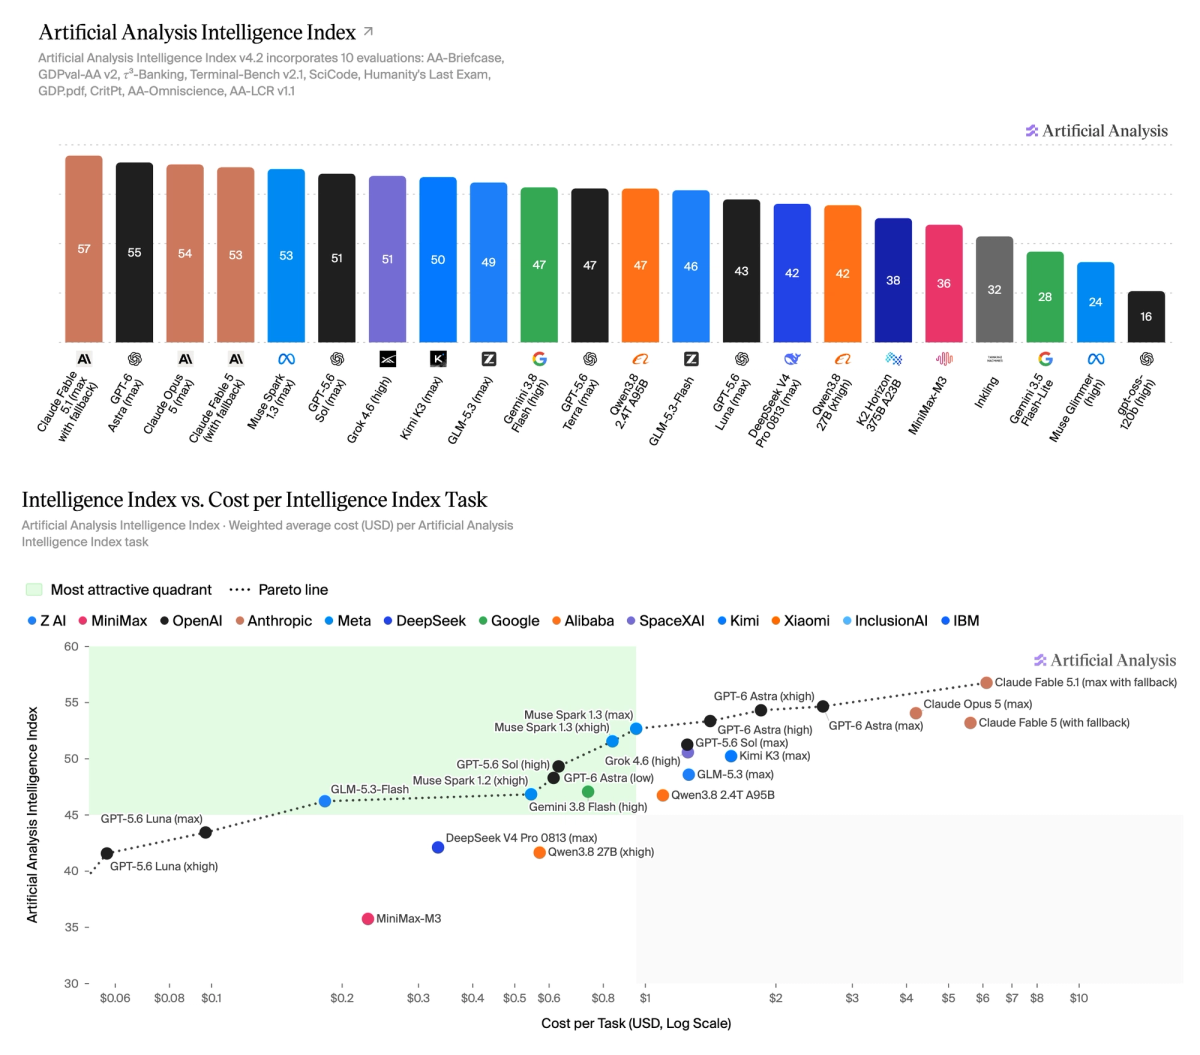
➤ Граница Парето стоимости за задачу, общая для четырех лабораторий: Anthropic, OpenAI, Meta и Z.AI, занимает обновленную границу стоимости за задачу.
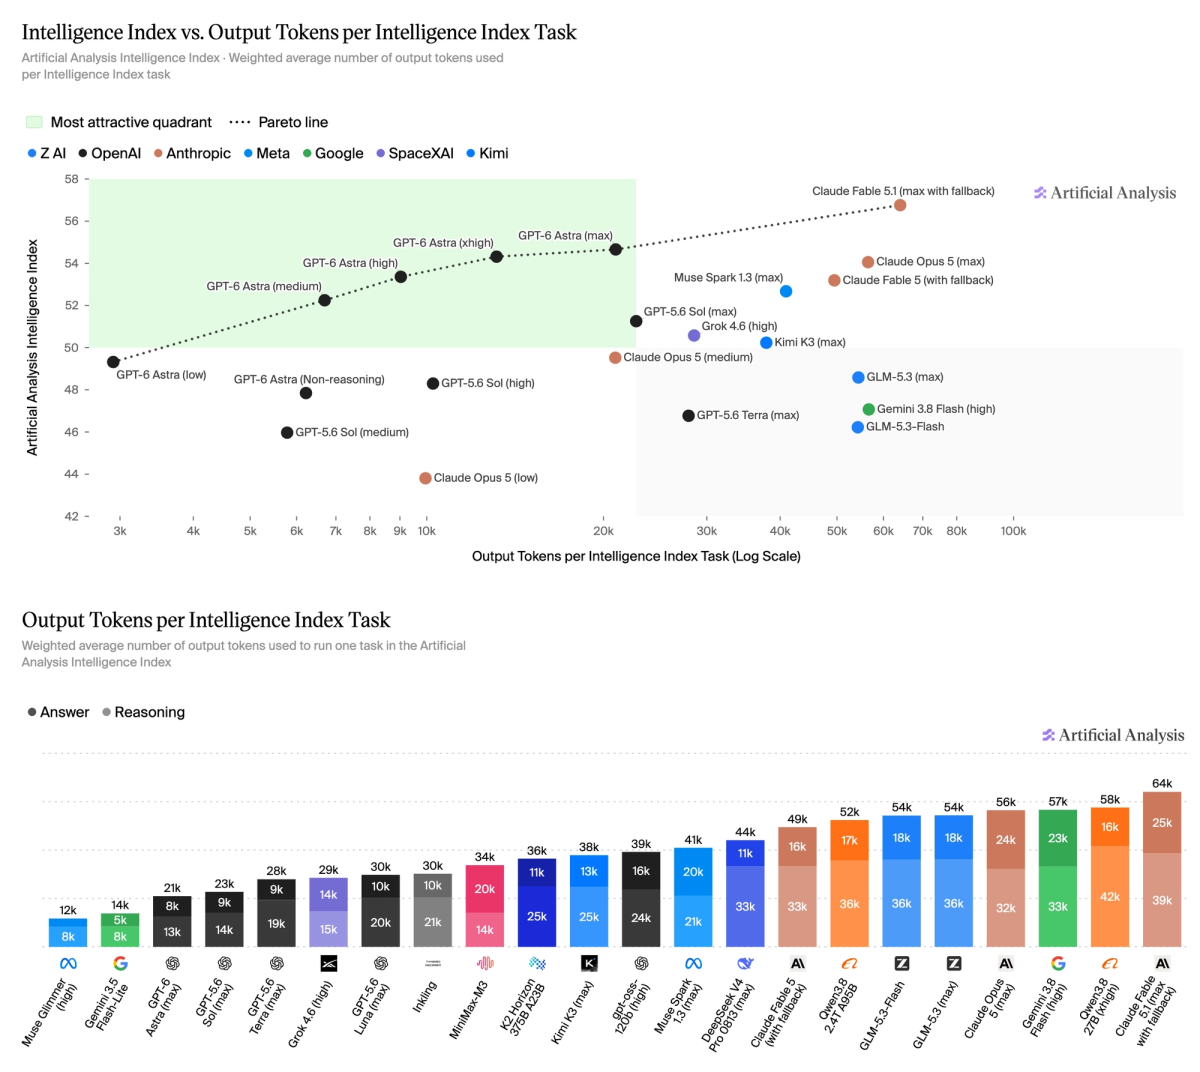
➤ GPT-6 Astra доминирует на границе выходных токенов: GPT-6 Astra более эффективен, чем почти любая другая модель, находящаяся на границе интеллекта, с Claude Fable 5.1, Grok 4.5 и Gemini 3.5 Flash-Lite на обоих концах кривой (исключая модели ниже 25 в индексе)
GPT-6 Astra более эффективен, чем почти любая другая модель, находящаяся на границе интеллекта: Claude Fable 5.1, Grok 4.5 и Gemini 3.5 Flash-Lite на обоих концах кривой (исключая модели ниже 25 в индексе)
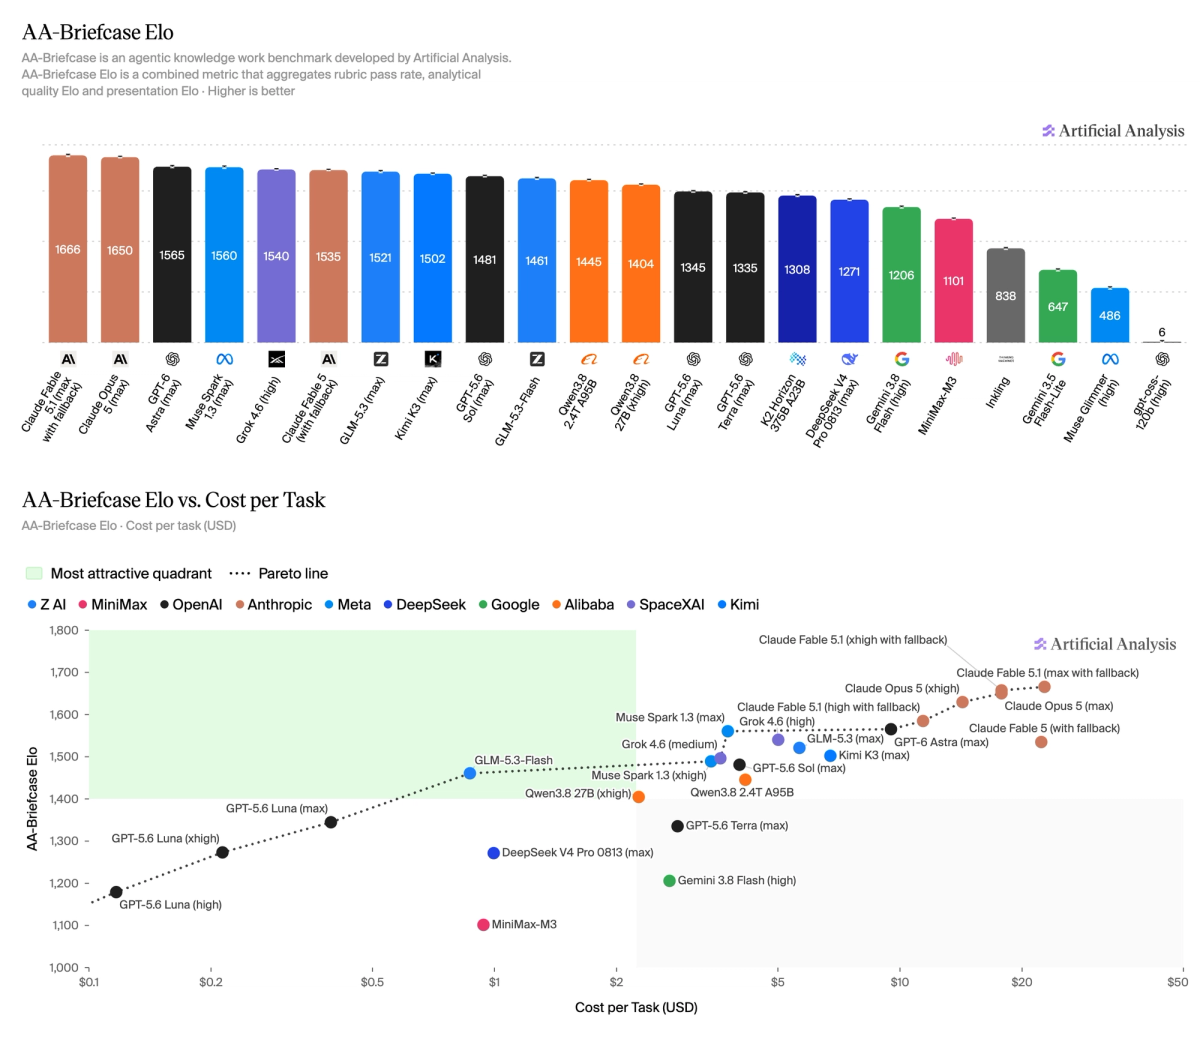
Claude Fable 5.1 и Opus 5 от Anthropic возглавляют рейтинг AA-Briefcase, за ними следуют GPT-6 Astra и Muse Spark 1.3. GPT-6 Astra показывает существенный прирост по сравнению с GPT-5.6 Sol на ~85 баллов Эло.
AA-Briefcase — это наша передовая внутренняя оценка с частным набором тестов. Оценочные тесты моделируют реалистичные задачи работы с агентскими знаниями в сложных проектах, созданных отраслевыми экспертами. Модели оцениваются в рамках многонедельных исследовательских проектов, каждый из которых включает множество связанных задач и тысячи входных исходных файлов. AA-Briefcase сочетает в себе рубрики и парную оценку для оценки поддающегося проверке успешности выполнения задач, аналитического качества и качества презентации, что дает целостное представление об общих способностях агента в информационной работе.
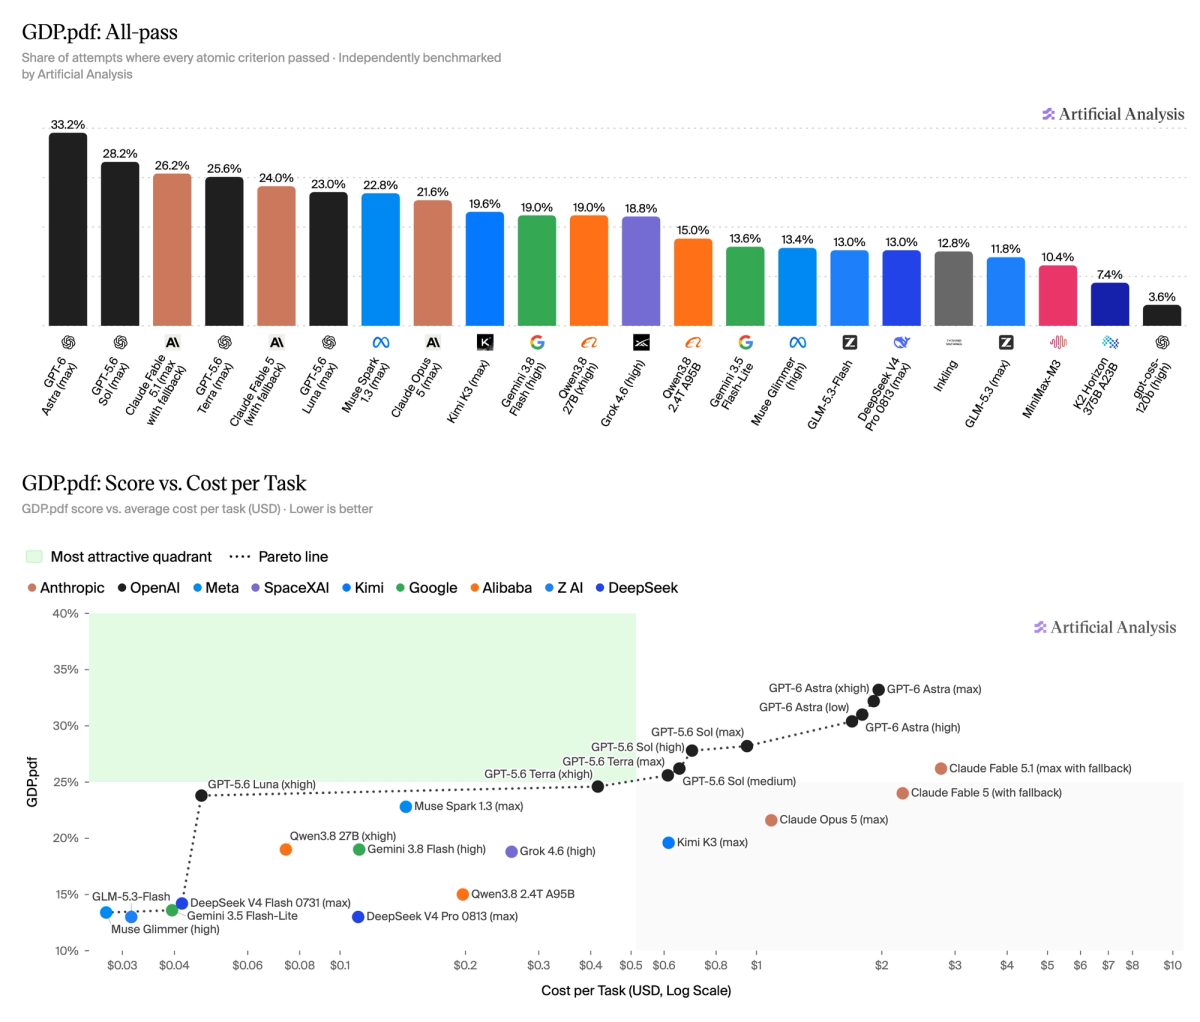
OpenAI лидирует в GDP.pdf с GPT-6 Astra с 33,2% и GPT-5.6 Sol с 28,2%, за ним следует Claude Fable 5.1 с 26,2%.
GDP.pdf, созданный Surge AI, оценивает профессиональное обоснование документов за один ход в 100 PDF-файлах и десяти доменах. Модели должны синтезировать доказательства, распределенные на 4592 страницах, включая текст, таблицы, диаграммы, сноски и исключения. Ответы оцениваются по 1275 атомарным критериям, разработанным экспертами; в заголовке «Показатель всех пройденных» задача засчитывается только тогда, когда все критерии удовлетворены.
Полная разбивка по моделям ниже