Запуск версии v4.1.1 Индекса интеллекта AI Стата
Уточнённая калибровка весов бенчмарков рассуждений и устранение артефактов в тестах кодинга.
Мы обновили индекс искусственного анализа интеллекта до версии 4.1.1 — этот выпуск обновления обновляет наши модели грейдеров и добавляет последнюю версию 𝜏³-Banking для искусственного анализа.
Чтобы индекс искусственного анализа интеллекта оставался наиболее полезным показателем синтеза для разработчиков, мы регулярно обновляем включенные оценки и нашу независимую методологию. Сегодняшнее обновление является незначительным, чтобы сохранить существующий оценочный набор как можно более надежным.
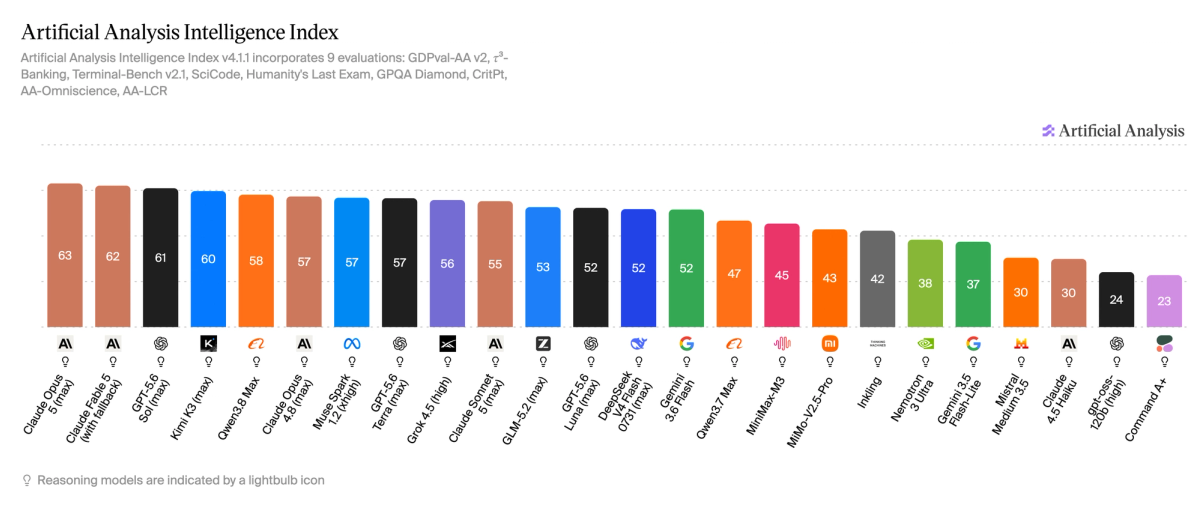
Общие рейтинги моделей остаются в целом стабильными, с небольшим увеличением баллов из-за повышения надежности оценок в обновленных оценках. Claude Opus 5 остается на позиции №1 с индексом 63.
Ключевые изменения
➤ 𝜏³ — Банковское дело теперь использует версию 1.0.1 от Sierra, обновленную до последних версий вышестоящих задач и улучшенный конвейер грейдера, который устраняет ошибки правильности в траекториях, которые восстанавливаются после неудачных путей.
➤ HLE, AA-LCR и AA-Omniscience теперь оцениваются GPT-5.6 Luna (средний), заменяя GPT-4o, Qwen3 235B A22B 2507 и Gemini 3 Flash Preview соответственно. Эти проверки теперь объединены в более функциональную современную модель, выбранную для точного соответствия человеческим суждениям при проверке нашей оценочной системы.
Опубликованные оценки теперь используют версию 4.1.1, поэтому все результаты моделей в искусственном анализе теперь отражают эти изменения и используют нашу новейшую последовательную независимую методологию.