Claude Opus 4.8: детальный анализ новой модели #1 в мире
Замеры производительности флагмана Claude Opus 4.8: рекордные баллы в кодинге, математике и научном анализе.

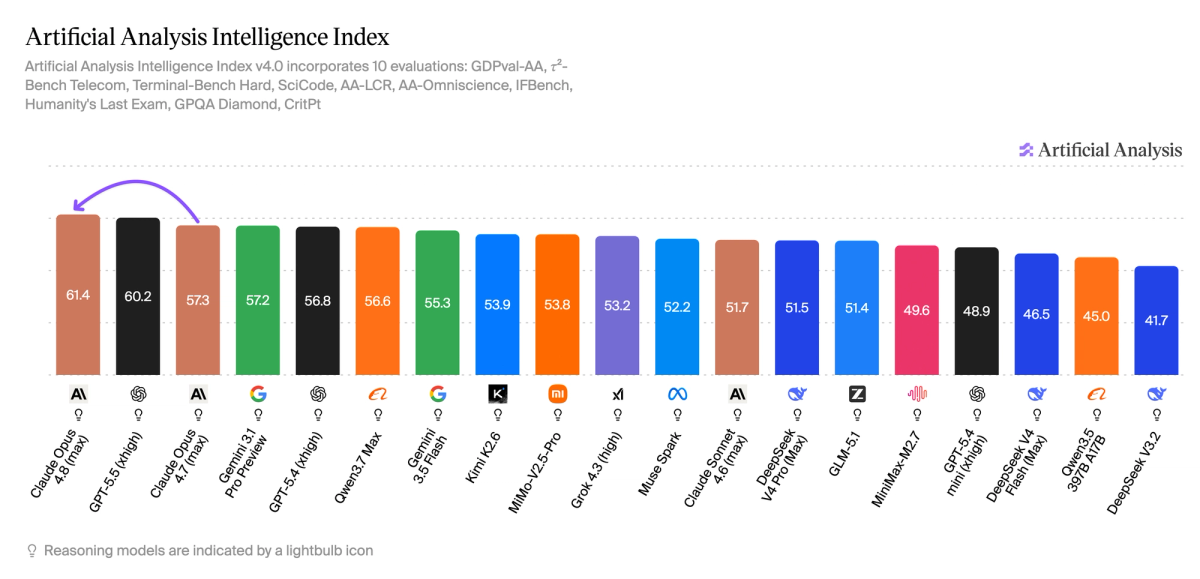
Чтобы достичь лидирующей позиции в Индексе интеллекта, Anthropic добилась значительных улучшений как в реальной агентской работе, так и в передовых академических задачах рассуждения.
- Claude Opus 4.8 — новый лидер в индексе искусственного анализа интеллекта. Opus 4.8 набрал 61,4, что на +4,1 балла больше, чем у Opus 4.7, и на +1,2 балла опережает GPT-5.5 (xhigh), предыдущего лидера индекса.
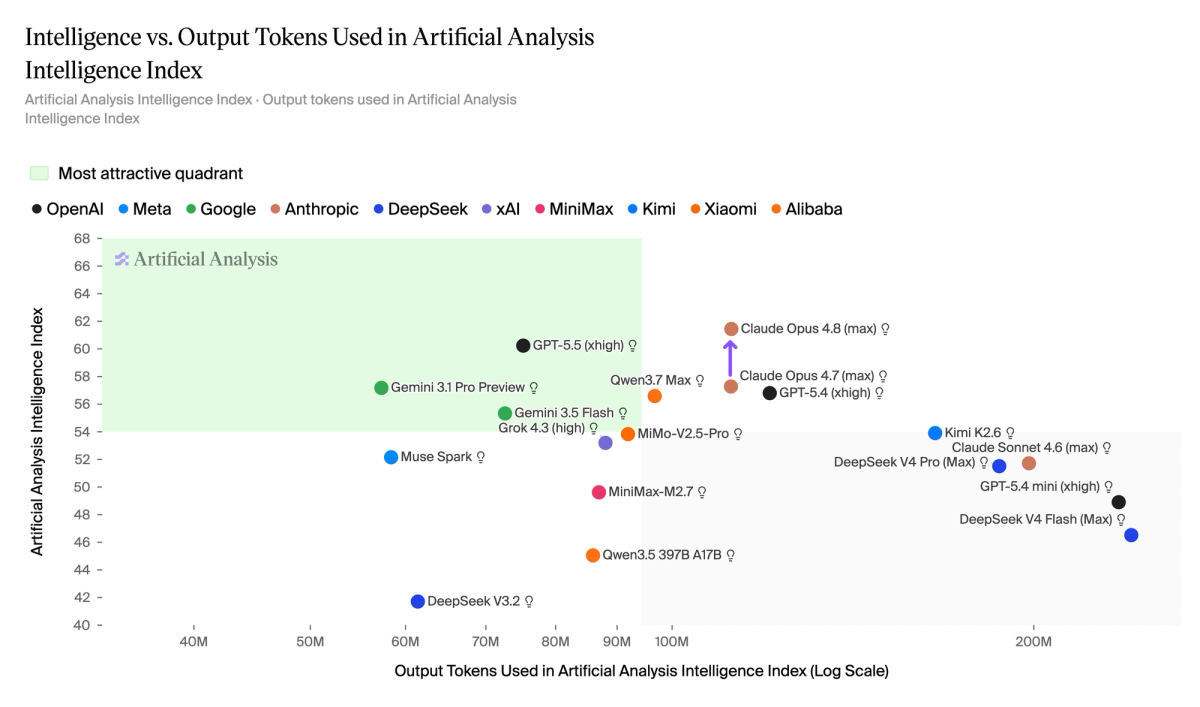
- Новый выпуск немного более эффективен, чем его предшественник, при выполнении агентских задач, но эффективность токена зависит от типа задачи. Мы видели, что Opus 4.8 использует меньше оборотов и токенов вывода на GDPval-AA, но примерно такое же количество токенов вывода для общего индекса интеллекта, чтобы достичь значительно более высокой производительности.
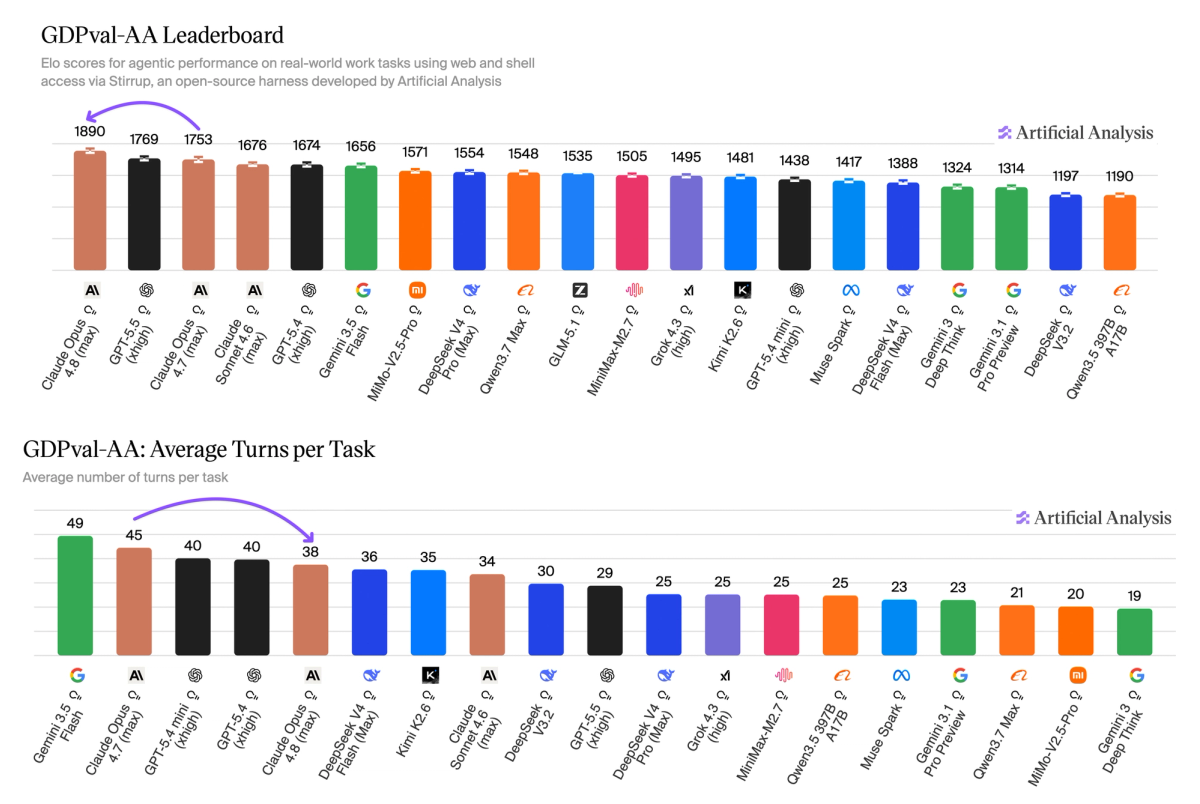
- Anthropic возвращает лидерство по GDPval-AA, нашей основной оценке эффективности агентов при выполнении задач умственной работы. Opus 4.8 набрал 1890 баллов Эло, что отражает предполагаемый процент побед около 67% против GPT-5.5.
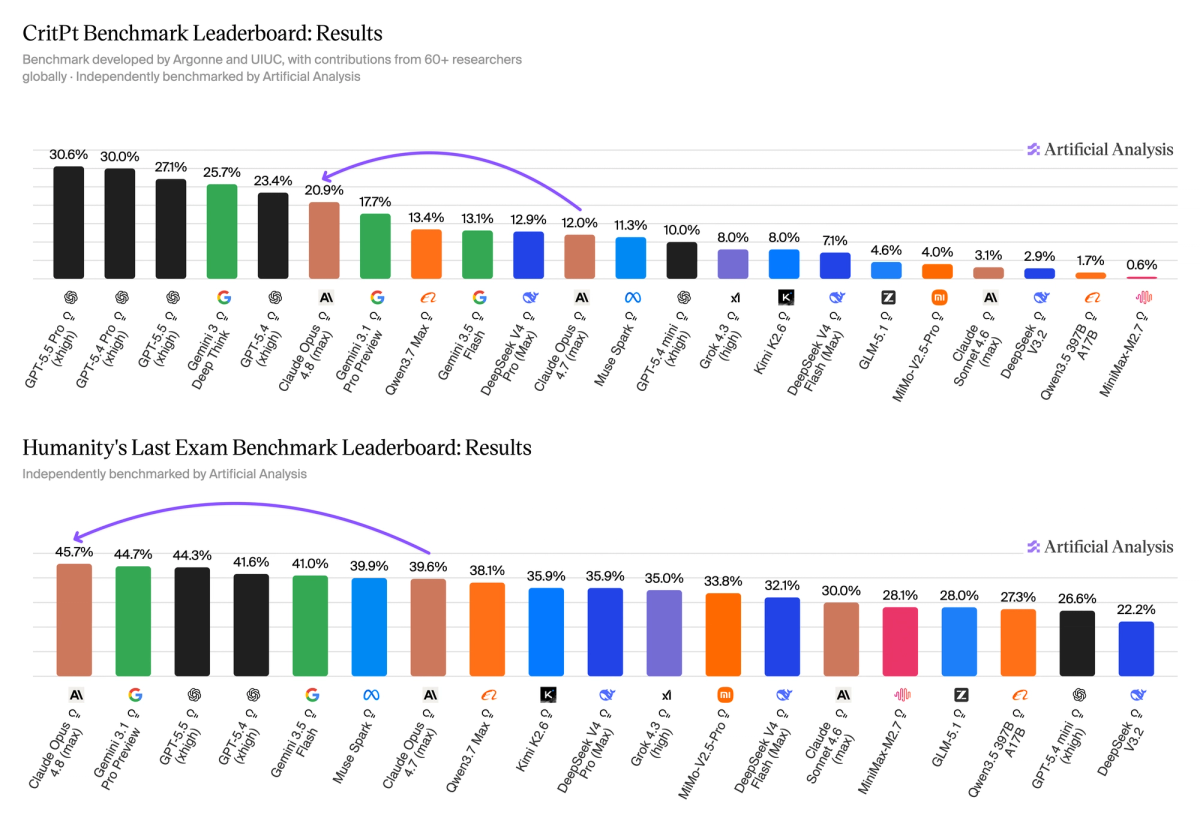
- Клод сейчас входит в число лучших моделей научных рассуждений. Предыдущие выпуски отставали от аналогов в решении сложных академических задач, но с Opus 4.8 Клод немного опережает OpenAI и Google в качестве лидера на последнем экзамене человечества. Он также имеет более высокие оценки, чем Gemini 3.1 Pro, в CritPt, передовом физическом тесте, но остается позади GPT-5.4 и GPT-5.5.
- Клод Опус 4.8 достигает второго места в рейтинге АА-Всеведение, немного опережая Опус 4.7. Opus 4.8 набрал 27,4 балла по индексу всеведения AA, уступая только Gemini 3.1 Pro (32,9). Точность немного выросла до 46,6%, а уровень галлюцинаций остался примерно на уровне 35,9%. Anthropic продолжает демонстрировать значительно более низкий уровень галлюцинаций, чем аналогичные модели от Google и OpenAI.
- По сравнению с Opus 4.7, Opus 4.8 также дает существенный прирост в тестах Terminal-Bench Hard (+6,8 балла), τ²-Bench Telecom (+5,9 балла) и IFBench (+3,6 балла), имея относительно ровные оценки по AA-LCR, GPQA и SciCode.
- Контекстное окно на 1 миллион токенов (эквивалент Opus 4.7)
- Цена 5/25 долларов США за миллион токенов ввода/вывода; Цена кэша остается на уровне 25% надбавки за запись в кэш (6,25 доллара США за миллион токенов) с 5-минутным временем жизни и 90% скидкой за попадания в кеш (0,5 доллара США за миллион токенов).
- Effort остается рекомендуемым способом настройки производительности и задержки модели с теми же параметрами, что и в Opus 4.7. Мы измерили модель при максимальной настройке усилия, чтобы проверить максимальную производительность.
По общему индексу интеллекта Claude Opus 4.8 использовал примерно такое же количество выходных токенов, что и Opus 4.7, но добился существенного улучшения производительности по ряду тестов в разных доменах, что позволило добиться увеличения индекса интеллекта искусственного анализа на 4 пункта.
Claude Opus 4.8 делает большие успехи в развитии научных и академических способностей к рассуждениям. Он опережает «Последний экзамен человечества» на 1 балл в жесткой конкуренции между Anthropic, Google DeepMind и OpenAI, а Claude Opus обогнал Gemini 3.1 Pro в CritPt, передовой физической оценке, разработанной Argonne и UIUC.
Opus 4.8 набрал 1890 баллов на GDPval-AA при запуске с настройкой «максимальное усилие», +137 баллов от Opus 4.7 и +121 балл впереди следующей лучшей модели, GPT-5.5 xhigh. По сравнению с набором задач GDPval, это означает, что процент побед над GPT-5.5 xhigh составляет ~67%. Такая производительность достигается за счет на 15 % меньшего числа оборотов на задачу и на 35 % меньше выходных токенов, чем Opus 4.7. Тем не менее, он по-прежнему использует примерно на 30% больше витков, чем модель OpenAI GPT-5.5, вторая в рейтинге.
Разбивка полных результатов для Claude Opus 4.8.