AA-WER Streaming: новый бенчмарк потокового распознавания речи
Тестирование речевых API на шумных звонках, перебиваниях и потоковом аудио с замером задержки каждого слова.

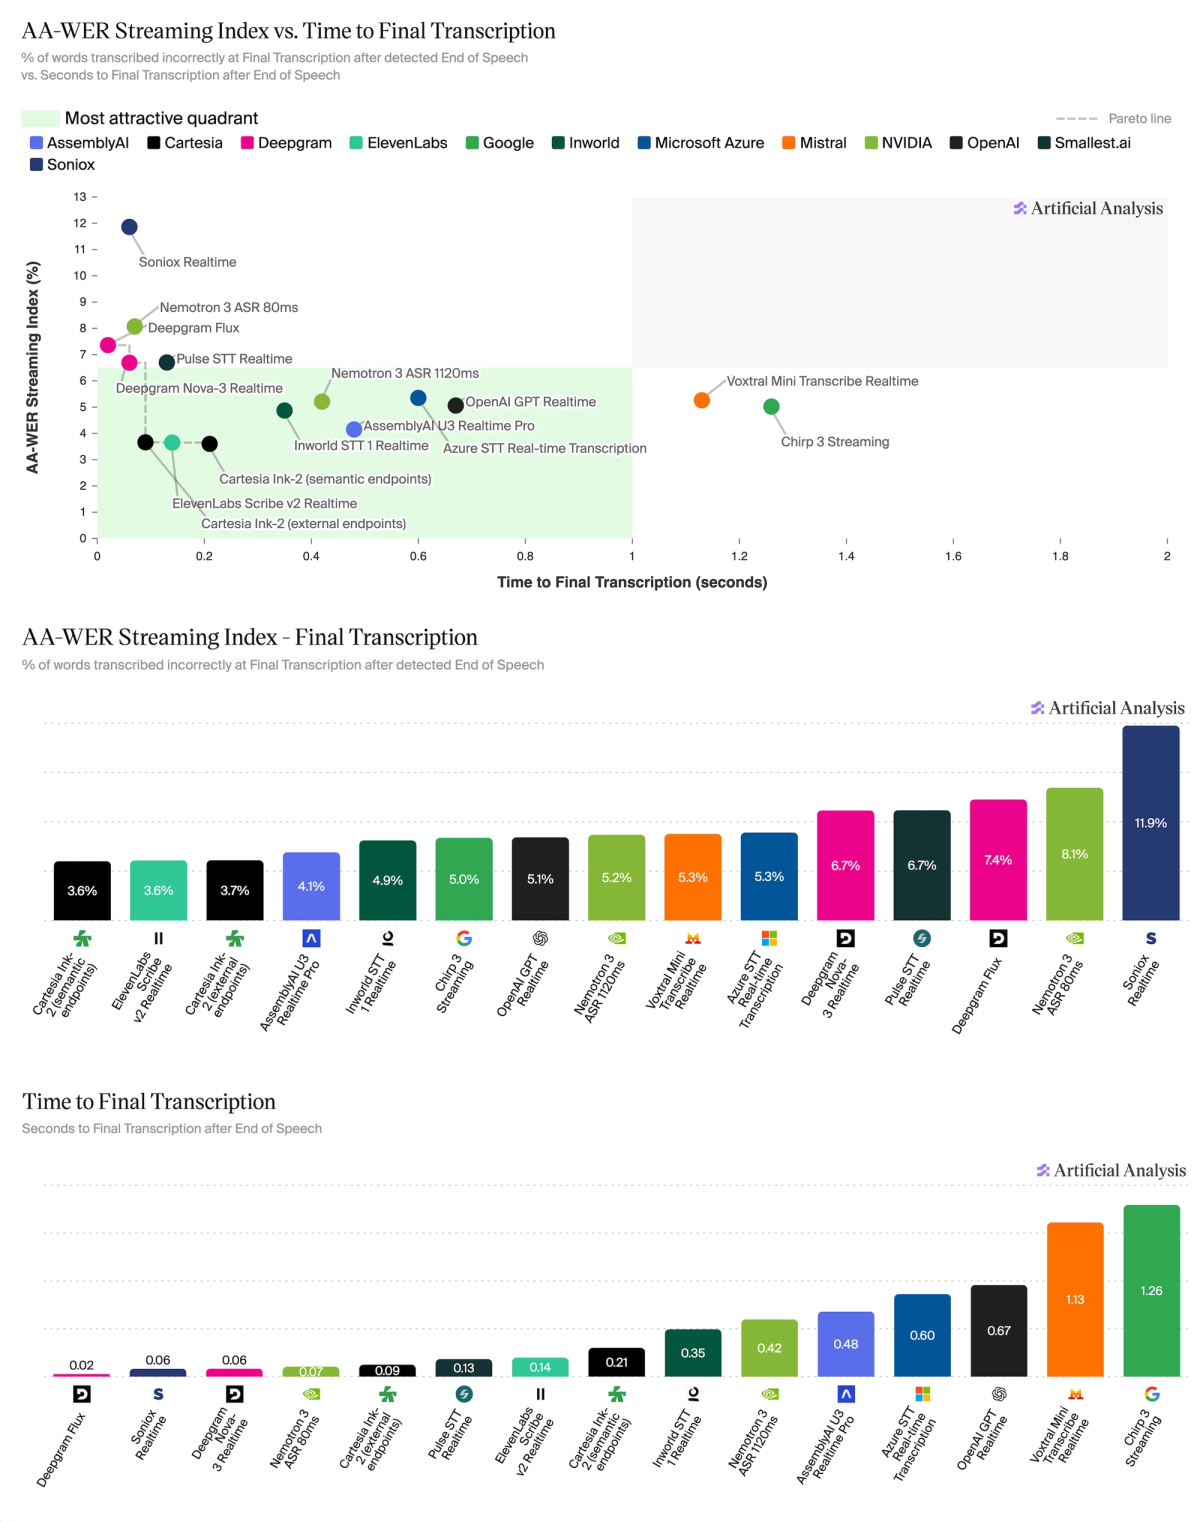
Представляем AA-WER Streaming, наш новый эталонный тест для измерения потоковой передачи речи в текст, моделирующий точность и задержку для сценариев использования голосовых агентов. Оптимальные по Парето модели в этом новом тесте включают модели Cartesia, ElevenLabs и Deepgram.
Потоковая передача речи в текст (STT) обеспечивает транскрипцию в реальном времени в голосовых агентах и субтитры в реальном времени, где модели должны балансировать между точностью и скоростью. Быстрая расшифровка особенно важна для того, чтобы ответы выглядели естественно, и оставляет больше времени ответа на рассуждения и вызовы инструментов. Точность также имеет значение, поскольку ошибки транскрипции усугубляются последующими рассуждениями и формированием речи.
Модели потоковой передачи STT расшифровывают звук по мере его подачи, непрерывно обмениваясь выходными данными, в отличие от автономных (пакетных) моделей, которые обрабатывают весь файл сразу и обычно работают медленнее.
Что мы измеряем
AA-WER Streaming сообщает о частоте ошибок в словах и задержке вместе, измеренных с момента обнаружения окончания речи, с линией Парето, точность которой увеличивается по мере увеличения времени расшифровки полученной речи. Для прямого сравнения с офлайн-моделями по точности мы тестируем эти модели потоковой передачи на тех же ~8 часах аудио, что и наш оффлайн-тест AA-WER v2.0: AA-AgentTalk, Earnings22-Cleaned-AA, VoxPopuli-Cleaned-AA.
Мы измеряем WER и задержку как парные показатели в двух точках после того, как Silero VAD обнаружил окончание речи
Первая финальная транскрипция: WER измеряется на первой конечной транскрипции, возвращаемой после обнаружения окончания речи. Задержка — это время в секундах от окончания речи до финальной расшифровки. Это более полезно для понимания производительности автономной модели потоковой транскрипции, а также для более высокой точности.
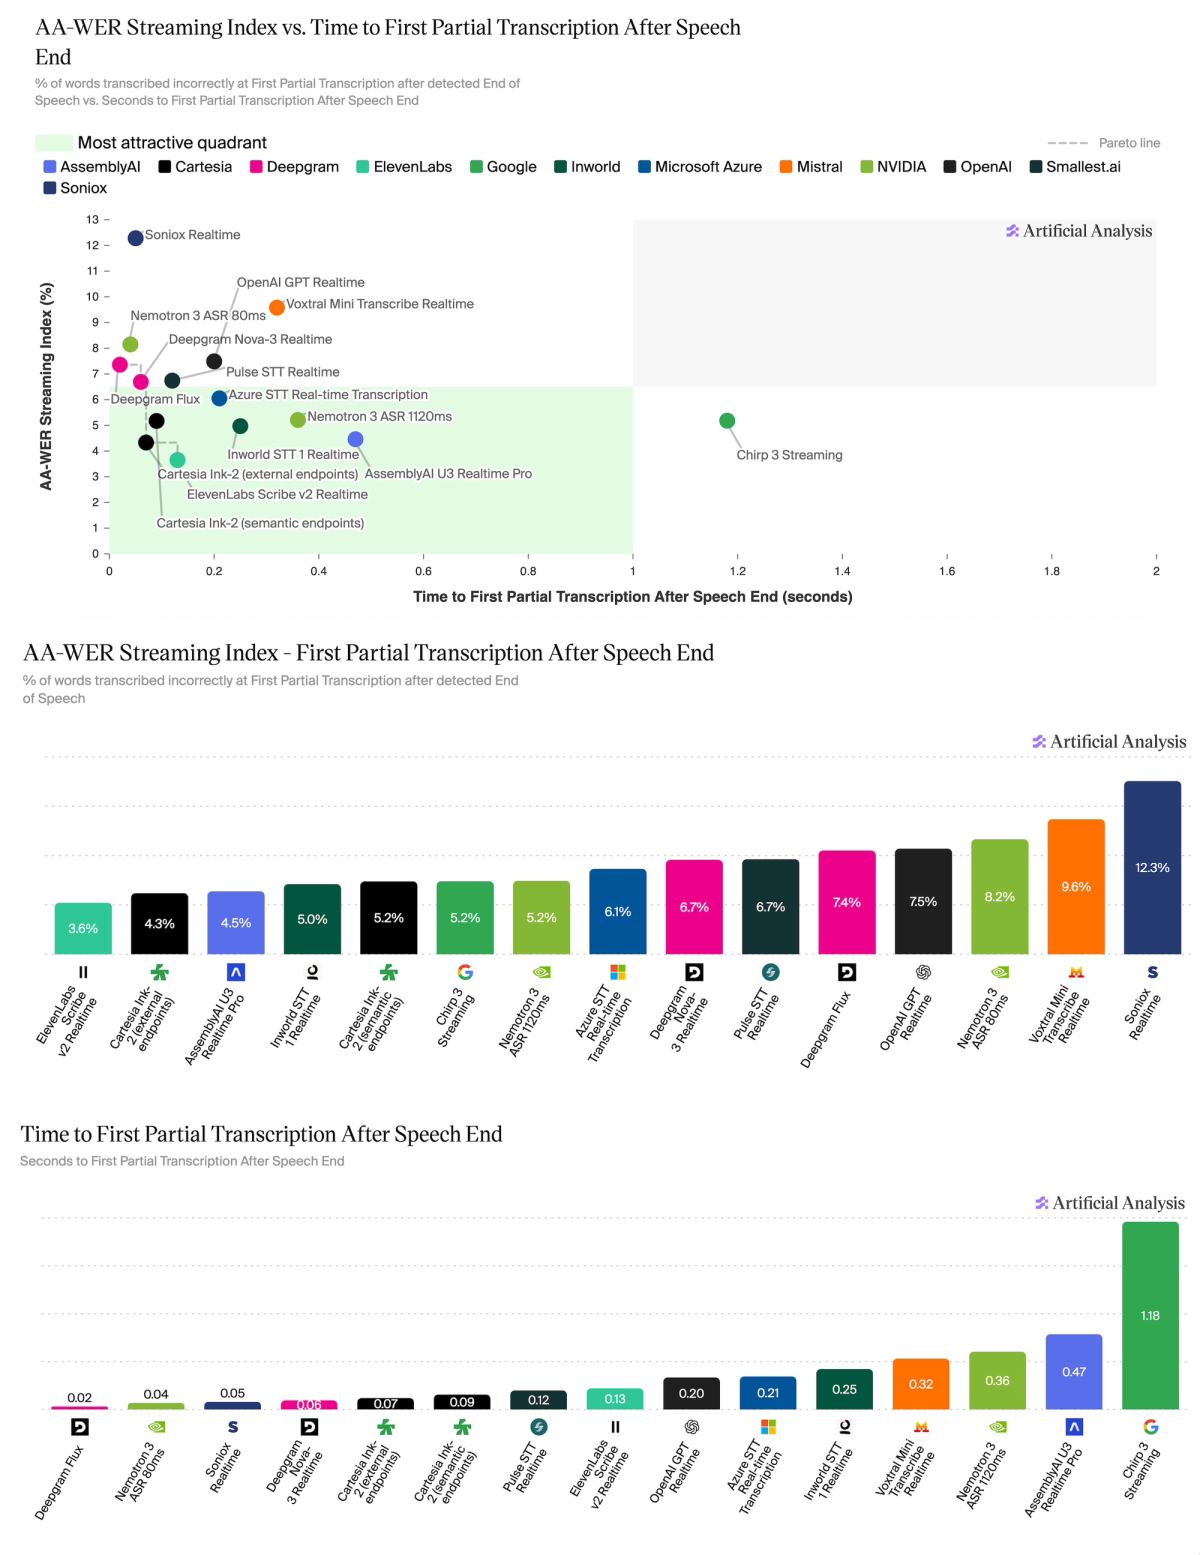
Первая частичная транскрипция: WER измеряется по первому событию, несущему транскрипт (частичному или окончательному), возвращаемому после обнаружения окончания речи. Задержка — это время в секундах от окончания речи до первого события расшифровки. Это более полезно для почти мгновенной транскрипции задач с низкой точностью, таких как ответ на вопросы «да» или «нет», или для спекулятивного декодирования.
Ключевые результаты
➤ Самая высокая точность Final после окончания речи: @Cartesia Ink-2 (семантические конечные точки) с WER 3,59%, задержка 0,21 с, за ней следуют ElevenLabs Scribe v2 Realtime (3,64%, 0,14 с) и Cartesia Ink-2 (внешние конечные точки) (3,66%, 0,09 с)
➤ Самая высокая точность при первой части после окончания речи: @ElevenLabs Scribe v2 Realtime с WER 3,65%, задержкой 0,13 с, за ней следуют Cartesia Ink-2 (внешние конечные точки) (4,33%, 0,07 с) и @AssemblyAI U3 Realtime Pro (4,46%, 0,47 с)
➤ Самая быстрая транскрипция: @DeepgramAI Flux опережает как Final, так и Partial со временем 0,020 с и 0,019 с соответственно (оба 7,36% WER). В финале за ним следуют @soniox_ai Realtime и Deepgram Nova-3 Realtime (оба 0,06 с); в First Partial за ним следуют @NVIDIA Nemotron 3 ASR 80 мс (0,04 с) и Soniox Realtime (0,05 с)
Приведенные ниже диаграммы включают границу Парето между точностью и скоростью, поэтому вы можете составить список моделей, которые лучше всего соответствуют вашим ограничениям по задержке, сохраняя при этом высокую точность. Подробности смотрите ниже ⬇️
На первом частичном рубеже находятся Deepgram Flux (7,36%, 0,019 с), Deepgram Nova-3 Realtime (6,69%, 0,057 с), Cartesia Ink-2 (внешние конечные точки) (4,33%, 0,072 с) и ElevenLabs Scribe v2 Realtime (3,65%, 0,132 с).
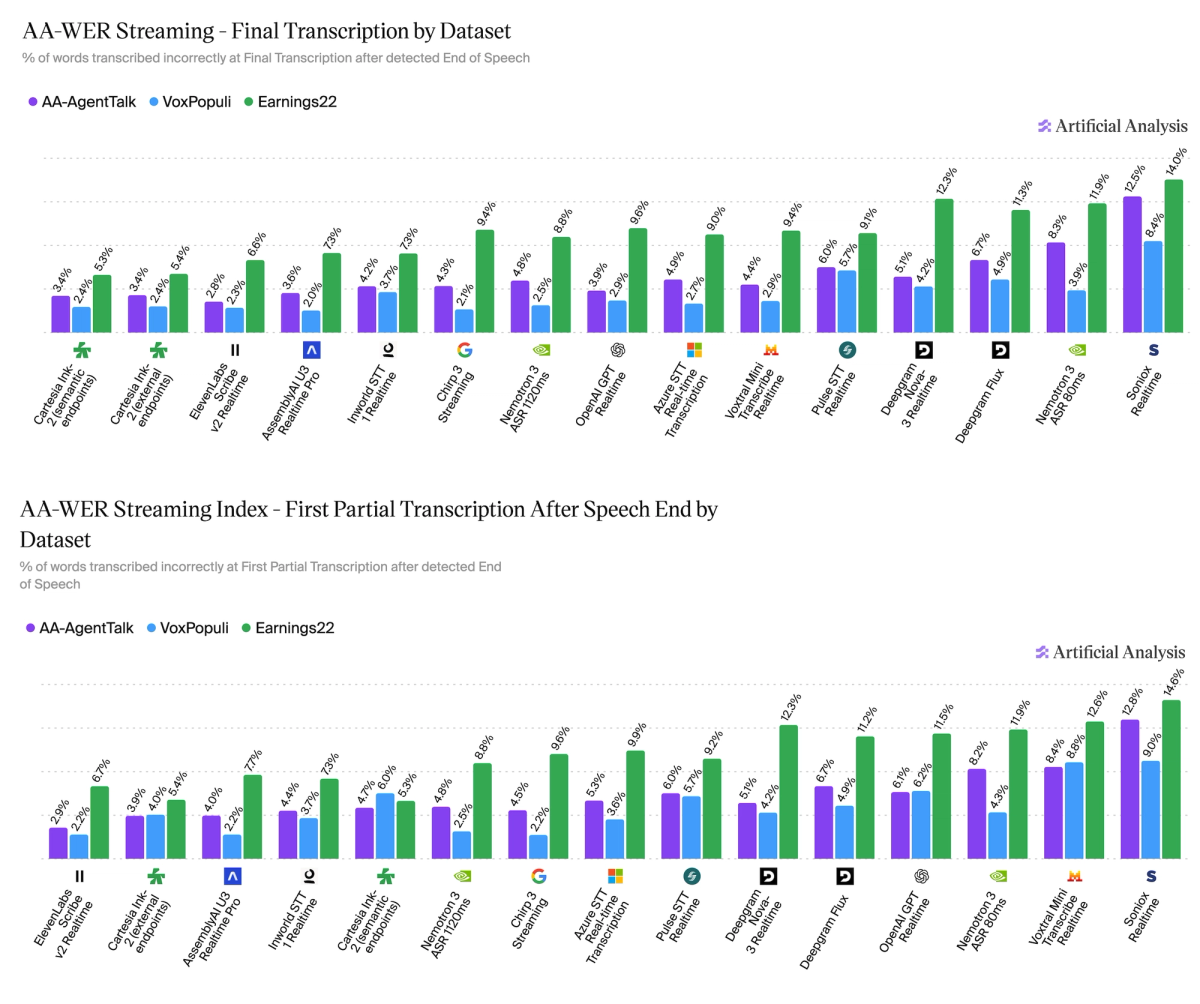
Производительность существенно различается в трех наборах данных с разной длиной звука, акцентами, словарным запасом и фоновым шумом. На нашем частном тестовом наборе AA-AgentTalk ElevenLabs Scribe v2 Realtime лидирует как в окончательном (2,8%), так и в частичном (2,9%); на VoxPopuli в финале лидирует AssemblyAI U3 Realtime Pro с 2,0%, а Google Chirp 3 Streaming частично лидирует с 2,2%; на Earnings22 Cartesia Ink-2 (семантические конечные точки) лидирует в обоих случаях с показателем 5,3%. Ни одна модель не может быть лидером везде.
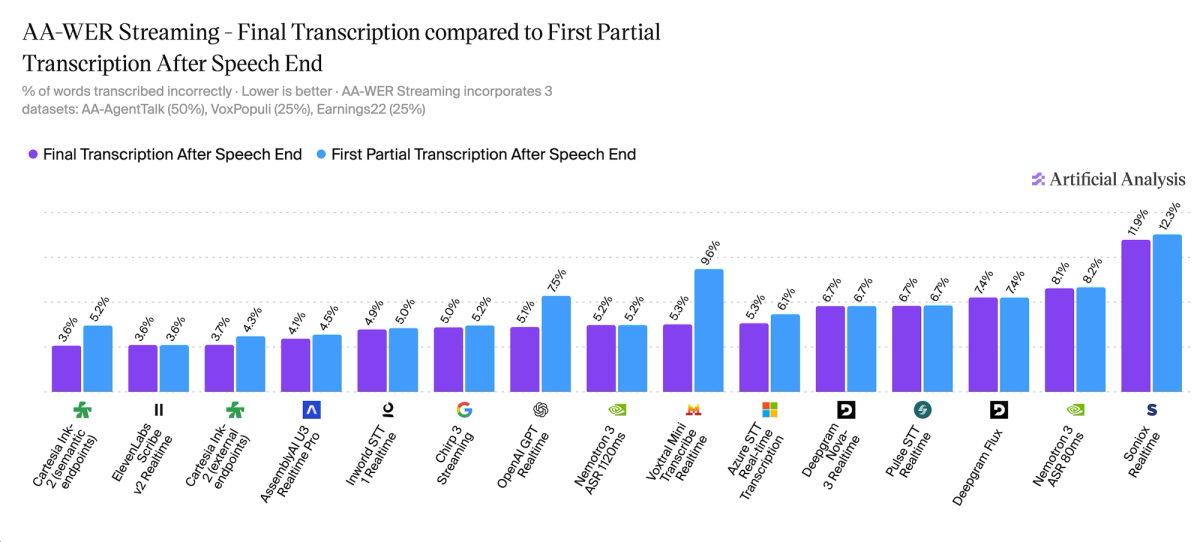
Среди протестированных моделей потоковой передачи STT окончательная транскрипция в среднем всего на 0,7 п.п. точнее, чем первая частичная. Большинство моделей уже достигли своей окончательной точности к первой части (например, ElevenLabs Scribe v2 Realtime 3,6% WER в обеих, Deepgram Nova-3 6,7% в обеих, Deepgram Flux 7,4% в обеих). В ожидании финала несколько улучшились в материальном отношении, во главе с Voxtral Mini Transcribe Realtime (9,6% → 5,3%) и OpenAI GPT Realtime Whisper (7,5% → 5,1%).
Цены на потоковую передачу STT варьируются от 2 до 17 долларов за 1 тыс. минут. Cartesia Ink-2 (внешние конечные точки) (4 доллара США, 3,7% WER) и ElevenLabs Scribe v2 Realtime (6,50 долларов США, 3,6% WER, 0,14 секунды) лидируют по соотношению цены и конечной точности; Soniox самый дешевый — 2 доллара, но наименее точный — 11,9% WER.