AA-WER v2.0: бенчмарк точности распознавания речи для реальных условий
Вторая версия бенчмарка транскрибации: замеры устойчивости моделей к шуму, реверберации и сленгу.

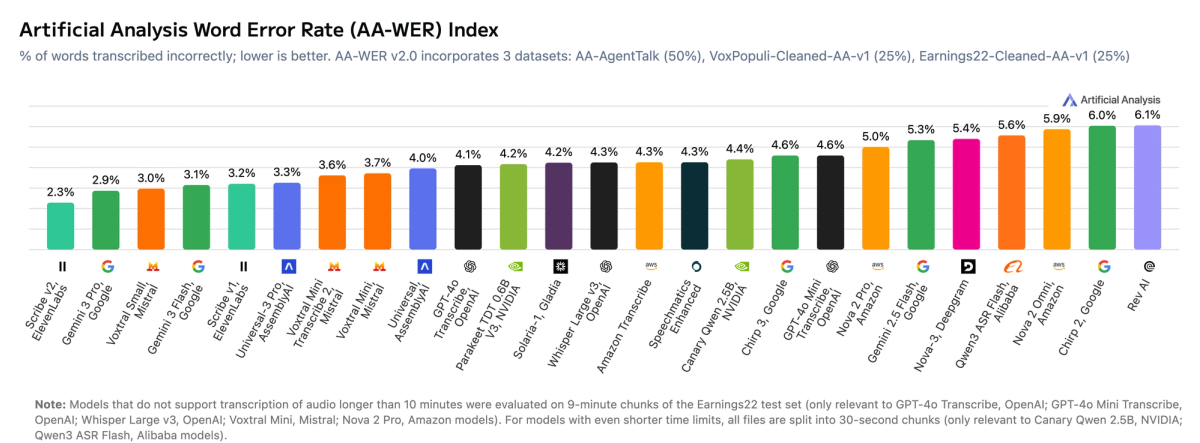
Мы представляем AA-WER v2.0, крупное обновление нашего теста точности преобразования речи в текст (STT), включающее AA-AgentTalk, новый запатентованный набор оценочных данных, ориентированный на речь, адресованную голосовым агентам, а также очищенные достоверные расшифровки для VoxPopuli и Earnings22.
Точный сравнительный анализ STT имеет решающее значение для заинтересованных сторон в экосистеме речевого искусственного интеллекта, поскольку он позволяет
- Разработчики и предприятия могут выбрать правильную модель и поставщика STT на основе надежных данных о точности и речи, которая лучше отражает их вариант использования.
- Лаборатории искусственного интеллекта будут лучше поддерживать клиентов, понимая, как их модели работают с разнообразной реальной речью.
Почему AA-WER v2.0
Голосовые агенты — одно из наиболее быстро развивающихся приложений преобразования речи в текст (STT). От службы поддержки клиентов и агентов внутренней поддержки до генерации кода с помощью голосовых подсказок и заметок о встречах с помощью искусственного интеллекта — точность базовой модели транскрипции напрямую влияет на удобство работы пользователей и производительность последующих задач.
Однако большинство общедоступных тестов STT были разработаны до этой волны. Широко используемые наборы данных публичной оценки обычно охватывают статьи и книги, прочитанные вслух, парламентские заседания, звонки о доходах и другие записи встреч, но ни один из тех, что мы видели, не был сосредоточен на взаимодействии голосовых агентов. Публичные тестовые наборы также несут растущий риск заражения данных, и мы обнаружили ошибки в существующих транскрипциях, которые несправедливо наказывают модели, которые правильно расшифровывают аудио.
AA-WER v2.0 устраняет эти пробелы с помощью AA-AgentTalk, нового закрытого набора данных, основанного на оценке голосовых агентов, а также очищенных расшифровок достоверных данных для VoxPopuli и Earnings22.
Что нового в AA-WER v2.0
Мы внесли пять ключевых изменений, чтобы усилить эталон
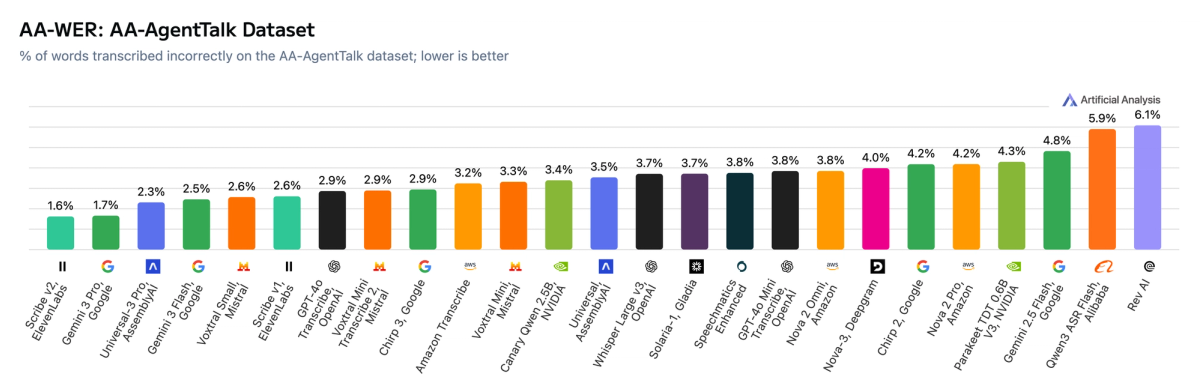
- Новый запатентованный набор данных — AA-AgentTalk (вес 50 %): 469 образцов (~ 250 минут) речи, соответствующих сценариям использования голосовых агентов, служащих отложенным набором тестов, который снижает риск переподгонки моделей под общедоступные тесты.
- Очищенные расшифровки общедоступных наборов данных: мы вручную проверили и исправили ошибки в исходных данных VoxPopuli и Earnings22, выпустив VoxPopuli-Cleaned-AA и Earning22-Cleaned-AA.
- Удаление AMI-SDM: ошибки в стенограмме были слишком велики, чтобы их можно было исправить без принятия большого количества решений, поэтому мы удалили этот набор данных из эталонного теста.
- Улучшенный нормализатор текста: специальный нормализатор, основанный на нормализаторе английского языка Whisper, позволяющий уменьшить искусственно раздутый WER из-за различий в форматировании, а не из-за реальных ошибок транскрипции.
- Новый вес: 50 % AA-AgentTalk, 25 % VoxPopuli-Cleaned-AA, 25 % Earnings22-Cleaned-AA.
Краткий обзор AA-WER v2.0
Обновленный тест оценивает модели примерно по 8 часам аудио из трех наборов данных, взвешенных, чтобы отразить важность вариантов использования голосового агента, сохраняя при этом охват формальной и технической речи
| Набор данных | Тип | Образцы | Диапазон продолжительности выборки | Общая продолжительность | Взвешивание |
|---|---|---|---|---|---|
| AA-AgentTalk | Собственные, отложенные, включая новые варианты использования, такие как голосовые агенты. | 469 | 8–109 секунд | ~250 мин. | 50% |
| VoxPopuli-Очищенный-AA | Парламентские разбирательства | 628 | 5–38 секунд | ~119 мин. | 25% |
| Доход22-Очищенный-AA | Корпоративные звонки о доходах | 6 | ~14-22 минуты | ~115 мин. | 25% |
Результаты в каждом наборе данных рассчитываются как средневзвешенное по времени WER, а затем объединяются с использованием приведенных выше весов для получения окончательного показателя AA-WER.
Ключевые результаты
ElevenLabs Scribe v2 лидирует с 2,3% AA-WER, за ним следуют Gemini 3 Pro от Google с 2,9%, Voxtral Small от Mistral с 3,0%, Gemini 2.5 Pro от Google с 3,1% и Gemini 3 Flash с 3,2%. ElevenLabs Scribe v2 лидирует по двум из трех наборов данных компонентов, а Gemini 3 Pro от Google лидирует по VoxPopuli.
Общие результаты AA-WER v2.0
Производительность варьируется в зависимости от набора данных, что демонстрирует различные сильные стороны модели
- AA-AgentTalk (речь голосового агента): ElevenLabs Scribe v2 (1,6%), AssemblyAI Universal-3 Pro (2,3%), Google Gemini 3 Flash (2,5%)
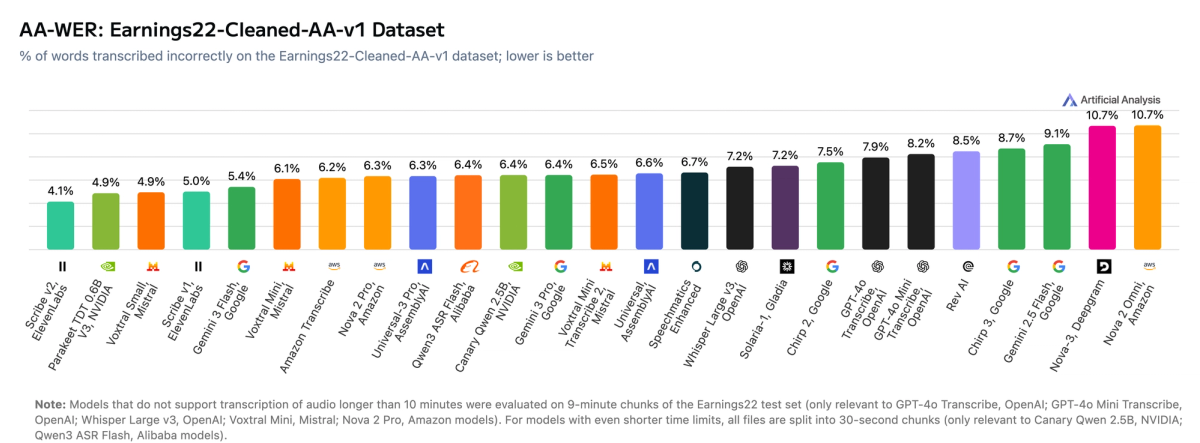
- Earnings22-Cleaned-AA (корпоративные звонки о доходах): ElevenLabs Scribe v2 (4,1%), Google Gemini 2.5 Pro (4,4%), NVIDIA Parakeet TDT 0.6B V3 (4,9%)
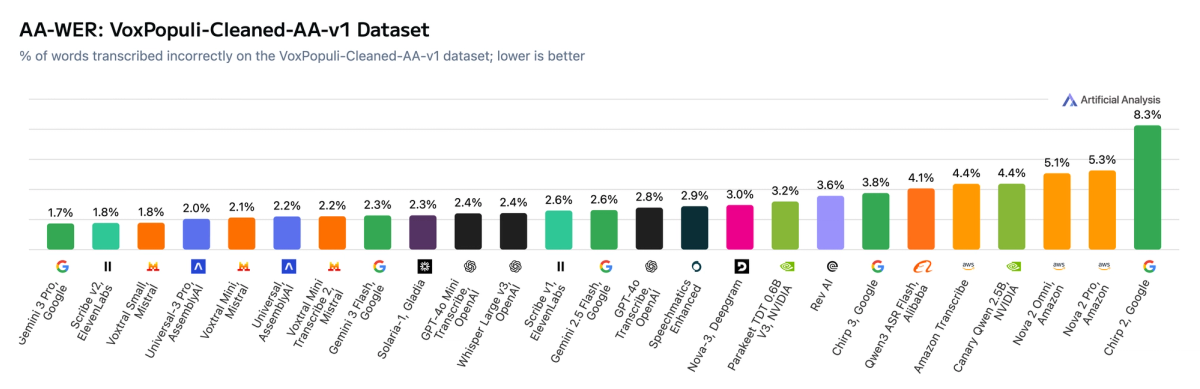
- VoxPopuli-Cleaned-AA (парламентские разбирательства): Google Gemini 3 Pro (1,7%), ElevenLabs Scribe v2 (1,8%), Mistral Voxtral Small (1,8%)
AA-WER по индивидуальному набору данных - AA-AgentTalk
AA-WER по индивидуальному набору данных — Earnings22-Cleaned-AA
AA-WER по индивидуальному набору данных — VoxPopuli-Cleaned-AA
AA-AgentTalk: новый набор данных для оценки голосовых агентов.
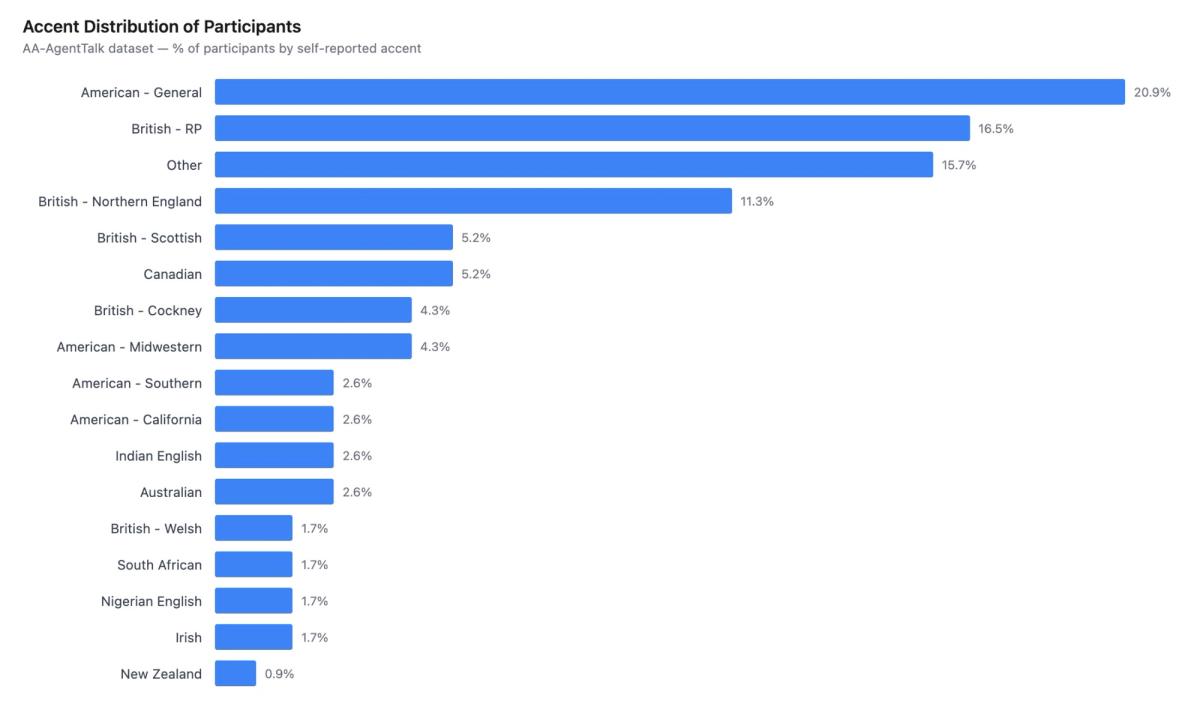
AA-AgentTalk — это собственный набор оценочных данных, разработанный компанией AI Стата и ориентированный на типы речи, предназначенные для голосовых агентов и других растущих реальных приложений. Будучи долгосрочным набором данных, он снижает риск обучения или точной настройки моделей для обеспечения хорошей работы на общедоступных тестовых наборах.
Набор данных содержит 469 аудиосэмплов общей длительностью около 250 минут, длительность отдельных сэмплов составляет от 8 до 109 секунд. Образцы представляют собой скриптовые подсказки, читаемые участниками вслух и отражающие реалистичное взаимодействие голосовых агентов в 6 категориях контента, 17 акцентных группах и 8 стилях речи. Подсказки были созданы, чтобы отразить реалистичное взаимодействие голосовых агентов, охватывающее голосовые агенты и колл-центры (40 %), взаимодействие агентов ИИ (20 %), отраслевой жаргон (15 %), встречи (10 %), потребительские и личные (10 %) и средства массовой информации (5 %).
| Категория | Подкатегории | Образец |
|---|---|---|
| Голосовые агенты и колл-центры (40%) | Поддержка клиентов и внутренняя поддержка, сложные запросы и эскалация, AI-секретарь, планирование и бронирование | |
| Подсказки и взаимодействие ИИ-агента (20%) | Агенты кодирования, Агенты исследований и анализа, Агенты написания и коммуникации, Агенты данных и анализа, Агенты рабочих процессов и задач | |
| Промышленный жаргон (15%) | Финансовые услуги, здравоохранение, страхование, юриспруденция, инженерия и ресурсы, другое | |
| Встречи и сотрудничество (10%) | Встречи с клиентами и продажами, Финансовые и деловые встречи, Технические встречи, Корпоративные встречи, Межфункциональные встречи | |
| Потребительские и личные (10%) | Персональный помощник, шоппинг, развлечения, умный дом, приложения для повышения производительности | |
| СМИ (5%) | Интервью/подкасты, документальные фильмы/контент на YouTube, панельные дискуссии/ток-шоу, новости и комментарии, спортивные комментарии |
Акцентное распределение участников
Поломка устройства и микрофона
| Устройство | Встроенный | USB | Проводные наушники/вкладыши | Bluetooth-гарнитура/наушники | Другое |
|---|---|---|---|---|---|
| Ноутбук | 47,0% | 2,6% | 5,1% | 8,5% | 0,9% |
| Телефон | 17,9% | - | - | 0,9% | - |
| Рабочий стол | 2,6% | 8,5% | 4,3% | - | - |
| Таблетка | 0,9% | - | 0,9% | 0,9% | - |
В большинстве записей (75%) используется естественный голос, а для остальных заданы стили, включая быструю, тихую, медленную, громкую речь, усталость/зевание, переменную громкость и легкую запыхавшуюся речь. Примерно 70% из них были записаны в тихих помещениях, а 30% — с фоновым шумом.
Разработка набора данных
Мы набрали участников, которые записали бы, как они читают подсказки, отражающие реальное взаимодействие голосовых агентов. Каждый участник записал несколько подсказок в разных категориях и стилях речи, используя свои устройства в своей естественной среде.
На первом этапе участники просматривали свои собственные стенограммы и могли редактировать их, чтобы они отражали то, что они на самом деле сказали, а не то, что содержалось в тексте подсказки. Затем мы просмотрели около 1300 записей и сузили их до 469, гарантируя, что стенограммы точно соответствуют их звуку. Затем наша команда вручную проверяла все стенограммы на предмет точности, одобряя или исправляя каждую, чтобы обеспечить дословную достоверность.
Очищенные расшифровки VoxPopuli и Earnings22.
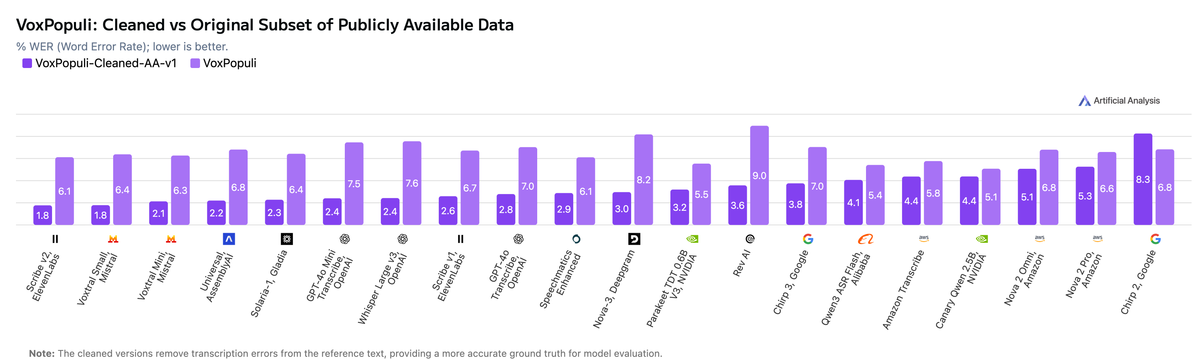
Справочные стенограммы в VoxPopuli и Earnings22 содержали неточности – случаи, когда основная истина не соответствовала тому, что было сказано на самом деле. Неточные фактические данные наказывают модели, которые правильно расшифровывают аудио, поэтому мы вручную проверили и исправили расшифровки, выпустив VoxPopuli-Cleaned-AA и Earnings22-Cleaned-AA.
Что мы исправили
Мы исправили стенограммы, чтобы дословно отразить сказанное выступавшими. Ключевые исправления включали
- Неправильные слова: орфографические ошибки, неправильно расслышанные слова, неправильные сокращения в исходных ссылках.
- Пропущенные слова: сохранены или добавлены повторы для дословной точности (например, «the», где говорящий искренне повторил слово).
- Частичное заикание: удалены неполные фрагменты слов (например, «evac-» в «evac- эвакуировать»), поскольку они по своей сути неоднозначны в транскрипции.
- Грамматика и время: когда говорящие использовали неправильную грамматику (особенно говорящие с акцентом), но выбор слов был ясен, мы сохраняли дословные слова в том виде, в каком они произнесли, а не исправляли их.
Элементы, уже нормализованные пакетом SepthNormalizer (например, заглавные буквы, знаки препинания и слова-заполнители), не были изменены, поскольку эти различия уже обрабатываются во время расчета WER.
VoxPopuli-Cleaned-AA: до и после
Оригинал стенограммы: «Господин Президент, у меня есть еще одна претензия к этой процедуре: она не является секретной».
Уточненная стенограмма: «Спасибо, господин Президент, у меня есть еще одна претензия к этой процедуре: она не является секретной».
Оригинал стенограммы: «Кроме того, мнение AFET делит подходящие страны на кандидатов, потенциальных кандидатов, соседей и, в исключительных и должным образом обоснованных обстоятельствах, стратегически важные третьи округа».
Уточненная стенограмма: «Кроме того, мнение AFET делит подходящие страны на кандидатов, потенциальных кандидатов, соседей и, в исключительных и должным образом обоснованных обстоятельствах, стратегически важные третьи страны».
В среднем после очистки модель WER на VoxPopuli подешевела на 3,5 процентных пункта (п.п.). Лидерами снижения WER на VoxPopuli стали Rev AI (5,4 п.п.), Nova-3, Deepgram (5,2 п.п.) и Whisper Large v3, OpenAI (5,1 п.п.). После чистки ухудшилась только одна модель: Chirp 2, Google (+1,4 п.п. выше WER).
VoxPopuli: очищенные и исходные общедоступные данные
Earnings22-Cleaned-AA: образец
«Спасибо, Дарси, и приветствуем всех на нашем декабрьском ежеквартальном звонке аналитикам. Декабрьское квартальное производство показало значительное улучшение по сравнению с сентябрьским кварталом с рекордной производительностью и улучшением содержаний, улучшением извлечения и улучшением денежного потока...»
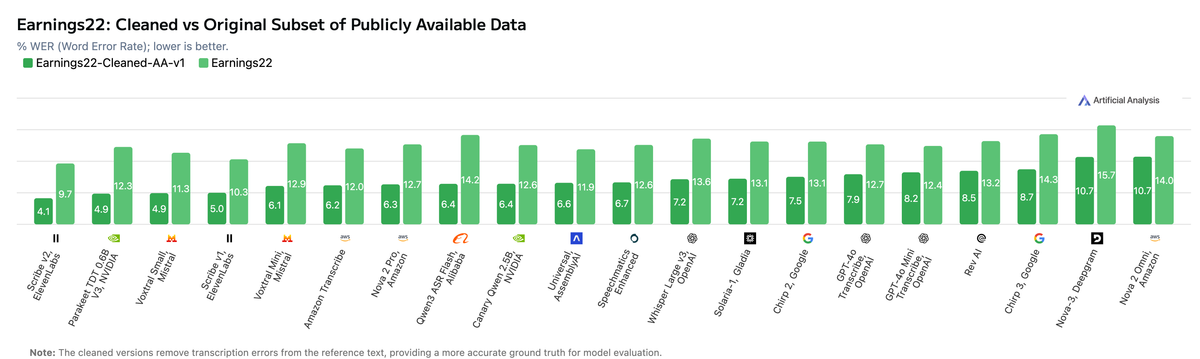
В среднем WER модели на Earnings22 после очистки снизился на 5,6 процентных пункта (п.п.), и ни одна из моделей не имела более высокого WER после очистки. Лидерами снижения WER по прибыли22 стали Qwen3 ASR Flash, Alibaba (7,7 п.п.), Parakeet TDT 0.6B V3, NVIDIA (7,4 п.п.) и Gemini 2.5 Pro, Google (6,9 п.п.).
Топ-моделями, у которых WER снизился по обоим наборам данных, стали Whisper Large v3, OpenAI (5,1 п.п. на VoxPopuli; 6,4 п.п. на Earnings22), Voxtral Small, Mistral (4,6 п.п.; 6,4 п.п.) и Voxtral Mini, Mistral (4,1 п.п.; 6,8 п.п.).
Доходы22: очищенные и исходные общедоступные данные
Публичный релиз
Мы публикуем наши очищенные наборы данных стенограмм на Hugging Face, чтобы поддержать исследовательское сообщество STT
- VoxPopuli-Cleaned-AA на обнимающем лице
- Earnings22-Cleaned-AA на обнимающем лице
Текущая версия очищенной расшифровки в обоих репозиториях — версия 1.0, используемая в AA-WER v2.0.
Эти очищенные стенограммы отражают наши усилия по дословному установлению истины, полученной путем ручной проверки и перекрестной проверки всего набора данных. Будущие усовершенствования будут выпущены в виде последующих версий. Если вы обнаружите проблемы, мы будем рады обратной связи через нашу страницу контактов или Discord.
Улучшенный нормализатор текста.
Мы разработали собственный нормализатор текста на базе пакета quietNormalizer, чтобы уменьшить искусственно завышенное значение WER из-за различий в форматировании, а не из-за реальных ошибок транскрипции. Ключевые улучшения включают в себя
- Разделение цифр: предотвращает зачисление несоответствий в группировке номеров (например, «1405 553 272» против «1405553272») как ошибки.
- Ведущие нули: Сохраняет ведущие нули в кодах и идентификаторах.
- Разговорные символы: нормализует такие символы, как «+» и «\_», когда они произносятся вслух.
- Форматирование времени: удаляет лишние «:00» во времени (например, «19:00» против «19:00»).
- Орфографические эквиваленты: добавляют дополнительные орфографические эквиваленты английского языка (США/Великобритания) (например, «totalled» и «totaled»).
- Варианты собственных существительных: принимает эквивалентные варианты написания для неоднозначных имен собственных в нашем наборе данных (например, «Матео» и «Матео»).
Эта нормализация гарантирует, что модели оцениваются по фактической точности транскрипции, а не по выбору форматирования на поверхностном уровне.
Поскольку модели преобразования речи в текст продолжают быстро совершенствоваться, мы будем продолжать обновлять наши тесты новыми моделями, наборами данных и методами оценки.
Ресурсы
- Методика бенчмаркинга
- VoxPopuli-Cleaned-AA на обнимающем лице
- Earnings22-Cleaned-AA на обнимающем лице


