Бенчмарки флагманской GPT-6 Astra: замеры ума, задержки и цены
Подробный разбор производительности топовой модели OpenAI: тесты глубокого рассуждения и работы с длинным контекстом.
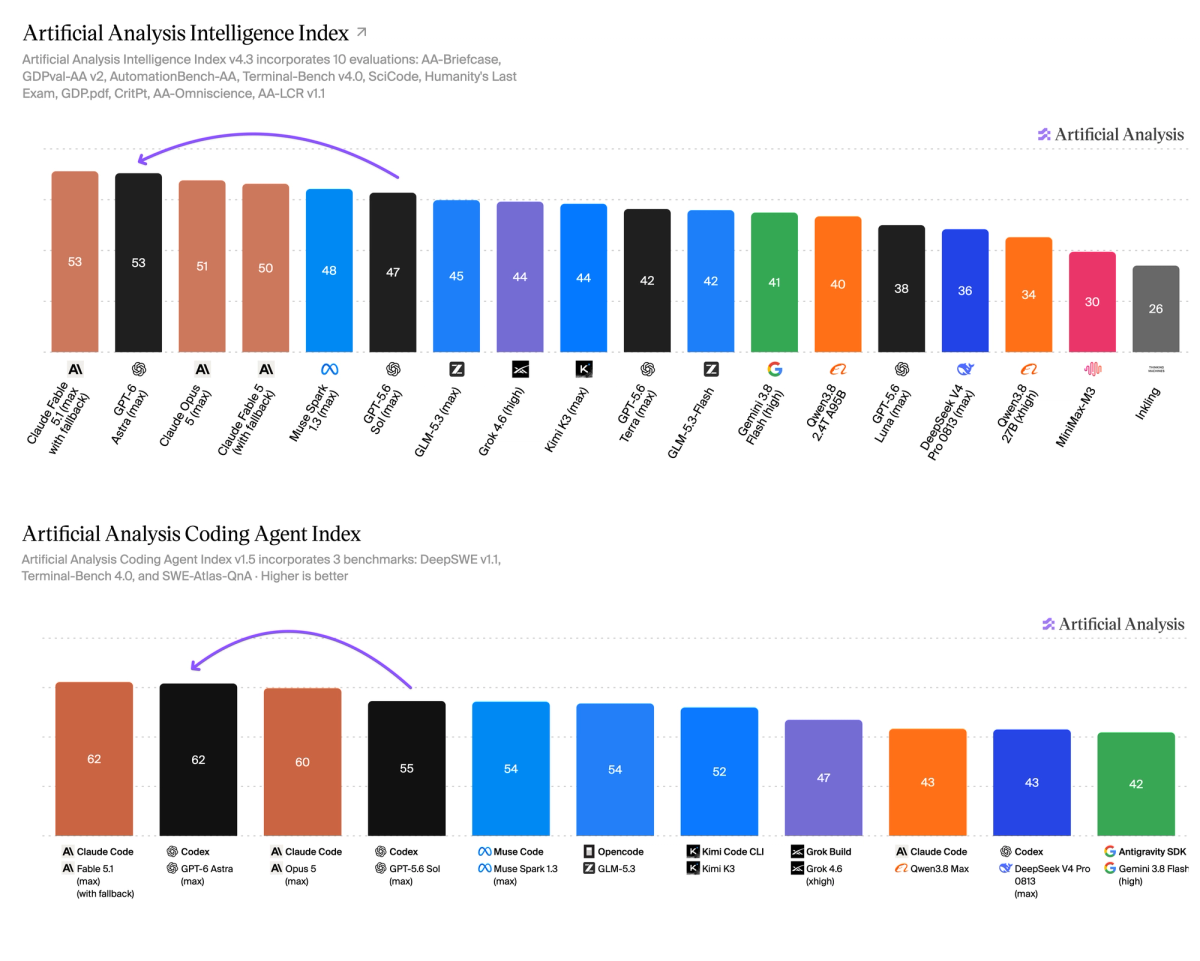
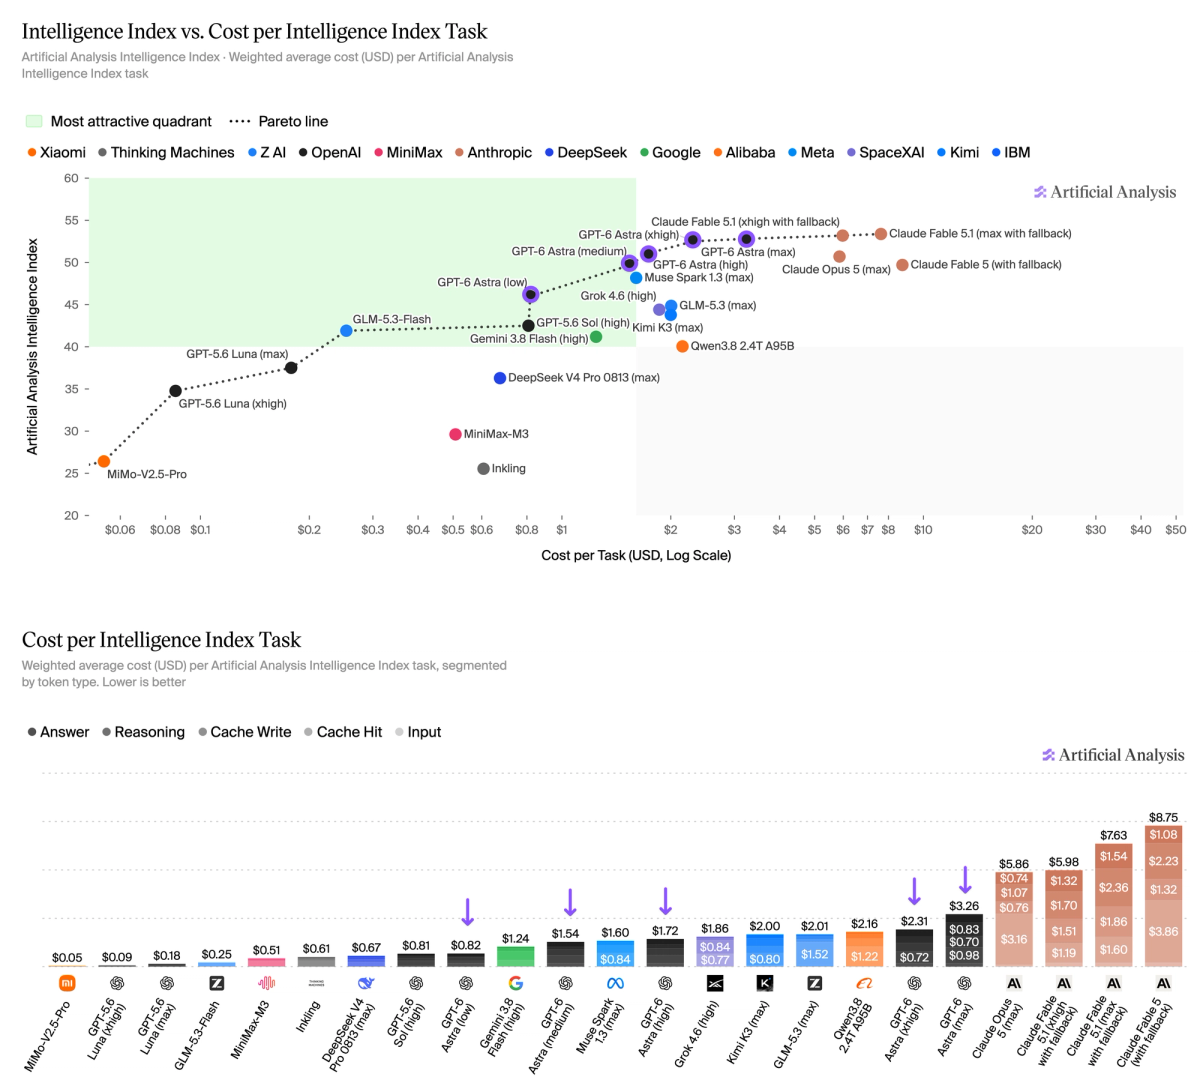
GPT-6 Astra делит лидерство с Claude Fable 5.1 в обоих наших флагманских индексах при более низкой цене. Astra равна Fable 5.1 по индексу интеллекта за ~ 40% стоимости и по индексу кодирующего агента за ~ 60% стоимости.
Цена в 2,5 раза превышает текущие цены GPT-5.6 Sol по всем направлениям: с 4/20 до 10/50 долларов за миллион токенов ввода/вывода, с той же 90% скидкой на чтение кэша и 25% надбавкой за запись в кэш.
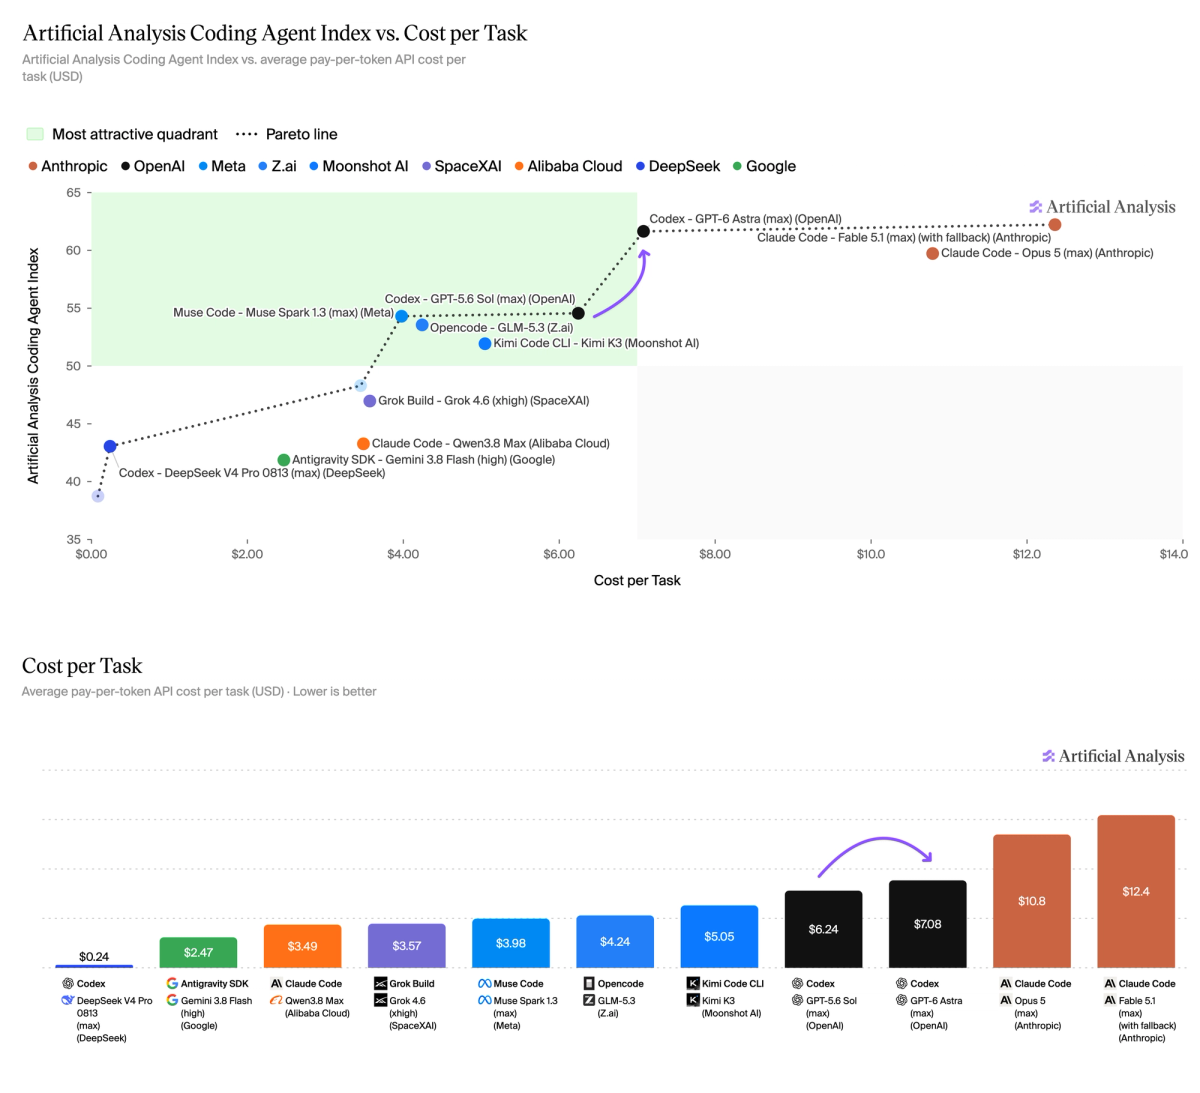
В индексе интеллекта искусственного анализа GPT-6 Astra связывает Claude Fable 5.1 с ~40% стоимости задачи, набирая 6 баллов у GPT-5.6 Sol. В индексе агентов кодирования искусственного анализа он связывает Claude Fable 5.1 с ~60% стоимости задачи, что обусловлено наименьшим использованием токенов среди всех агентов в индексе.
Индекс искусственного анализа интеллекта – основные выводы
➤ Равное первое место в Индексе интеллекта: GPT-6 Astra (макс.) набирает 53 балла в Индексе, уровень с Claude Fable 5.1 (макс. с запасным вариантом). Он набирает 6 баллов по сравнению со своим предшественником GPT-5.6 Sol (макс.).
➤ Занимает большую часть границы затрат: каждый уровень рассуждений Astra находится на границе индекса интеллекта и стоимости задачи. По сравнению с Claude Fable 5.1 (максимум с резервным вариантом) Astra соответствует результату при ~40% стоимости задачи (3,26 доллара США против 7,63 доллара США). При максимальном усилии Astra примерно на 60% дороже GPT-5.6 Sol. Более высокая цена за токен частично компенсируется более низким использованием токена.
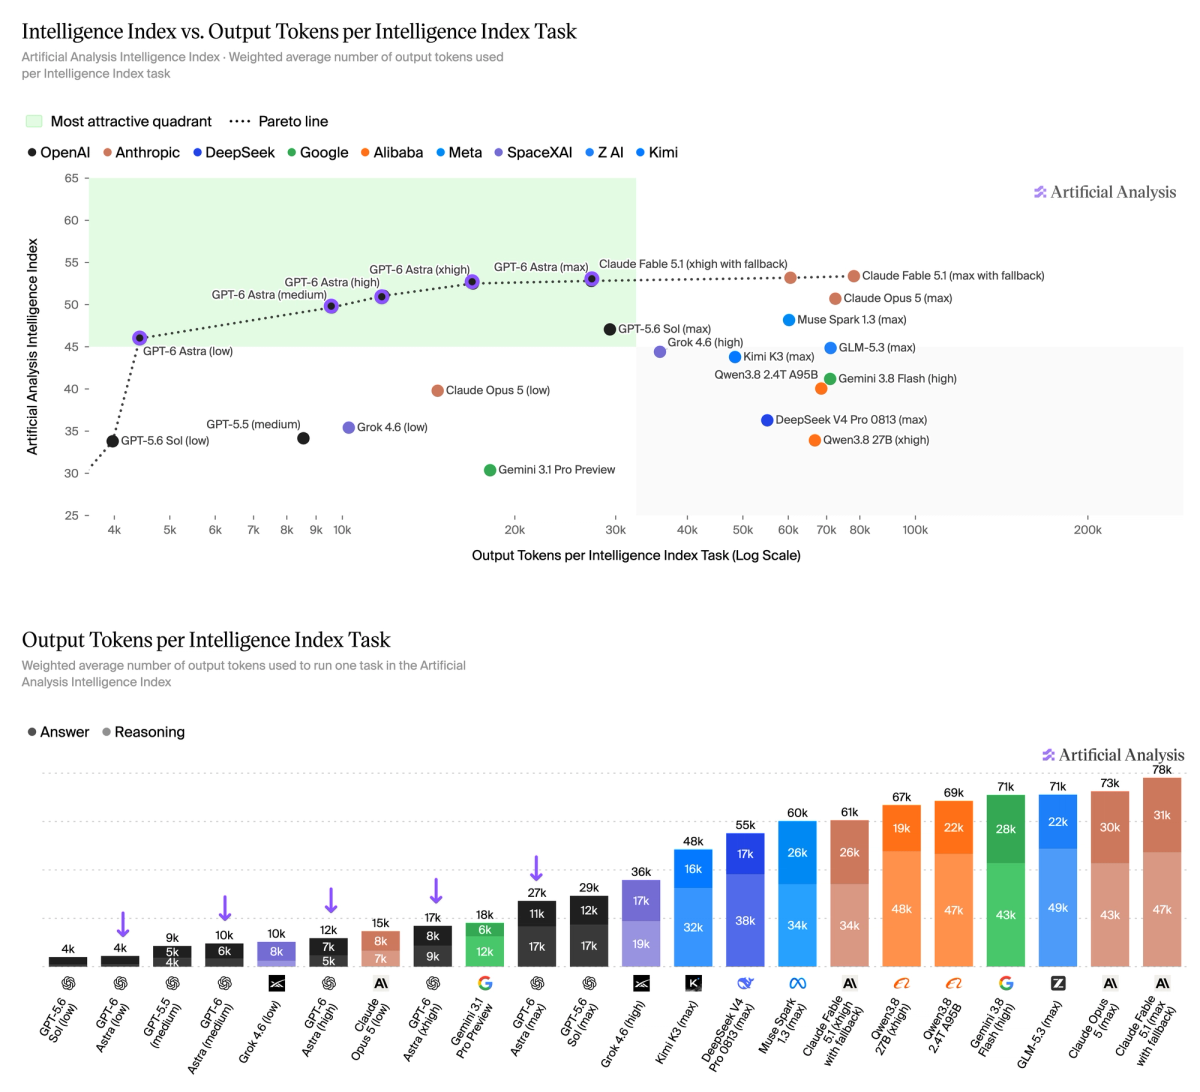
➤ Определяет границу Парето эффективности токена: все рассуждения от низкого до максимального находятся на границе Парето для индекса интеллекта и количества токенов вывода на задачу. При максимальных усилиях Astra использует 27 тыс. токенов вывода на задачу, что составляет примерно треть от Claude Fable 5.1 (максимум с резервным вариантом) при 78 тыс., для того же результата.
➤ Галлюцинирует вдвое меньше, чем GPT-5.6 Sol: GPT-6 Astra видит большой скачок в Всезнании АА, нашем эталоне знаний и галлюцинаций. Это обусловлено значительным снижением частоты галлюцинаций с 92% до 51% при максимальном усилии. В отличие от некоторых моделей, это улучшение не происходит за счет точности — Astra одновременно увеличила точность на 4 пункта.
➤ Прирост примерно на 90 баллов в AA-Портфеле Эло: GPT-6 Astra улучшается на ~90 баллов в AA-Портфеле, нашей передовой оценке долгосрочной научной работы. Модели тестируются в многонедельных проектах со множеством связанных задач и тысячами исходных файлов. Astra отмечает значительный рост как оценок по критериям, так и аналитического качества Elo в AA-Briefcase по сравнению со своим предшественником. В другую сторону мы наблюдаем снижение показателя Presentation Quality Elo, где GPT-5.6 Sol (max) по-прежнему лидирует среди всех моделей.
➤ Лидирует в Terminal-Bench v4.0, AutomationBench-AA и GDP.pdf: GPT-6 Astra набирает 59% в Terminal-Bench v4.0, опережая Claude Fable 5.1 (52%) и на 19 баллов опережая GPT-5.6 Sol (40%). Он набирает 69 % в AutomationBench-AA, нашей реализации теста бизнес-процессов Zapier, опережая Grok 4.6 (67 %) и GPT-5.6 Sol (60 %). В GDP.pdf, который проверяет обоснованность профессиональных документов, он соответствует всем критериям в 31% попыток против 27% для GPT-5.6 Sol.
➤ Снижение производительности в GDPval-AA v2: по сравнению с GPT-5.6 Sol мы наблюдаем снижение примерно на 45 пунктов Эло в GDPval-AA v2 — тесте, который мы адаптировали на основе набора данных OpenAI, измеряющего экономически ценные задачи по 44 профессиям. Мы наблюдали, что GPT-6 Astra использует значительно меньше оборотов, чем другие модели, в задачах GDPval — 24 на задачу при максимальном усилии по сравнению с 45 у GPT-5.6 Sol и 60 оборотов на задачу у Claude Fable 5.1 и Claude Opus 5.
Индекс агента кодирования искусственного анализа – основные выводы
➤ Равенство первого места в индексе кодирующего агента: в Кодексе GPT-6 Astra набирает 62 балла в индексе, находится на одном уровне с Claude Fable 5,1 в Claude Code (62) и опережает Claude Opus 5 (60), GPT-5.6 Sol (55) и Muse Spark 1,3 в Muse Code (54). Его преимущество над GPT-5.6 Sol на 7 пунктов приходится на Terminal-Bench v4.0 (56% против 37%) и SWE-Atlas-QnA (62% против 54%), что частично компенсируется более низким баллом на DeepSWE (68% против 72%).
➤ На границе стоимости индекса кодирующего агента: при максимальных усилиях GPT-6 Astra стоит 7,09 доллара США за задачу, что примерно на 15 % больше, чем GPT-5,6 Sol (максимум), и дает более высокий балл на 7 пунктов. За задачу модель стоит примерно на 40% дешевле, чем Claude Fable 5.1 (максимум с резервным вариантом) и на ~30 % дешевле, чем Claude Opus 5 (максимум), при том же или более высоком балле. Экономическая эффективность Astra обусловлена повышением эффективности токенов: при максимальных усилиях она использует одну треть токенов GPT-5.6 Sol на задачу.
Каждое рассуждение GPT-6 Astra находится на границе индекса интеллекта и стоимости задачи: от минимального значения в 0,82 доллара США за задачу до максимального значения в 3,26 доллара США. Против Claude Fable 5.1 (максимум с резервным вариантом) Astra соответствует результату при ~40% стоимости задания.
GPT-6 Astra определяет границу Парето для индекса интеллекта и количества токенов вывода на задачу. Каждое усилие рассуждения от низкого до максимального находится на границе, а при максимальном усилии Astra использует около трети выходных жетонов Claude Fable 5.1 (максимум с запасным вариантом) для получения того же результата.
GPT-6 Astra находится на границе Парето для индекса кодирующего агента и стоимости за задачу. При максимальных усилиях это стоит 7,09 доллара за задачу, что примерно на 15 % больше, чем у GPT-5.6 Sol (максимум) для оценки на 7 пунктов выше, и примерно на 40 % меньше, чем для Claude Fable 5.1 (максимум с резервным вариантом) в Claude Code для той же оценки.
В GPT-6 Astra наблюдается значительный скачок во всеведении АА, вызванный значительным снижением частоты галлюцинаций с 92% до 51% при максимальном усилии, а также скромным увеличением точности.
GPT-6 Astra набирает примерно 90 баллов Эло выше GPT-5,6 Sol в AA-Briefcase, нашей передовой долгосрочной оценке научной работы. Astra отмечает значительный рост как оценок по критериям, так и Elo аналитического качества по сравнению со своей предшественницей, но снижение Elo качества презентации, где GPT-5,6 Sol (макс.) по-прежнему лидирует среди всех моделей.
GPT-6 Astra лидирует AutomationBench-AA, нашей реализации эталонного теста бизнес-процессов Zapier, с показателем 69 %, опережая Grok 4.6 (67 %), GLM-5.3 (62 %) и GPT-5.6 Sol (60 %).
Разбивка отдельных оценок в Индексе искусственного анализа интеллекта.