Muse Glimmer: результаты тестов и сравнительный анализ
Легковесная архитектура от Meta: тесты скорости и точности в сценариях встроенных ассистентов.
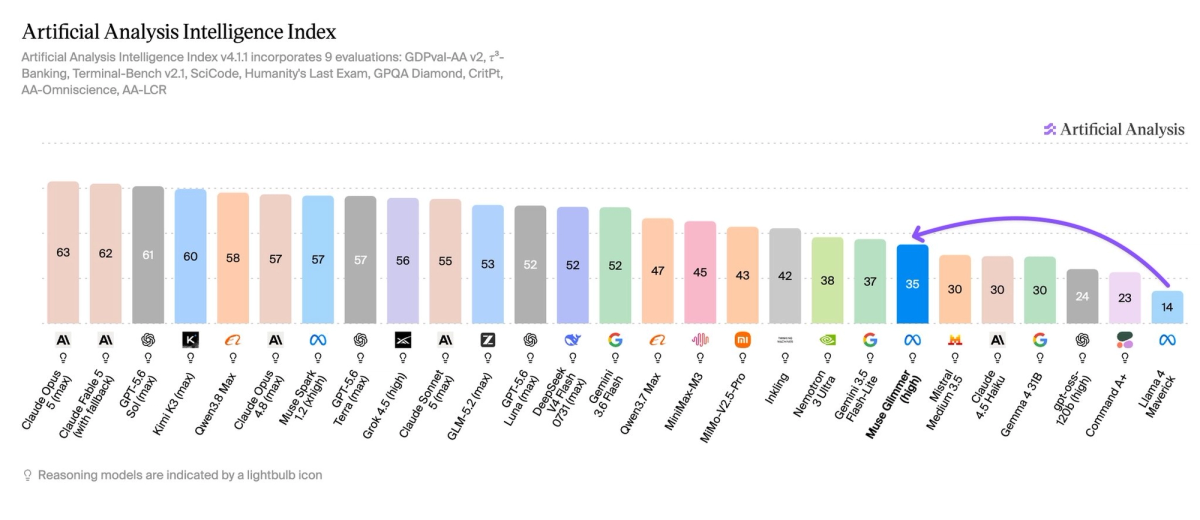
Meta возвращается к открытым весам: Muse Glimmer, ее первый выпуск с открытыми весами после Llama 4, набрал 35 баллов по индексу искусственного анализа интеллекта. Это модель с 30B параметрами и первая модель Meta, выпущенная под Apache 2.0.
Muse Glimmer (высокая) появляется через 16 месяцев после Llama 4, набрав на 21 очко больше Llama 4 Maverick (14), последнего релиза Meta в открытых весах. Он находится рядом с Kimi K2.5 (Reasoning, 36) и сразу за Qwen3.6 27B (Reasoning, 38) и Ling 3.0 Flash (38) и образует двухуровневую линейку Meta вместе с фирменным флагманом Muse Spark 1.2 (xhigh, 57). Общий доступ к мета с нами перед публичным выпуском для сравнительного анализа.
Ключевые выводы
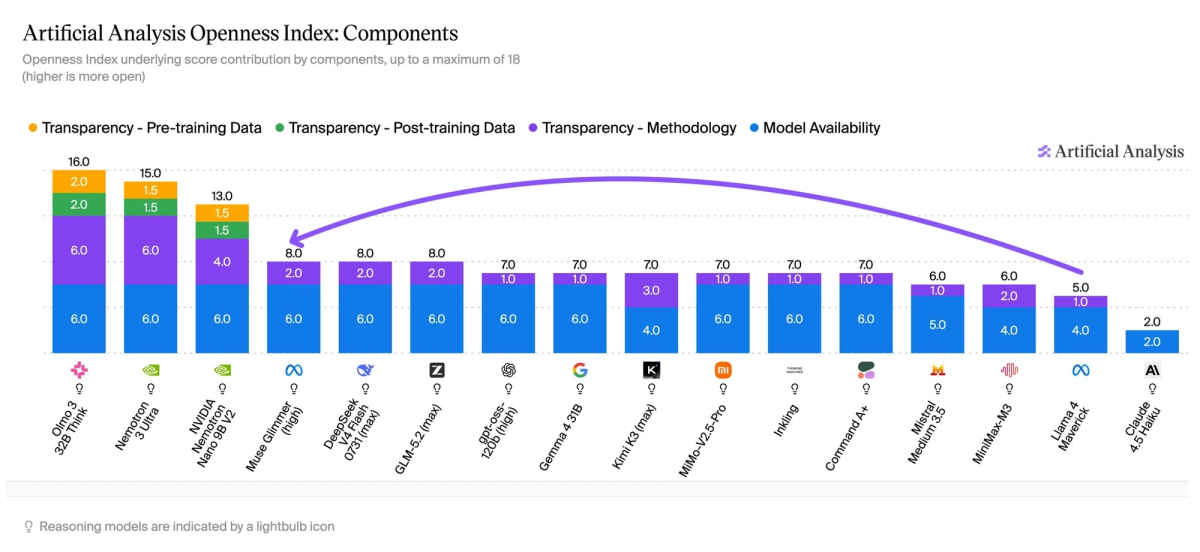
➤ Линия открытых весов Meta вернулась под самой разрешительной лицензией: все предыдущие открытые версии Meta поставлялись под лицензией Llama; Muse Glimmer использует Apache 2.0, практически не налагая ограничений на коммерческое использование или производные версии. Мы оценили первоначальную версию на уровне 44 по индексу открытости искусственного анализа, нашему показателю доступности и прозрачности модели по весу модели, обучающим данным и другим факторам, что соответствует показателям DeepSeek V4 Flash (0731), GLM-5.2 и Ling 3.0 Flash и опережает большинство открытых моделей. Он также улучшает показатель открытости Llama 4 Maverick благодаря более либеральной лицензии и более подробному раскрытию методологии.
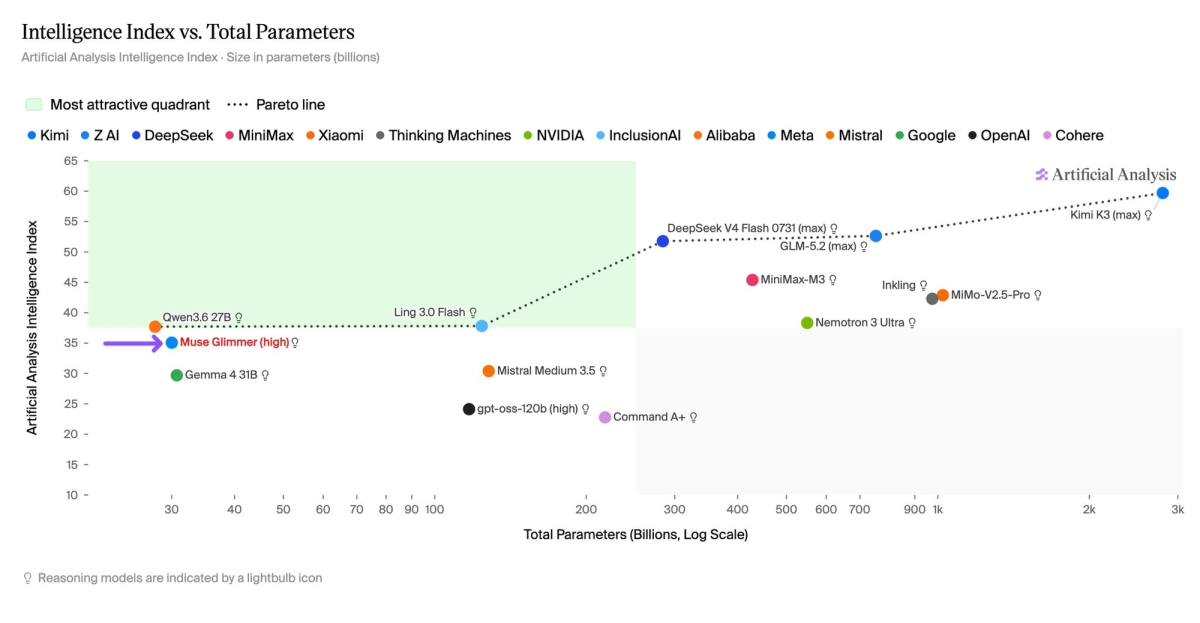
➤ Высокий интеллект по количеству параметров: при 30B параметрах Muse Glimmer набирает на 5 очков больше, чем Gemma 4 31B (Рассуждение, 30) при том же размере, и эффективно соответствует общему параметру 1T Кими K2.5 (Рассуждение, 36) с в 33 раза меньшим количеством параметров. Qwen3.6 27B (Рассуждение, 38) остается впереди на границе интеллекта и параметров при немного меньшем размере.
➤ Достаточно маленькая, чтобы самостоятельно размещаться на одном графическом процессоре, даже в полном контексте: Muse Glimmer — это модель с плотностью памяти 30 байт (включая видеокодер ~1,8 байт, набравший 74% в тесте визуального мышления MMMU-Pro) с весом ~60 ГБ в BF16 и ~18 ГБ в 4-битном режиме. Он оснащен механизмом гибридного внимания с тремя уровнями скользящего окна для каждого глобального уровня, который удерживает использование кэш-памяти KV на уровне ~ 1,8 ГБ (минимум) в контексте предварительного расширения 128 КБ. Это означает, что модель может работать в полном контексте на одном H100 с точностью BF16 или на MacBook с более высокими характеристиками или RTX 5090 с 4-битной скоростью, с большим пространством для передышки, если видеокодер не требуется.
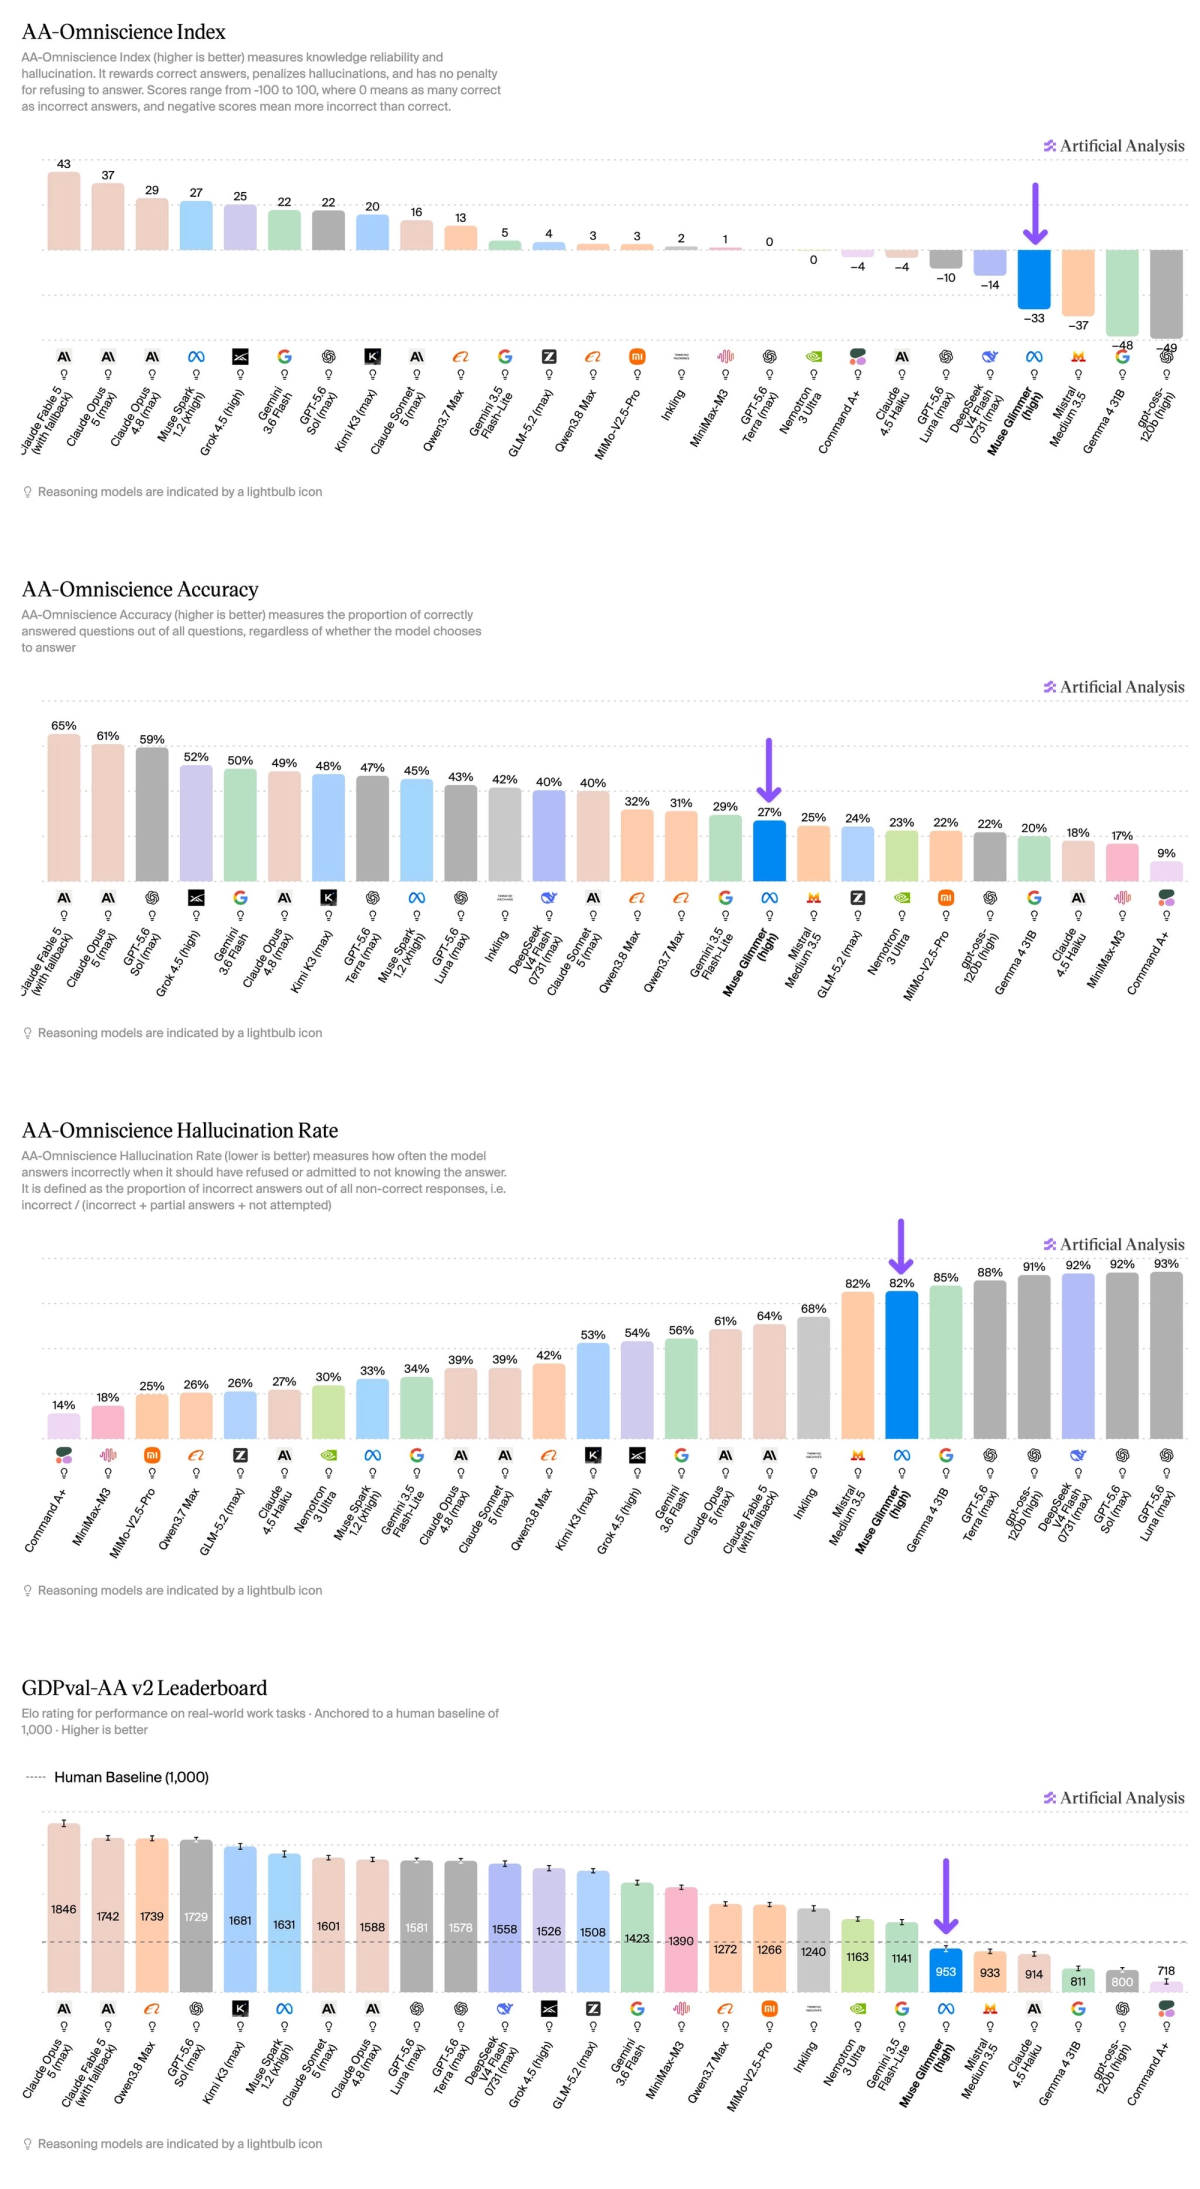
➤ Агентская информационная работа является его слабостью по сравнению с его размерным классом: Muse Glimmer набирает 953 Эло по GDPval-AA v2, что ниже базового уровня в 1000 человек и уступает другим моделям на своем уровне интеллекта, включая Qwen3.6 27B аналогичного размера (Рассуждение, 1141) и Gemini 3.5 Flash-Lite (1141). GDPval-AA v2 — это наш ведущий показатель производительности агентов, измеряющий модели реалистичных задач интеллектуального труда в агентном цикле с помощью нашего эталонного программного обеспечения Stirrup. Калибровка знаний следует той же схеме: его индекс всеведения АА -33 низок для его уровня интеллекта, что обусловлено 82% уровнем галлюцинаций (Qwen3.6 27B: 49%), а не точностью, где он соответствует своим аналогам. Использование агентских инструментов является исключением: Muse Glimmer набрала 24% в Tau3-Banking, опередив Gemini 3.5 Flash-Lite (18%) и Qwen3.6 27B (17%), одних из лучших в своем классе.
➤ Подробности модели: Muse Glimmer — это модель с плотностью 30 байт и контекстным окном токена 128 КБ (плюс расширение), выпущенная под Apache 2.0. На момент выпуска Meta не поддерживает модель в своем API; цены и скорость обслуживания зависят от сторонних поставщиков, а веса доступны на Hugging Face.
Мы оценили первоначальную версию Muse Glimmer на уровне 44 по индексу открытости искусственного анализа, показателю доступности и прозрачности модели по весам модели, обучающим данным и другим факторам. Это ставит модель на один уровень с DeepSeek V4 Flash (версия 0731), GLM-5.2 и Ling 3.0 Flash, опережая большинство открытых моделей. Он также улучшает показатель открытости Llama 4 Maverick благодаря более либеральной лицензии и более подробному раскрытию методологии.
При параметрах 30B Muse Glimmer находится недалеко от границы интеллекта и параметров для моделей с открытыми весами: на 5 пунктов выше Gemma 4 31B (Рассуждение) при том же размере, что эффективно соответствует Kimi K2.5 (Рассуждение) с в 33 раза меньшим общим параметром и сразу за Qwen3.6 27B (Рассуждение), лидером по эффективности параметров в этом классе.
Отставания Muse Glimmer от своего класса концентрируются в агентских оценках: 953 Эло на GDPval-AA v2 против 1141 у Qwen3.6 27B (Рассуждение), 1141 у Gemini 3.5 Flash-Lite и 1004 у Kimi K2.5 (Рассуждение), при этом Terminal-Bench v2.1 (52%) также отстает от Qwen3.6 27B. (61%). Разрыв галлюцинаций следующий: 82% у AA-Omniscience против 49% у Qwen3.6 27B и 34% у Flash-Lite (чем меньше, тем лучше). Его близнец Gemma 4 31B (Reasoning) по размеру хуже, чем Muse Glimmer по всем этим показателям. Исключением является использование агентских инструментов: Muse Glimmer набрала высокие баллы по Tau3-Banking (24%), опередив Gemini 3.5 Flash-Lite (18%) и Qwen3.6 27B (17%).
Полная разбивка отдельных оценок в Индексе искусственного анализа интеллекта