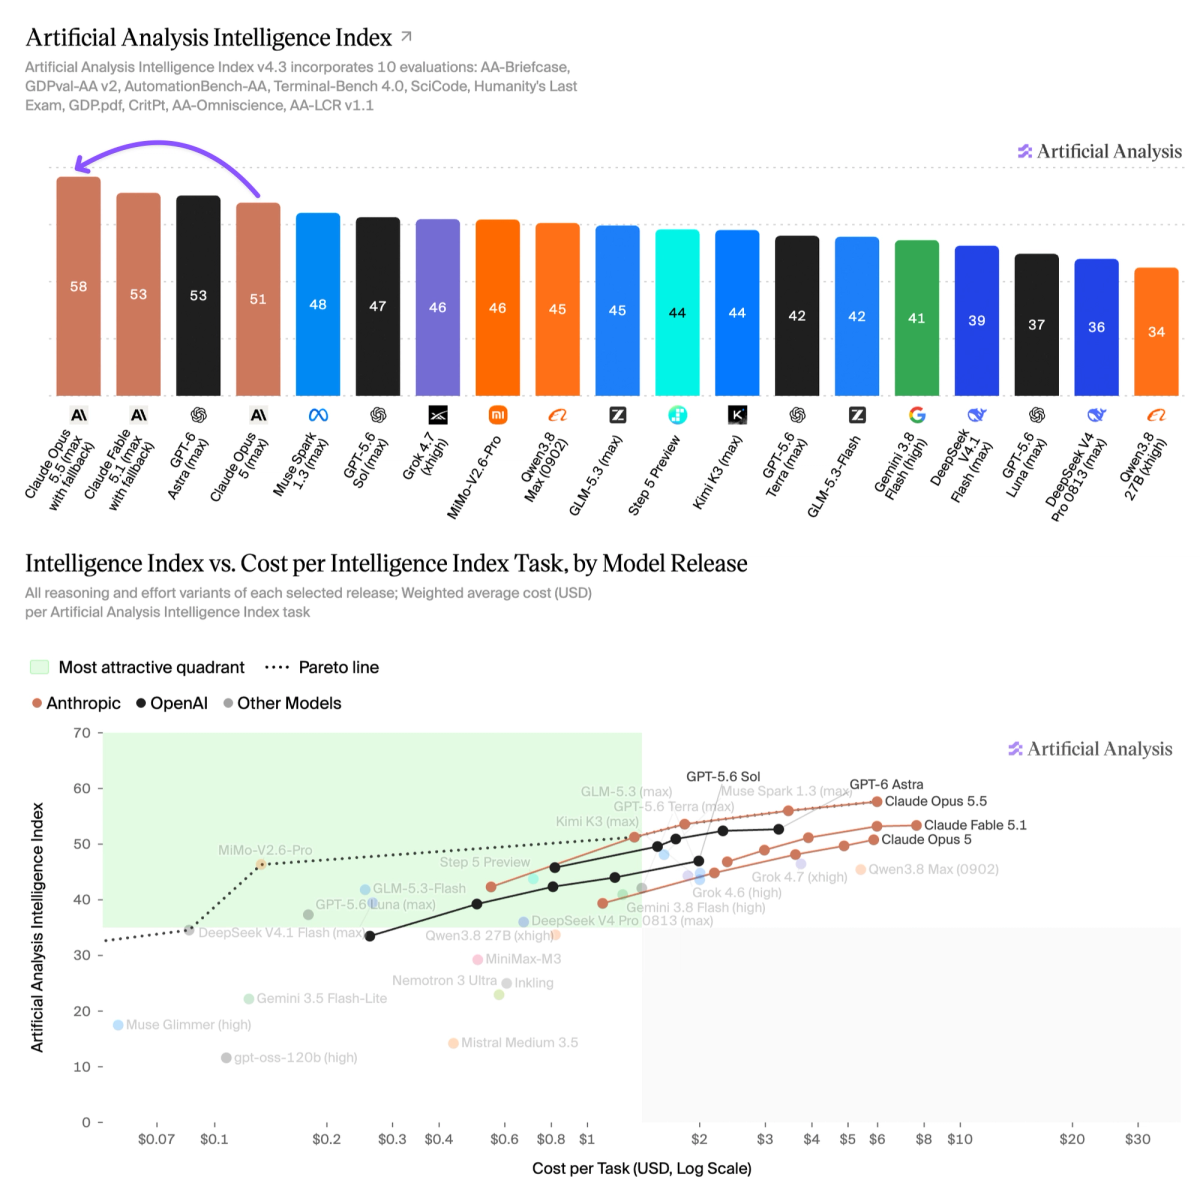
Claude Opus 5.5 возглавил мировой рейтинг в Индексе интеллекта
Абсолютный лидер мирового тестирования: максимальные показатели в сложных рассуждениях, математике и архитектуре ПО.
Claude Opus 5.5 выводит Anthropic на паритет с GPT-6 Astra по таким оценкам, как Terminal-Bench 4.0 и AutomationBench-AA, одновременно расширяя лидерство Anthropic в работе с агентскими знаниями.
При максимальном усилии он набирает 58 баллов по индексу интеллекта искусственного анализа, это самый высокий балл, который мы измеряем несколькими баллами. Anthropic снизила цену Opus до 4/20 долларов США за 1 миллион токенов ввода/вывода (Opus 5: 5 долларов США/25 долларов США), а чтение кэша — с 0,50 до 0,20 доллара США.
Ключевые выводы
➤ Стабильно высокая производительность, с лучшими оценками в шести из десяти оценок Индекса интеллекта: «Последний экзамен человечества» 61,4% (предыдущий лучший результат 59,1%, Claude Fable 5.1), SciCode 66,9% (63,1%, Fable 5.1), GDPval-AA v2.1, AA-Briefcase v1.1, AA-Omniscience и АвтоматизацияБенч-АА. На Terminal-Bench 4.0 он набирает 59,6%, что соответствует лидеру GPT-6 Astra (xhigh) и +11 баллов к Opus 5. Остается позади по CritPt, AA-LCR и GDP.pdf.
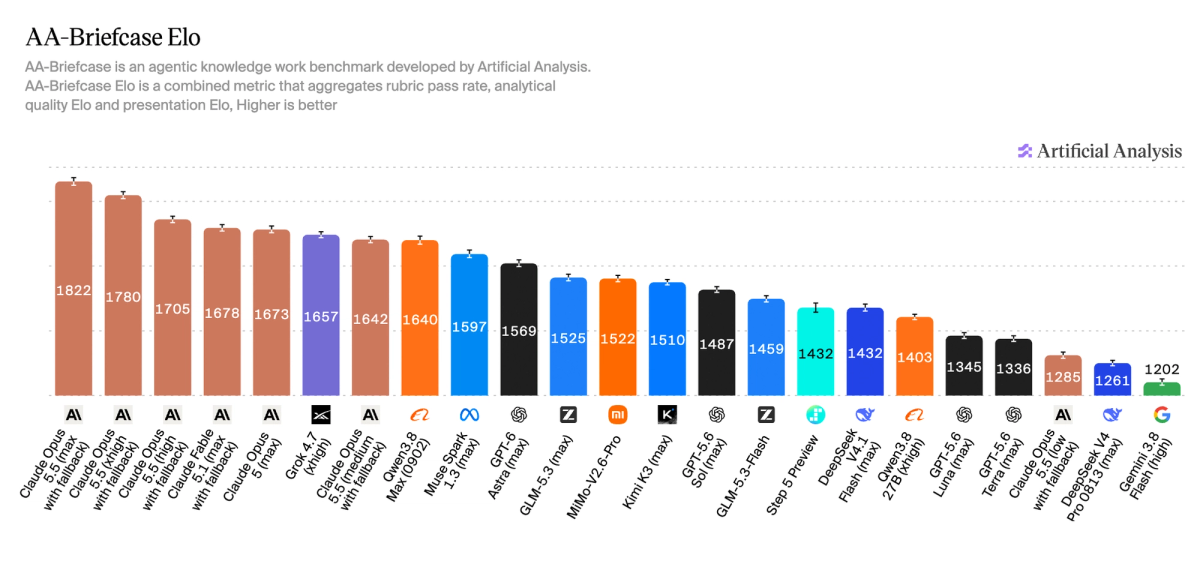
➤ Лидирует в агентской информационной работе: в AA-Briefcase, нашей частной передовой оценке информационной работы, он достигает Эло 1822. Это на +143 по сравнению с Fable 5.1, опережая как по аналитическому качеству, так и по представлению, и это первый раз, когда Anthropic достиг качества представления, превосходящего GPT-5.6 Sol. Эта оценка проверяет, могут ли модели давать точные и хорошо представленные профессиональные результаты с использованием нашего эталонного агента с открытым исходным кодом Stirrup.
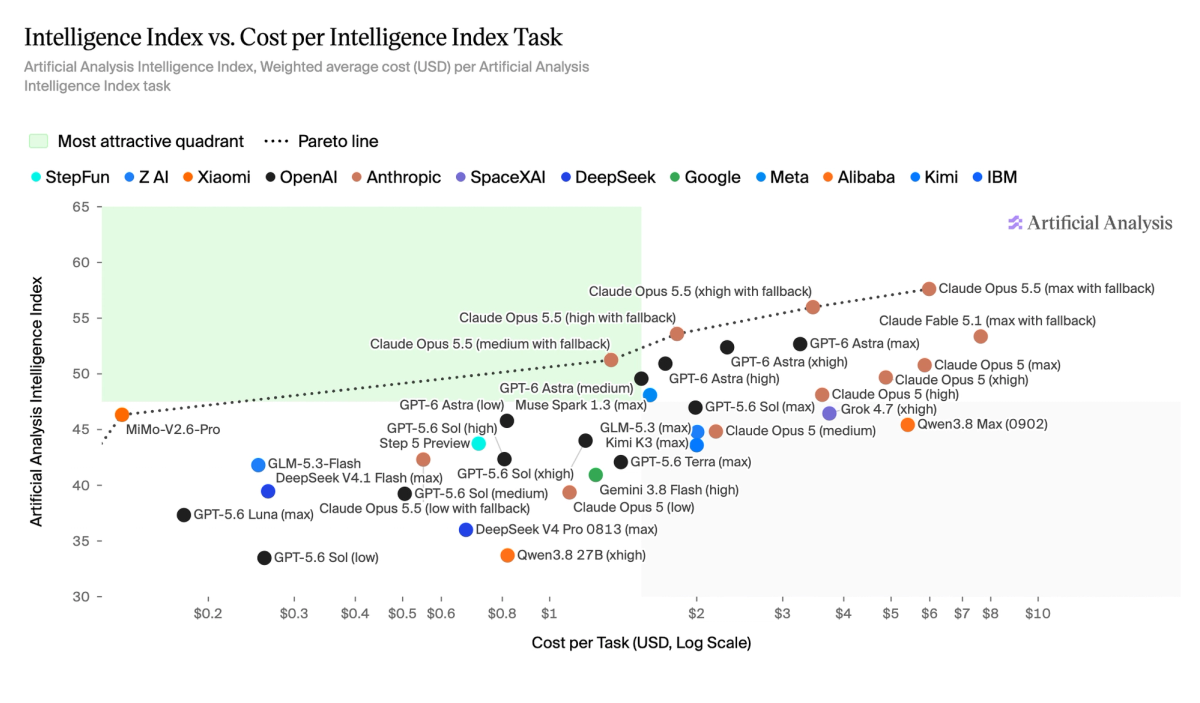
➤ Уровень Opus 5 по стоимости за задачу, несмотря на 1,6-кратное увеличение выходных жетонов: Opus 5.5 (максимум) использует ~ 119 тысяч выходных жетонов на задачу Индекса интеллекта, против ~ 73 тысяч для Opus 5 (максимум), ~ 78 тысяч для Fable 5.1 (максимум) и ~ 27 тысяч для GPT-6 Astra (максимум)
➤ Четыре из пяти уровней усилий находятся на границе интеллекта и стоимости задачи: Opus 5.5 max, xhigh, high и medium находятся на границе Парето, стоят меньше или превосходят другие модели с рейтингом 50+ (GPT-6 Astra, Claude Fable 5.1 и Claude Opus 5).
Другие детали модели
➤ Контекстное окно: контекст на 1 миллион токенов с поддержкой ввода изображений и текста, без изменений по сравнению с Opus 5.
➤ Цена: 4/20 долларов США за 1 миллион токенов ввода/вывода, что на 20 % меньше, чем 5/25 долларов США для Opus 5. Кэш записывает 5 долларов США за 1 миллион токенов с 5-минутным TTL, по сравнению с 6,25 доллара США. Чтение кэша было дополнительно снижено до 0,20 доллара за 1 миллион токенов, что на 60% меньше, чем 0,50 доллара в Opus 5. Это скидка 95 % по сравнению с ценой на некэшированный ввод по сравнению с 90 % на предыдущих моделях Opus.
➤ Настройки усилия: пять настроек усилия (низкое, среднее, высокое, высокое и максимальное). Оценки индекса интеллекта проводились на всех пяти с включенным резервным вариантом Anthropic по умолчанию.
Четыре из пяти уровней усилий Claude Opus 5.5 находятся на границе интеллекта и стоимости за задачу: Opus 5.5 max, xhigh, high и medium находятся на границе Парето, стоят меньше или превосходят другие модели, набравшие 50+.
Клод Опус 5.5 (макс.) — лучший специалист в области агентной информационной работы. Он лидирует AA-Briefcase v1.1 с 1822 Эло (+143 к Fable 5.1) и GDPval-AA v2.1 с 1846 Эло (+111 к Claude Fable 5.1, +138 к Claude Opus 5). В рейтинге AA-Briefcase он лидирует по аналитическому качеству и подоценкам презентации и уступает Fable 5.1 по критериям оценки на основе рубрик.