Opus 5: интеллект уровня Fable 5 при существенно меньшей стоимости за задачу
Сравнительный анализ затрат: почему Opus 5 становится более экономичным выбором для глубоких корпоративных задач.

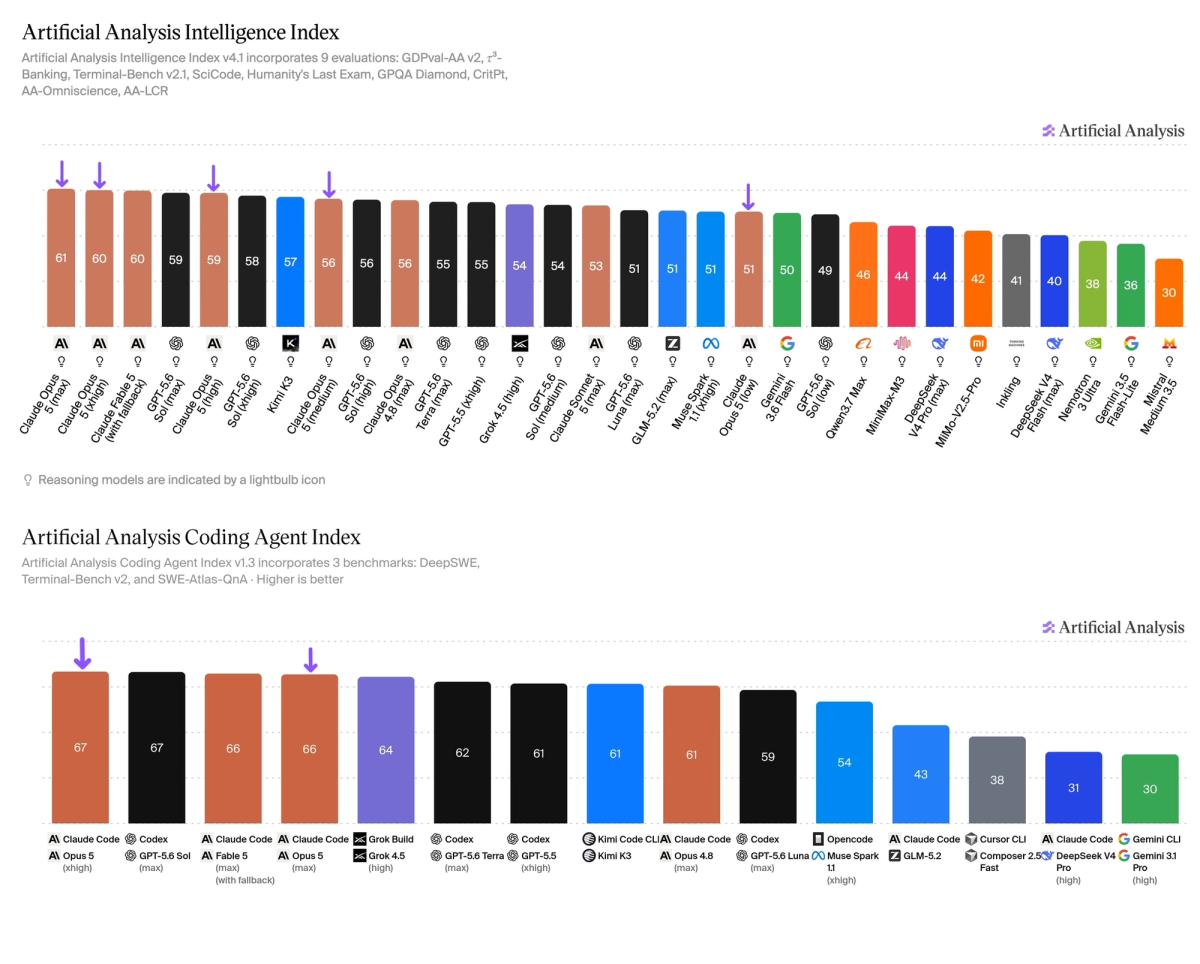
Claude Opus 5 — едва ли не самая интеллектуальная модель в индексе искусственного анализа интеллекта, предлагая сопоставимый интеллект с Fable 5 при сниженной на 26 % цене за задачу.
Мы поддержали Anthropic, чтобы оценить Claude Opus 5 перед выпуском: на данный момент он установил самые высокие оценки GDPval-AA v2 и AA-Briefcase. Opus 5 (макс.) набирает 61 балл по индексу искусственного интеллекта анализа, фактически равен Claude Fable 5 (макс. 60) и опережает GPT-5.6 Sol (макс. 59), Kimi K3 (57) и Claude Opus 4.8 (макс. 56).
Ключевые выводы
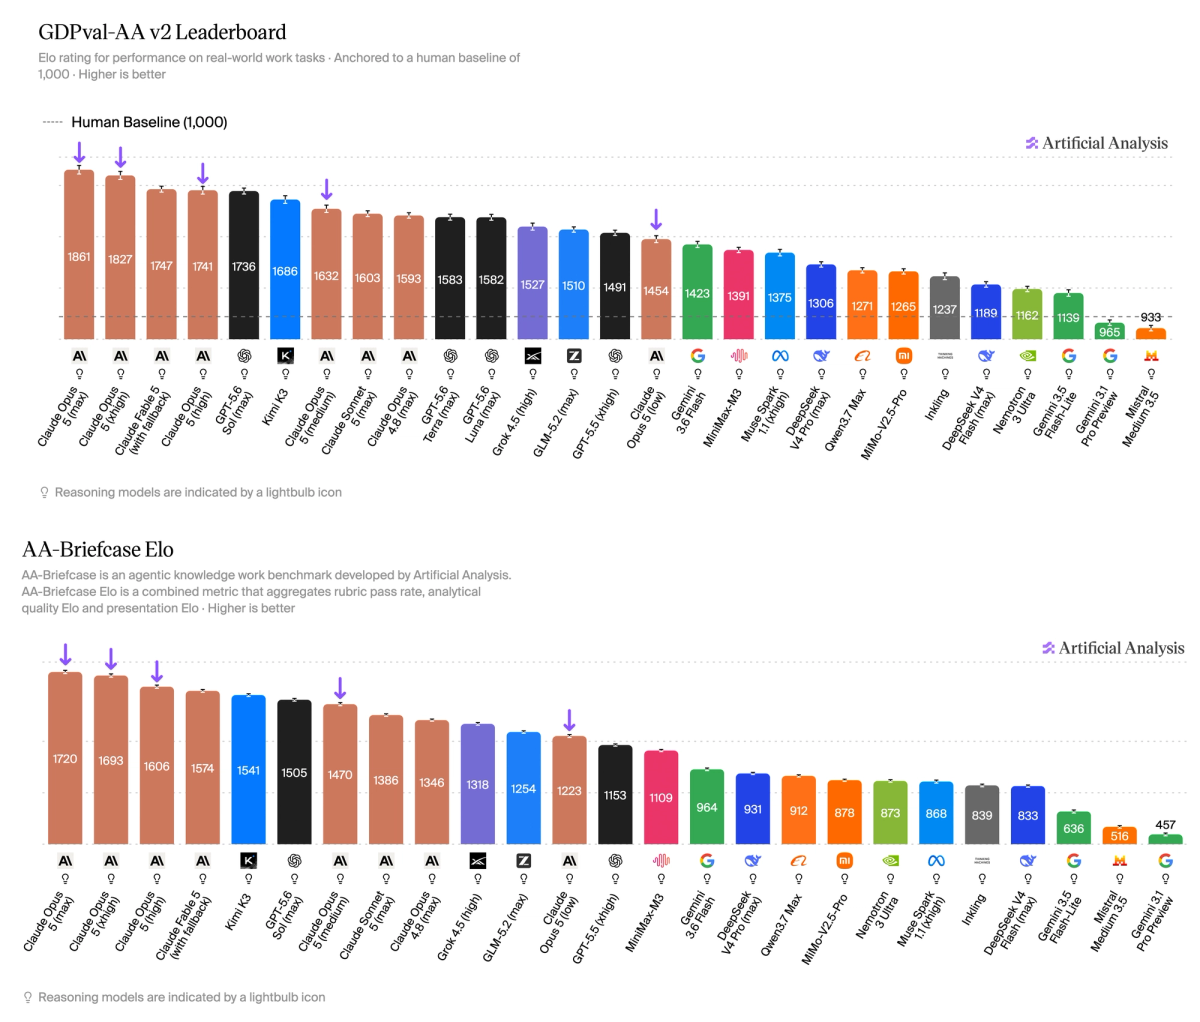
➤ Новый лидер в области агентурных знаний: Claude Opus 5 (макс.) набирает 1861 Эло на GDPval-AA v2, на >100 баллов опережая Claude Fable 5 и GPT-5.6 Sol (макс.). В AA-Briefcase, нашем эталоне работы с агентскими знаниями, он набирает 1720 Эло, что на +146 опережает Fable 5. Эти тесты проверяют способность моделей производить точные и хорошо представленные профессиональные результаты с использованием нашего эталонного агента с открытым исходным кодом Stirrup.
➤ Совместное первое место в индексе кодирующего агента: Claude Opus 5 (xhigh) с Claude Code лидирует в индексе кодирования искусственного анализа, включая наивысший балл по SWE-Atlas-QnA
➤ Frontier Intelligence с пониженной стоимостью: Claude Opus 5 (максимум) стоит в среднем 2,03 доллара США за задачу индекса интеллекта, ниже Claude Fable 5 (с резервным вариантом) — 2,75 доллара США, но все же выше Claude Opus 4,8 (максимум) — 1,80 доллара США и Claude Sonnet 5 (максимум) — 1,53 доллара США. Однако при высоких и высоких умственных усилиях Opus 5 может превзойти Opus 4.8 и Claude Sonnet 5 при более низких затратах на задачу.
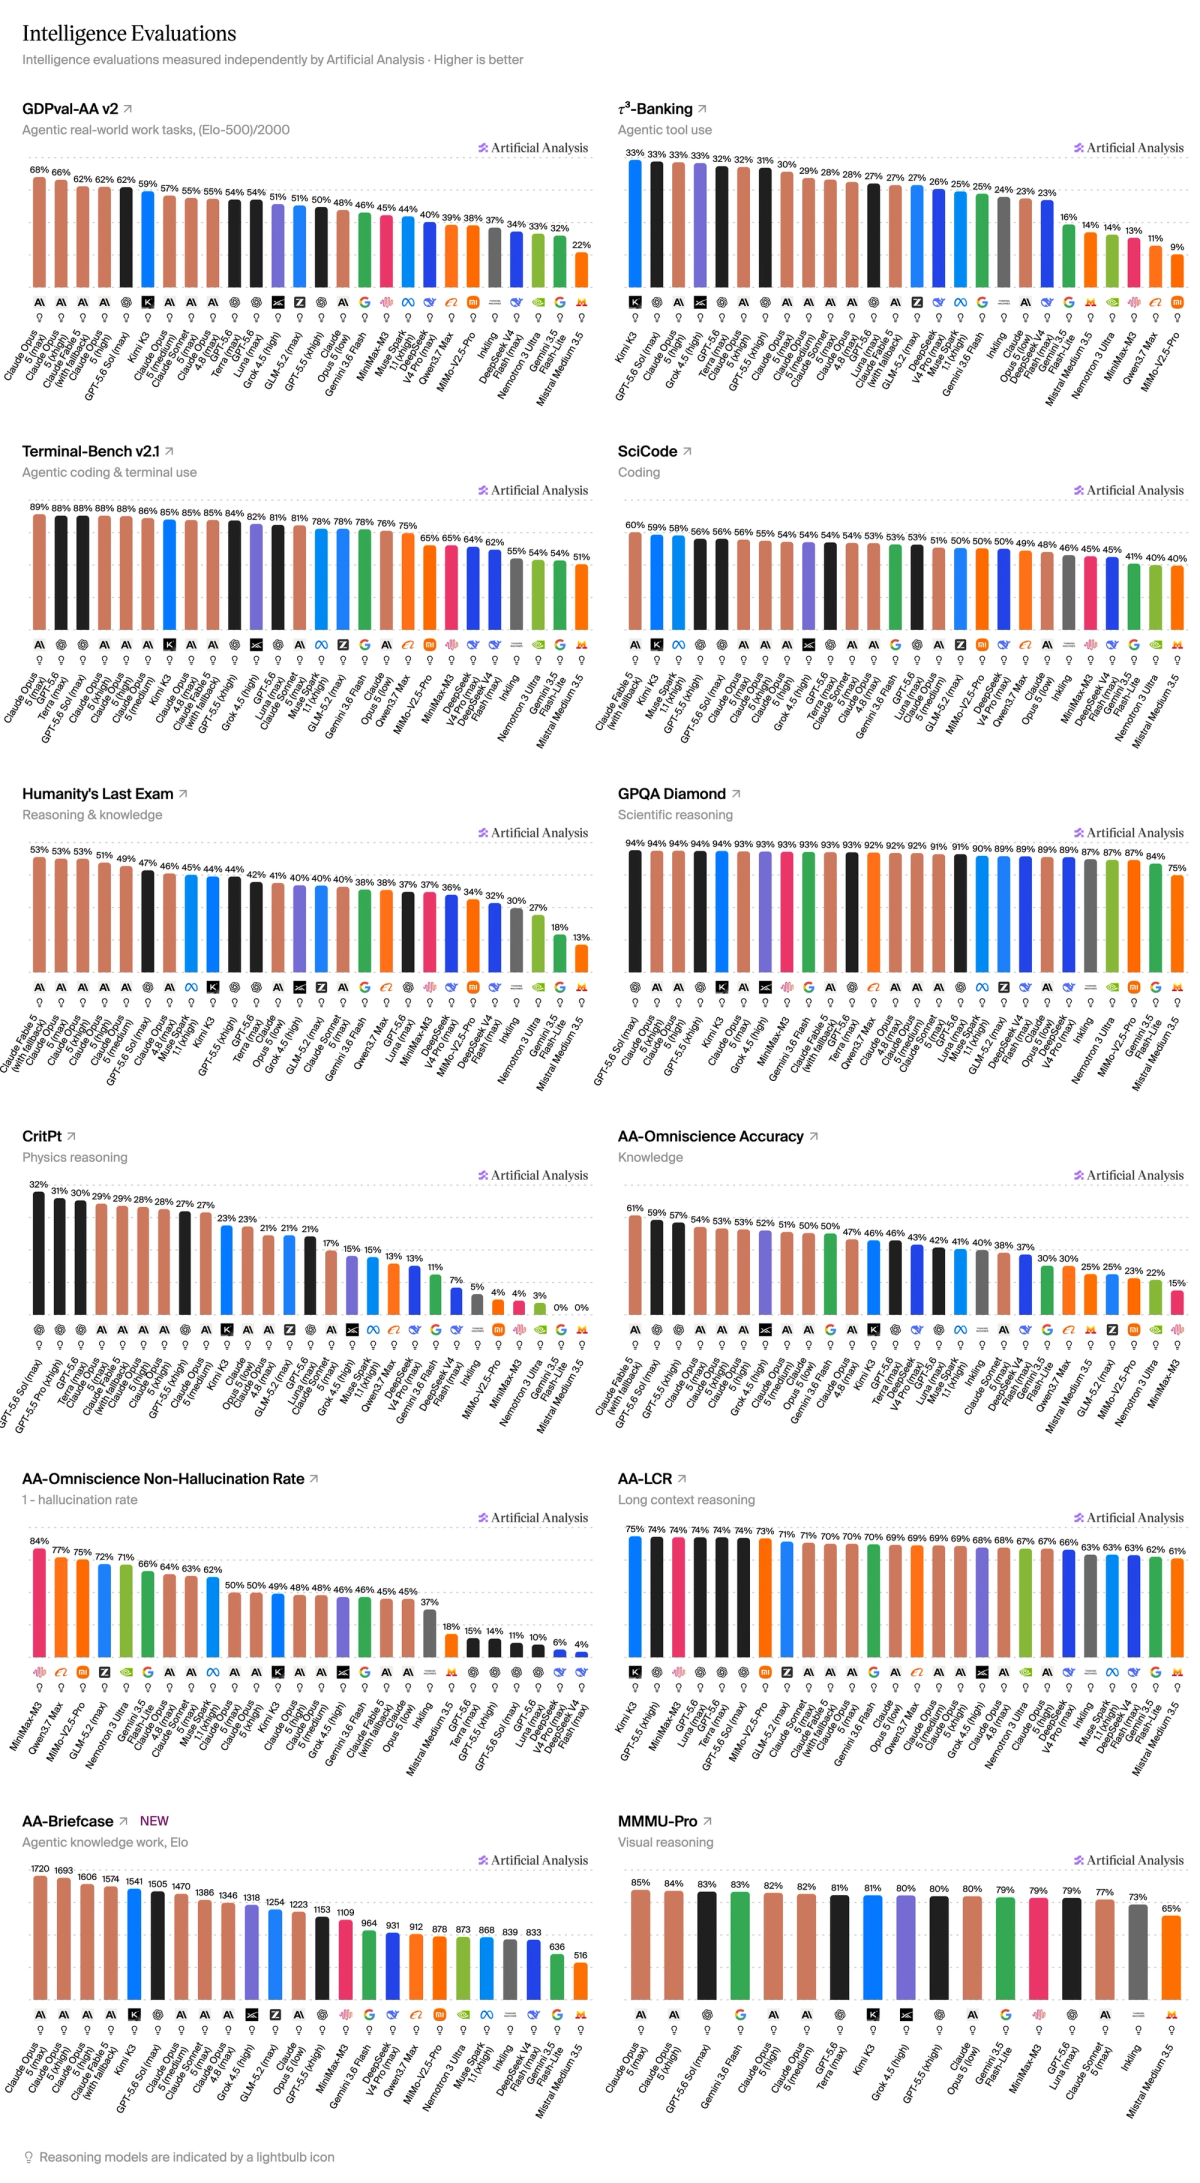
➤ Использование агентского терминала Frontier: 89% на Terminal-Bench v2.1 при максимальных усилиях, что примерно соответствует лидеру GPT-5.6 Sol (xhigh).
➤ Превосходство в научном рассуждении: наряду с лучшими агентскими способностями, Клод Опус 5 набирает 53% на «Последнем экзамене человечества» в соответствии с Fable 5; в CritPt, передовой физической оценке, разработанной исследователями Аргонны и UIUC, она также соответствует Fable 5, но уступает GPT-5.6 Sol, GPT-5.5 Pro и GPT-5.6 Terra.
➤ Фактические знания по-прежнему отстают от Басни 5: Как и ожидалось, исходя из размеров моделей, Опус 5 по-прежнему имеет более низкие фактические знания о Всеведении АА, чем Басня 5. Он улучшает на +7 пунктов Точность Всеведения АА по сравнению с Опусом 4.8, но чаще отвечает в случае неопределенности - уровень галлюцинаций увеличивается на +14 баллов до 50%.
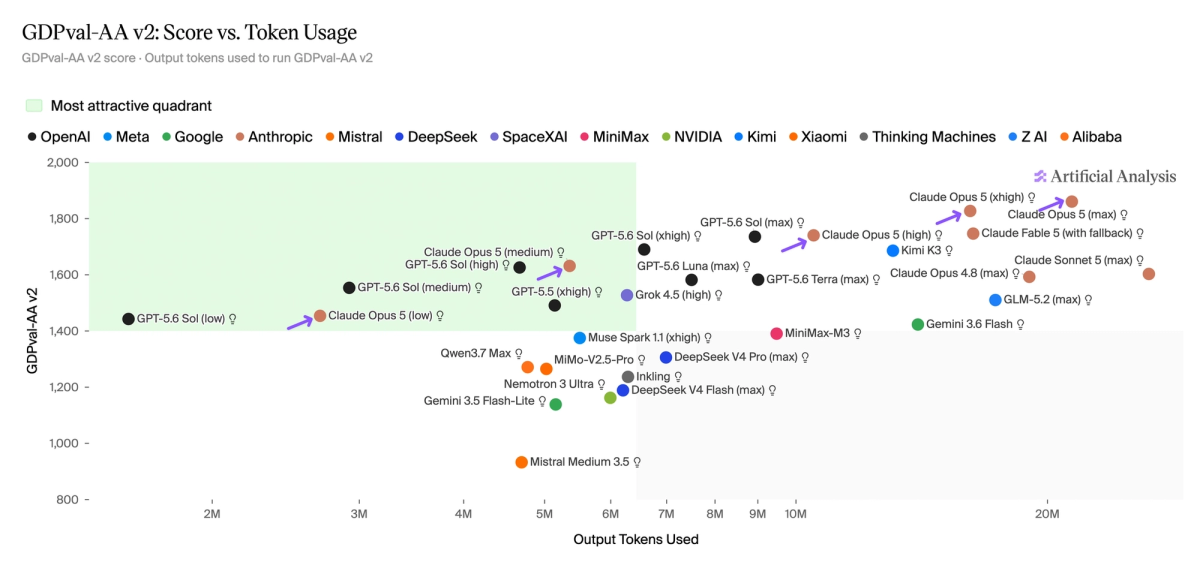
➤ Повышение эффективности, но только на границе Парето интеллекта и стоимости задачи на высоких уровнях интеллекта: Opus 5 превосходит Fable 5 при меньших затратах, но при более низких уровнях усилий он находится сразу за семейством GPT-5.6 на границе интеллекта и стоимости задачи.
Другие детали модели
➤ Контекстное окно: 1 миллион токенов (эквивалент Opus 4.8)
➤ Цены: как и в случае с недавними запусками Opus, токены стоят 5/25 долларов США за миллион токенов ввода/вывода; Цена кэша остается на уровне 25 % за запись в кеш (6,25 доллара США за миллион токенов) с 5 минутным временем жизни и 90 % скидкой за попадания в кеш (0,50 доллара США за миллион токенов).
➤ Пять настроек усилия (низкое, среднее, высокое, xвысокое, максимальное) и поддержка резервного режима на стороне сервера, как в Fable 5. Оценки индекса интеллекта проводились с включенным резервным режимом Opus 4.8.
Клод Опус 5 (макс.) — новый лидер как на GDPval-AA v2 (1861 Эло, +114 к Клоду Fable 5), так и на AA-Портфеле (1720 Эло, +146 к Fable 5). Эти тесты проверяют способность моделей создавать точные и хорошо представленные профессиональные результаты с использованием нашего эталонного агента с открытым исходным кодом Stirrup.
Настройки усилий Claude Opus 5 охватывают широкий спектр компромиссов между использованием токенов и производительностью. В GDPval-AA v2 уровни усилий охватывают 407 баллов Эло, при этом использование выходных токенов варьируется примерно в 8 раз от низкого до максимального усилия. Как и в случае с GPT-5.6 Sol, это означает, что Opus 5 может использовать гораздо меньше или гораздо больше токенов для завершения оценки, чем модели из других лабораторий, в зависимости от настроек усилий.
Полная разбивка отдельных оценок в Индексе интеллекта искусственного анализа для Claude Opus 5 с максимальными усилиями.