Бенчмарки и детальный анализ Grok 4.7 от xAI
Замеры скорости генерации, пропускной способности и качества ответов Grok 4.7 в независимых тестах.
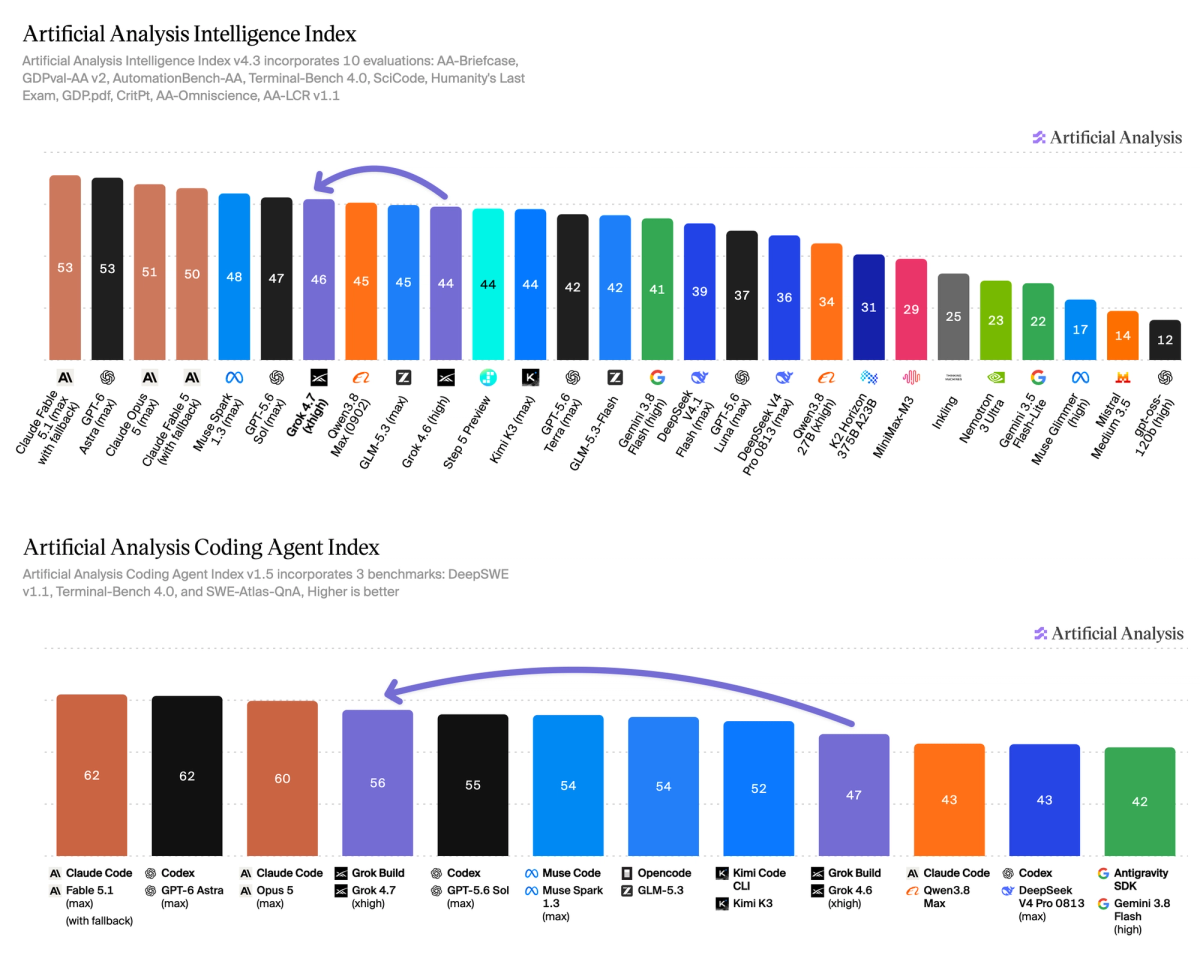
Грок 4,7 набирает +2 балла по сравнению с Гроком 4,6 по индексу интеллекта, демонстрируя высокие результаты при выполнении задач агентной работы с знаниями. Мы оценили новую модель с высоким уровнем рассуждения.
Ключевые выводы:
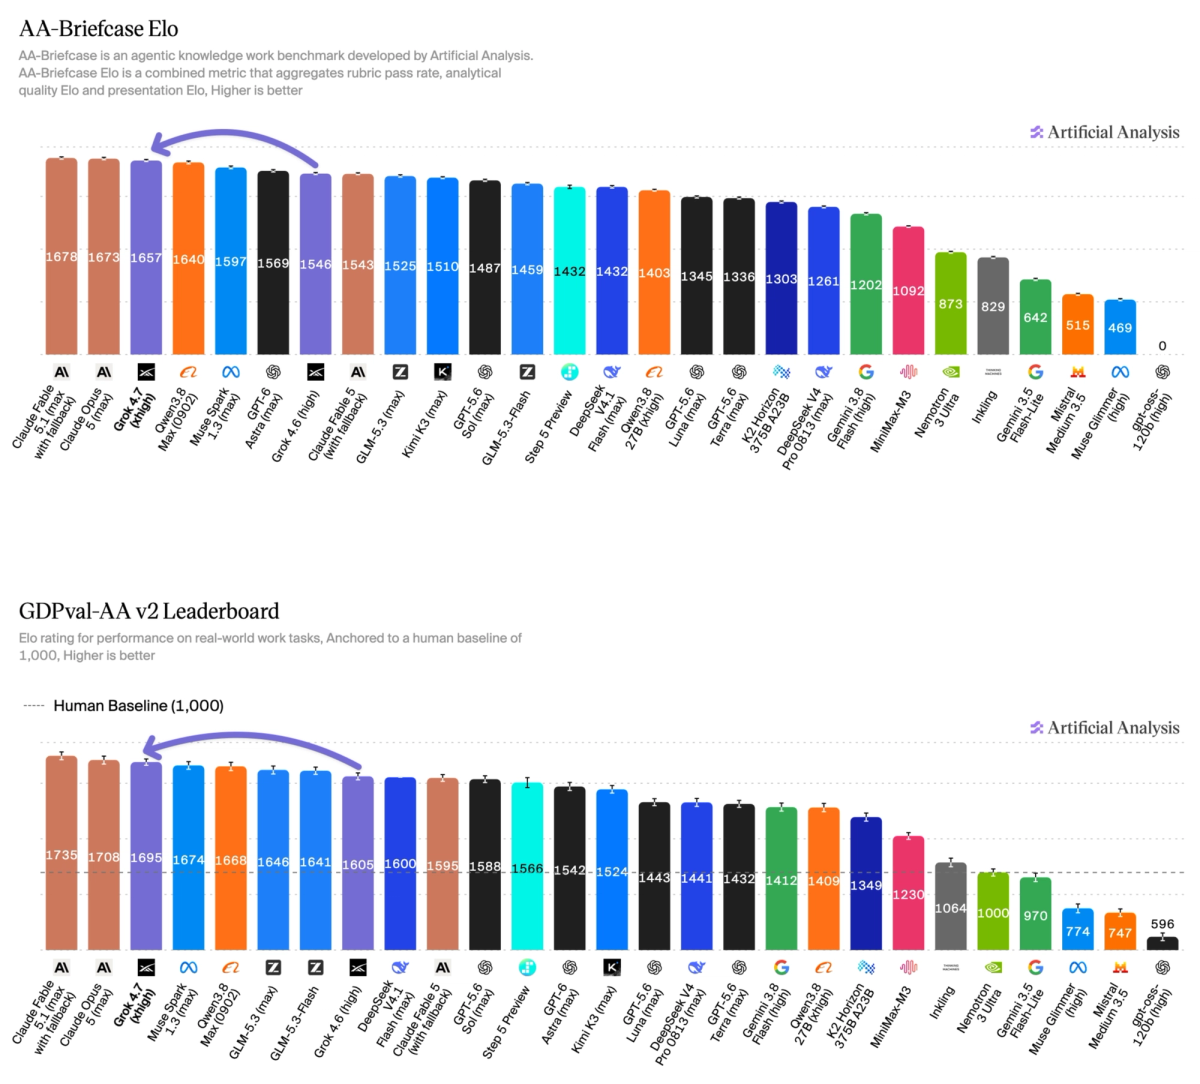
➤ Грок 4.7 выходит на передний план агентской информационной работы: Грок 4.7 получает +111 Эло по сравнению с Гроком 4.6 (высоким) в AA-Briefcase, нашем частном эталоне долгосрочной агентской информационной работы, набирая 1657 Эло и ставя его сразу после Клода Опуса 5 и Клода Фейбл 5.1 на переднем крае. По GDPval-AA он набирает 1695 Эло, +90 опережая Грока 4,6 (максимум).
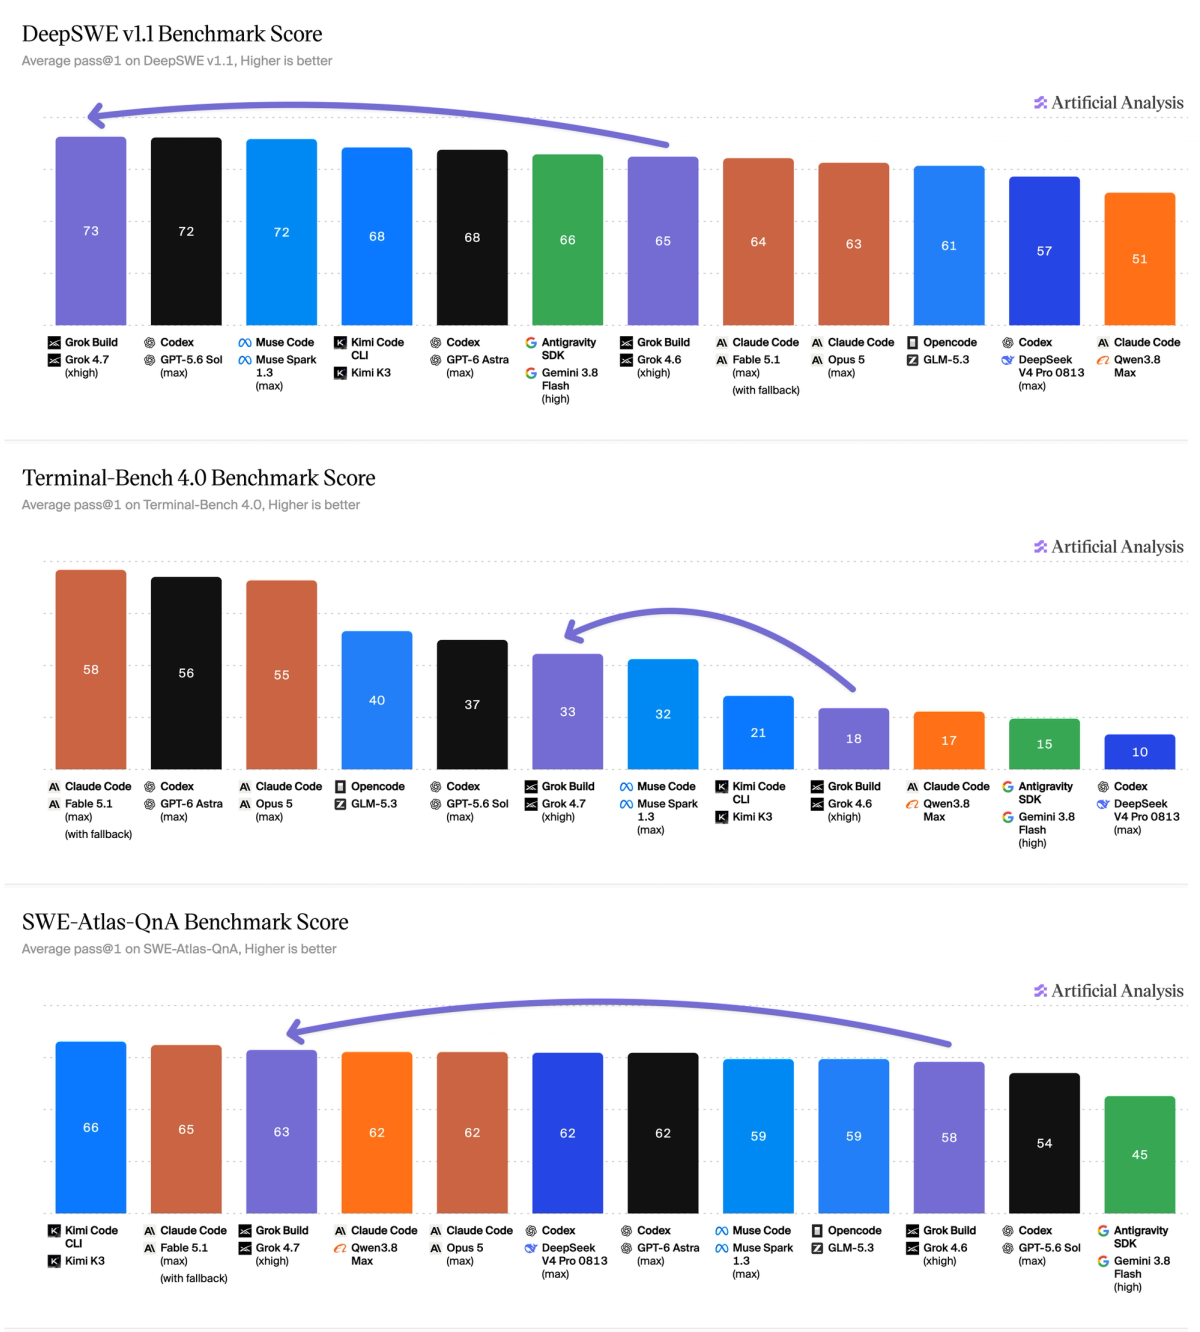
➤ Скачок в производительности агента кодирования: Grok 4,7 (xhigh) с Grok Build набрал 56 баллов в Индексе кодирующего агента искусственного анализа, что на +9 баллов больше, чем Grok 4,6 (xhigh). Среди моделей в родной обвязке Grok 4.7 + Grok Build теперь занимает 4-е место, уступая только Claude Fable 5.1, GPT-6 Astra и Claude Opus 5.
➤ Дополнительные изменения в производительности в других местах: помимо работы с агентскими знаниями, Grok 4.7 в целом соответствует Grok 4.6 (высокий) в других задачах индекса интеллекта. Он улучшается по сравнению с Terminal-Bench 4.0 (+4,5 п.п.) и GDP.pdf (+3,0 п.п.), с регрессией по AA-LCR (-3,7 п.п.) и AutomationBench-AA (-1,1 п.п.).
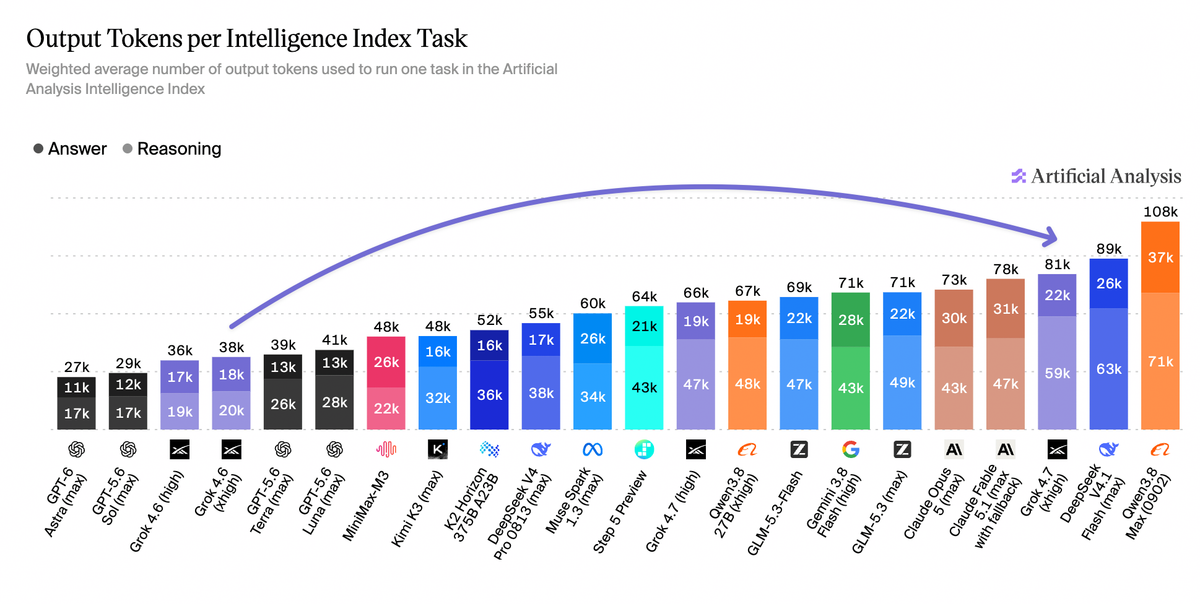
➤ Высокое использование токенов в задачах: преимущества Grok 4.7 связаны с более высоким использованием токенов. Grok 4.7 (xhigh) использует примерно 81 тыс. токенов вывода на задачу Intelligence Index по сравнению с 36 тыс. для Grok 4.6 (high) и 27 тыс. для GPT-6 Astra (max) — на 125% и 196% больше соответственно.
Другие детали модели:
➤ Контекстное окно с 500 тысячами токенов, без изменений по сравнению с Grok 4.6.
➤ Цена 2/6 долларов США за 1 миллион токенов ввода/вывода со скидкой на обращения к кешу до 0,50 доллара США за 1 миллион токенов, что соответствует Grok 4.6.
➤ Настраиваемое усилие рассуждения варьируется от низкого до высокого. В нашей оценке используется xhigh.
Grok 4.7 выходит на передовой уровень задач агентной работы с знаниями. В AA-Briefcase, который оценивает модели при выполнении реалистичных профессиональных рабочих задач, Grok 4,7 набирает 1657 баллов Эло, что на 111 больше, чем Grok 4,6 (высокий), и ставит его сразу после Claude Opus 5 и Claude Fable 5.1.
Улучшение Grok 4.7 обусловлено аналитическим качеством: он получил 1994 балла Эло за аналитическое качество и 1499 баллов за качество презентации по сравнению с 1690 и 1519 баллами соответственно для Grok 4.6 (высокий). AA-Briefcase также проверяет, соответствуют ли предоставленные материалы требованиям каждой задачи, от завершения анализа до получения запрошенных результатов.
По GDPval-AA Grok 4,7 набирает 1695 Эло по сравнению с 1605 для Grok 4,6 (высокий). Эти задачи требуют моделей для создания практических рабочих продуктов, таких как документы, электронные таблицы и слайды.
Grok Build с Grok 4.7 (xhigh) набрал 56 баллов в индексе кодирующего агента искусственного анализа по сравнению с 47 баллами с Grok 4.6 (xhigh).
Он улучшается по всем трем компонентам: DeepSWE v1.1 увеличивается с 65% до 73%, Terminal-Bench 4.0 с 18% до 33% и SWE-Atlas-QnA с 58% до 63%.
Эти результаты оценивают Grok с Grok Build, его собственным агентом кодирования. Они отделены от результатов индекса интеллекта, который стандартизирует оценочный инструментарий, используемый в разных моделях.
Преимущества Grok 4.7 связаны с более высоким использованием токенов. Grok 4.7 (xhigh) набирает 46 баллов по индексу интеллекта, используя 81 тысячу жетонов вывода на задачу, что более чем вдвое превышает 38 тысяч, используемых Grok 4.6 (xhigh). Для сравнения: 60 тысяч для Muse Spark 1.3 (максимум) и 27 тысяч для GPT-6 Astra (максимум).
Согласно нашим измерениям производительности, скорость вывода ответов Grok 4.7 составляет примерно 188 токенов в секунду для длинных запросов. Grok 4.7 тратил в среднем примерно 7,1 минуты на задачу индекса интеллекта.
У Грока 4.7 (xhigh) уровень галлюцинаций АА-всеведения ниже, чем у Грока 4.6 (высокого): 29% против 34%. Точность в целом не изменилась и составила 47% против 48%, а общий индекс всеведения АА улучшился с 30 до 32.
Полный анализ индекса интеллекта для Grok 4.7 (xhigh), а также Grok 4.6 (high) и других ведущих моделей.